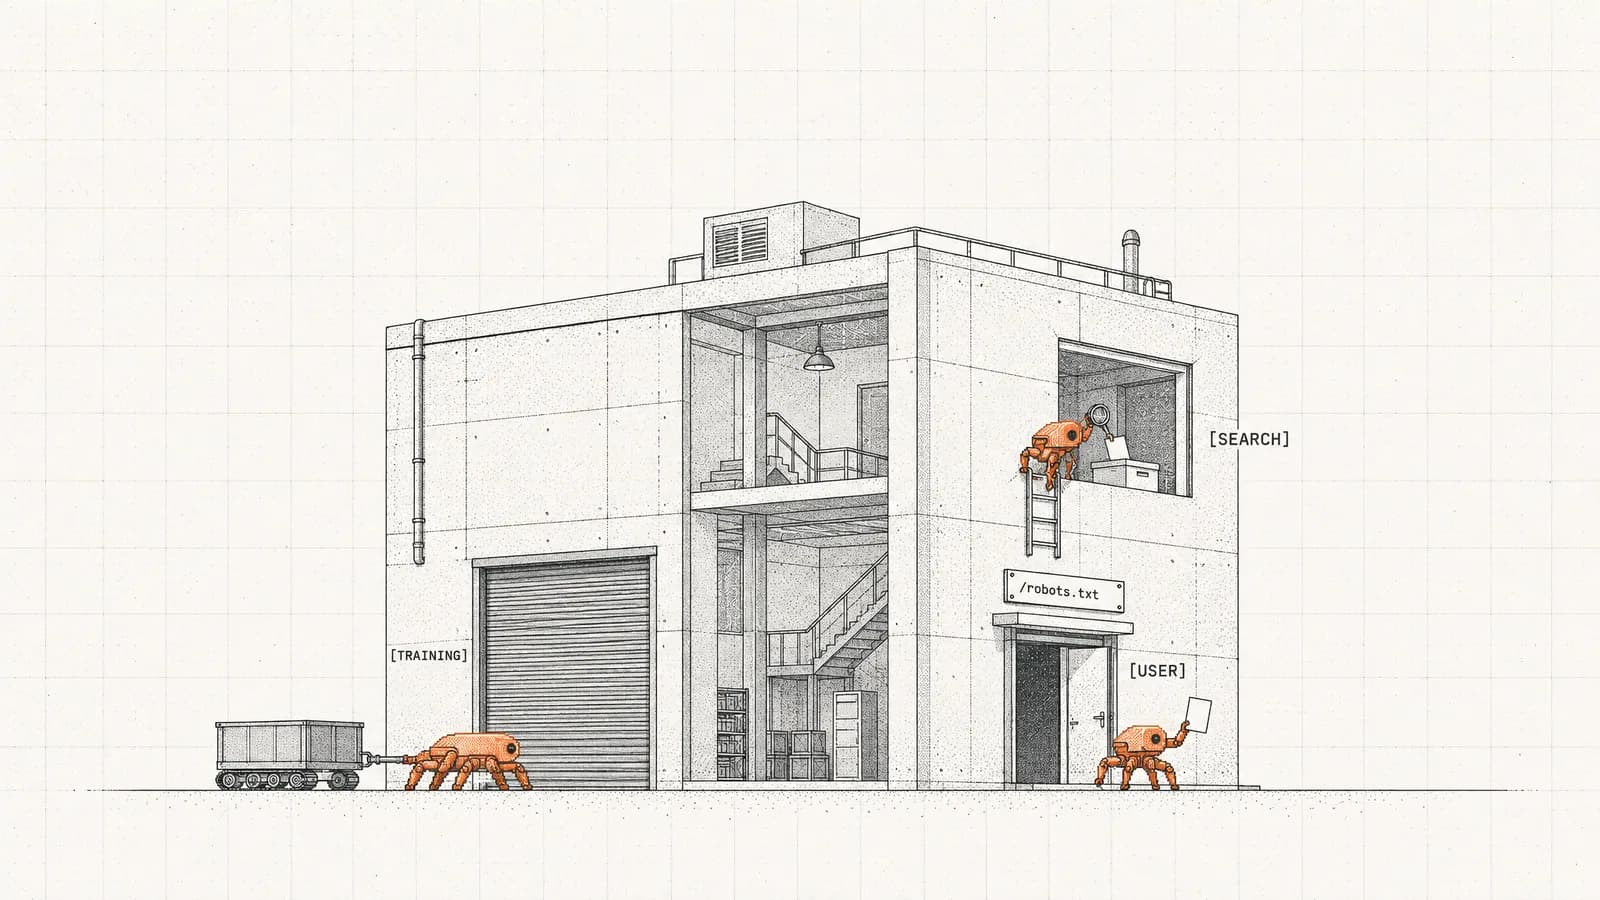
ClaudeBot ist der Web-Crawler, mit dem Anthropic Trainingsdaten für seine AI sammelt. Er ist einer von drei Anthropic-Bots: Claude-SearchBot indexiert Seiten für Claudes Suchantworten, und Claude-User ruft eine Seite ab, wenn jemand Claude danach fragt. Wer ClaudeBot sperrt, hält neue Inhalte aus dem Training heraus, ohne aus Claude zu verschwinden: Von den Top-10.000-Websites, die ihn komplett sperren, lassen 64 % Claude-SearchBot weiter zu.
📖Definition: ClaudeBot ist der Crawler, mit dem Anthropic öffentliche Webseiten sammelt, die zum Training seiner Claude-Modelle verwendet werden können. Er meldet sich mit dem Token ClaudeBot, liest die robots.txt und ist von Claude-SearchBot (Suchindexierung) und Claude-User (vom Nutzer angestoßene Abrufe) getrennt, sodass sich jeder der drei einzeln erlauben oder sperren lässt.
Sie suchen eigentlich Clawdbot? Das ist etwas anderes: ein Open-Source-AI-Assistent für den persönlichen Gebrauch, der sich im Januar 2026 erst in Moltbot und dann in OpenClaw umbenannte, nachdem Anthropic markenrechtliche Bedenken angemeldet hatte, so der Wikipedia-Eintrag zu OpenClaw. Er crawlt das Web nicht für Anthropic. Alles Weitere in diesem Beitrag dreht sich um die Crawler von Anthropic.
Welche drei Crawler betreibt Anthropic, und was macht jeder davon?
Anthropic betreibt drei Bots, jeden mit eigenem robots.txt-Token und eigener Aufgabe. Anthropics Hilfeseite zu den Crawlern, zuletzt aktualisiert am 7. April 2026, listet sie auf und beschreibt, was das Sperren jedes einzelnen bewirkt. Die Spalte für Oktober zeigt den Anteil an AI-Bot-Anfragen, den Cloudflare Radar über die Websites misst, die Cloudflare ausliefert.
| Bot | robots.txt-Token | Aufgabe | Was eine Sperre bewirkt (laut Anthropic, zusammengefasst) | Anteil Okt. 2026 |
|---|
| ClaudeBot | ClaudeBot | Sammelt Seiten, die zum Training von Claude-Modellen dienen können | Ihre künftigen Seiten werden aus Trainingsdatensätzen ausgeschlossen | 12,6 % |
| Claude-SearchBot | Claude-SearchBot | Indexiert Seiten für bessere Suchergebnisse in Claude | Kann Ihre Sichtbarkeit und Genauigkeit in Claudes Suchergebnissen verringern | 1,8 % |
| Claude-User | Claude-User | Ruft eine Seite ab, wenn die Frage eines Claude-Nutzers sie braucht | Claude kann Ihre Seite für diesen Nutzer nicht abrufen; kann die Sichtbarkeit verringern | 0,04 % |
Die Trennung ist wichtig, weil die drei Bots für drei verschiedene Abwägungen stehen. Bei ClaudeBot geht es um Training: ob Ihr Text das nächste Modell mitprägt. Bei Claude-SearchBot und Claude-User geht es um Abruf: ob Claude Ihre Seite finden, lesen und zitieren kann, wenn jemand gerade eine Frage stellt. Eine Website kann zum Ersten Nein und zu den anderen beiden Ja sagen.
Zwei ältere Tokens tauchen noch in robots.txt-Dateien auf: anthropic-ai und Claude-Web. Keines davon steht auf Anthropics aktueller Liste der drei Bots. Nach dem robots.txt-Standard gleicht ein Crawler sein eigenes Token ab. Eine Regel, die nur die alten Tokens nennt, gilt also nicht für ClaudeBot, der stattdessen auf Ihre *-Regeln zurückfällt. Wie oft das vorkommt, steht im Studienteil.
Cloudflares Bot-Verzeichnis ordnet die drei unterschiedlichen Kategorien zu: ClaudeBot als AI-Crawler, Claude-SearchBot als AI-Suche, Claude-User als AI-Assistent. OpenAI fährt dieselbe Dreiteilung (GPTBot, OAI-SearchBot, ChatGPT-User), weshalb sich die Entscheidung weiter unten fast eins zu eins auf ChatGPT übertragen lässt.
Wie groß ist der Anteil von ClaudeBot am AI-Bot-Traffic?
ClaudeBot kam im Oktober 2026 (1. bis 30. Oktober) auf 12,6 % der AI-Bot-Anfragen, die Cloudflare Radar erfasst hat. Nur Googlebot lag mit 23,6 % davor, und GPTBot erreichte mit 5,5 % nicht einmal die Hälfte. Zusammen mit Claude-SearchBot und Claude-User stellten die drei Anthropic-Bots 14,4 % der AI-Bot-Anfragen.
Die Monatsreihe zeigt, wie sprunghaft ClaudeBot ist. Sein Anteil verdoppelte sich von Mai auf Juni und pendelte sich dann wieder bei etwa 12 % ein:
| Monat (2026) | ClaudeBot | Claude-SearchBot | GPTBot | OAI-SearchBot |
|---|
| April | 11,6 % | 0,8 % | 9,8 % | 1,9 % |
| Mai | 9,9 % | 2,1 % | 11,2 % | 1,7 % |
| Juni | 19,8 % | 3,3 % | 9,4 % | 1,5 % |
| Juli | 16,5 % | 3,5 % | 9,7 % | 1,6 % |
| August | 11,9 % | 3,7 % | 8,3 % | 3,1 % |
| September | 12,0 % | 2,7 % | 6,2 % | 3,6 % |
| Oktober (bis zum 30.) | 12,6 % | 1,8 % | 5,5 % | 4,3 % |
📊In Zahlen: Im Oktober 2026 kam ClaudeBot auf 12,6 % der AI-Bot-Anfragen im Cloudflare-Netz, das 2,3-Fache von GPTBots 5,5 %. Claude-SearchBot, der Bot, der darüber entscheidet, ob Claudes Suche Sie findet, kam auf 1,8 %. (Cloudflare Radar, ai/bots user_agent, Kalendermonate, abgerufen am 31. Oktober 2026.)
Zwei Einschränkungen, bevor Sie diese Zahlen zitieren. Radar meldet Anteile, keine Anfragezahlen; ein sinkender Anteil kann also trotzdem mehr Anfragen bedeuten, wenn der gesamte AI-Bot-Traffic gewachsen ist. Und Radar korrigiert die jüngsten Monate, wenn sich die Bot-Klassifizierung verbessert. Deshalb haben wir jeden Monat am selben Tag abgerufen, statt ältere Abrufe wiederzuverwenden. Der monatliche AI-Crawler-Report führt die vollständige Betreiber-Tabelle, und unsere Studie zum AI-Bot-Traffic nach Land zeigt, wie sich der Mix zwischen Märkten verschiebt; dieser Beitrag bleibt bei Anthropic.
Schickt Claude für all das Crawlen überhaupt Traffic zurück?
Ja, und deutlich mehr als noch im Frühjahr. Radars Crawl-to-Refer-Verhältnis teilt die Crawl-Anfragen eines Betreibers durch die Besuche, die seine Produkte an Websites zurückschicken. Bei Anthropic fiel es von 11.198 Crawls pro Referral im April 2026 auf 482 im Oktober, eine 23-fache Verbesserung in sechs Monaten.
| Monat (2026) | Anthropic | OpenAI | Perplexity |
|---|
| April | 11.198 : 1 | 1.027 : 1 | 123 : 1 |
| Mai | 12.874 : 1 | 1.066 : 1 | 139 : 1 |
| Juni | 3.401 : 1 | 652 : 1 | 209 : 1 |
| Juli | 1.914 : 1 | 256 : 1 | 296 : 1 |
| August | 910 : 1 | 424 : 1 | 822 : 1 |
| September | 549 : 1 | 341 : 1 | 2.373 : 1 |
| Oktober (bis zum 30.) | 482 : 1 | 775 : 1 | 4.056 : 1 |
Im Oktober lag Anthropics Verhältnis erstmals in diesem Jahr unter dem von OpenAI, aber das ist mit Vorsicht zu lesen: Der größte Teil von OpenAIs Anstieg ist eine Messänderung. ChatGPTs Links schicken seit Anfang Oktober keinen Referrer mehr mit, also zählt Cloudflare weniger seiner Klicks; die unten verlinkte Auswertung zeigt die Belege aus unseren eigenen Analytics. Perplexity entwickelte sich in die Gegenrichtung, von 123:1 auf 4.056:1. Ein Verhältnis hat zwei bewegliche Teile (Crawl-Volumen und Referral-Volumen). Eine sinkende Zahl kann also heißen, dass Claude-Nutzer häufiger durchgeklickt haben, dass Anthropics Bots weniger gecrawlt haben, oder beides.
💡Schneller Einblick: Die Referrals in diesem Verhältnis stammen von Menschen, die auf Links in Claudes Antworten klicken, und Claudes Web-Antworten stützen sich beim Abrufen von Seiten auf Claude-SearchBot und Claude-User, nicht auf ClaudeBot. Sperren Sie die beiden Abruf-Bots, kann Claude Ihre Seiten nicht lesen, um sie zu zitieren, ganz gleich, was Sie mit ClaudeBot machen. Unsere
Auswertung zum Crawl-to-Refer-Verhältnis deckt jeden Betreiber ab.
Welchen Anthropic-Crawler können Sie gefahrlos sperren?
ClaudeBot ist der Bot, den Sie sperren können, ohne Ihren Platz in Claudes Antworten zu verlieren. Laut Anthropic signalisiert eine ClaudeBot-Sperre, dass Ihre künftigen Seiten aus seinen Trainingsdatensätzen ausgeschlossen werden sollen, und seine Hilfeseite knüpft die Warnung vor geringerer Sichtbarkeit („may reduce your visibility“) nur an Claude-SearchBot und Claude-User. Auf Ihre Rankings bei Google oder Bing wirkt sich eine ClaudeBot-Sperre ebenfalls nicht aus.
Was eine ClaudeBot-Sperre nicht kann: die Vergangenheit rückgängig machen. Anthropic beschreibt sie als wirksam für Ihre künftigen Materialien. Bereits gesammelte Seiten werden also nicht entfernt, und Claude kann Ihre Marke weiterhin aus früherem Training oder von anderen Websites beschreiben.
So verteilen sich die drei Tokens auf vier gängige Ziele:
| Ihr Ziel | ClaudeBot | Claude-SearchBot | Claude-User |
|---|
| Maximale Sichtbarkeit in Claude | Erlauben | Erlauben | Erlauben |
| In Claudes Antworten, nicht im Training | Sperren | Erlauben | Erlauben |
| Weniger Crawl-Last, trotzdem dabei | Crawl-delay | Erlauben | Erlauben |
| Ganz raus bei Anthropic | Sperren | Sperren | Sperren |
Für eine B2B-Software-Website ist meine Standardwahl die erste Zeile, weil offene Abruf-Bots der Ausgangspunkt jeder Arbeit an der Answer Engine Optimization sind. Über das Training lernt ein Modell, dass es Ihre Kategorie gibt und dass Ihr Produkt dazugehört; ein Modell, das Ihre Seiten nie gelesen hat, kann Sie nur aus dem beschreiben, was andere geschrieben haben. Die zweite Zeile ist die richtige Wahl, wenn Ihr Text das Produkt ist (kostenpflichtige Studien, das Archiv eines Verlags, Kursmaterial) und Sie ihn lieber lizenzieren als verschenken.
🔑Kernaussage: Sperren Sie ClaudeBot, um künftige Seiten aus dem Training herauszuhalten. Lassen Sie Claude-SearchBot und Claude-User offen, es sei denn, Sie wollen ganz aus Claude verschwinden: Diese beiden Bots sorgen dafür, dass Claude Ihre Seite finden, lesen und zitieren kann, wenn jemand fragt.
Was machen die Top-10.000-Websites wirklich mit ClaudeBot?
Die meisten Websites, die ClaudeBot sperren, machen die Trennung bereits richtig. Die Probleme stecken in Sammelregeln und in Tokens, die Anthropic nicht mehr aufführt. Wir haben am 31. Oktober 2026 die robots.txt jeder Domain der Tranco-Top-10.000 abgerufen, und 5.386 davon lieferten eine aus. Jeder Prozentwert unten bezieht sich auf diese 5.386 Dateien; die Methode steht am Ende.
| Token | Genannt in | Per Name gesperrt | Gesperrt inkl. * |
|---|
| ClaudeBot | 1.045 (19,4 %) | 685 (12,7 %) | 843 (15,7 %) |
| Claude-SearchBot | 387 (7,2 %) | 139 (2,6 %) | 302 (5,6 %) |
| Claude-User | 395 (7,3 %) | 183 (3,4 %) | 345 (6,4 %) |
| anthropic-ai (alt) | 755 (14,0 %) | 544 (10,1 %) | – |
| Claude-Web (alt) | 628 (11,7 %) | 469 (8,7 %) | – |
| GPTBot (Vergleich) | 1.179 (21,9 %) | 740 (13,7 %) | 887 (16,5 %) |
| OAI-SearchBot (Vergleich) | 609 (11,3 %) | 172 (3,2 %) | 323 (6,0 %) |
„Gesperrt“ heißt komplett gesperrt. „Gesperrt inkl. *“ zählt zusätzlich die Websites, die den Bot nie nennen, aber in ihrer User-agent: *-Gruppe alles sperren. Die alten Tokens bekommen dort keinen Wert, weil keiner der aktuellen Anthropic-Bots sie liest.
Claude-SearchBot steht kaum auf jemandes Liste. Nur 387 Dateien (7,2 %) nennen ihn, gegenüber 1.045, die ClaudeBot nennen. Von diesen 1.045 Dateien erwähnen nur 364 (34,8 %) Claude-SearchBot überhaupt; der Rest überlässt ihn dem, was in der *-Gruppe steht.
Bewusste ClaudeBot-Sperren lassen die AI-Suche meist offen. Von den 685 Websites, die ClaudeBot per Name sperren, lassen 538 (78,5 %) Claude-SearchBot weiter crawlen. Die 147, die auch ihn sperren, tun das fast alle per Name (139 davon), was nach einer Entscheidung aussieht, nicht nach einem Versehen.
Über die Sammelregel * wird die Suche gesperrt, ohne dass jemand sie nennt. Von allen 843 Websites, auf denen ClaudeBot komplett gesperrt ist, sperren 302 auch Claude-SearchBot aus, und 163 dieser 302 tun das ausschließlich über eine User-agent: *-Gruppe, die alles sperrt.
📊In Zahlen: Von den 843 Top-10.000-Websites, die ClaudeBot komplett sperren, lassen 541 (64,2 %) Claude-SearchBot weiter crawlen, und 302 (35,8 %) sperren ihn ebenfalls. Bei OpenAI sieht die Aufteilung fast gleich aus: 36,1 % der Websites, die GPTBot komplett sperren, sperren auch OAI-SearchBot. (SEOmator-Prüfung von 5.386 robots.txt-Dateien, 31. Oktober 2026.)
Die alten Tokens sind die andere Überraschung. 806 Dateien (15,0 %) nennen noch anthropic-ai oder Claude-Web, mehr als doppelt so viele wie die 387, die Claude-SearchBot nennen. Die meisten dieser Dateien nennen auch ClaudeBot; die alten Zeilen sind also Ballast und keine kaputte Sperre. Aber 47 Websites sperren ein altes Token komplett, ohne ClaudeBot je zu nennen. Nach den Abgleichsregeln des Standards ist ClaudeBot auf keiner dieser 47 komplett gesperrt: Er fällt auf die *-Gruppe zurück, die bei 42 davon nur ein paar Pfade sperrt.
🚩Warnsignal: Wenn Ihre robots.txt anthropic-ai oder Claude-Web sperrt, aber nirgends ClaudeBot nennt, verlassen Sie sich auf Tokens, die Anthropic nicht mehr dokumentiert, und laut Standard greift für ClaudeBot keines davon. Am 31. Oktober 2026 fanden wir 47 Top-10.000-Websites in genau diesem Zustand.
Cloudflares eigener robots.txt-Scan ergibt auf einer anderen Auswahl von Websites dieselbe Reihenfolge. In seinem Scan vom 26. Oktober 2026 über 4.367 robots.txt-Dateien großer Domains hatte ClaudeBot in 567 Dateien eine Disallow-Regel, die alten Tokens anthropic-ai und Claude-Web in 356 bzw. 307 und Claude-SearchBot in 200.
Wie sperren oder erlauben Sie ClaudeBot in der robots.txt?
Schreiben Sie eine Gruppe pro Token in die robots.txt im Stammverzeichnis jedes Hosts. Nach RFC 9309 befolgt ein Crawler die Gruppe (oder Gruppen), die sein Token nennen, und ignoriert den Rest; nennt ihn keine Gruppe, befolgt er Ihre User-agent: *-Gruppe. Aus diesem Rückfall entstehen die meisten versehentlichen Sperren.
Um neue Seiten aus dem Training herauszuhalten, aber in Claudes Antworten zu bleiben:
User-agent: ClaudeBot
Disallow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: Claude-User
Allow: /
Die beiden Allow-Gruppen wirken überflüssig, und bei einer Datei mit großzügiger *-Gruppe sind sie es auch. Ihren Platz verdienen sie, sobald Ihre *-Gruppe irgendetwas sperrt: Ohne sie erben Claude-SearchBot und Claude-User diese Regeln.
⚠️Häufiger Fehler: Eine Gruppe User-agent: * / Disallow: /, die Scraper aufhalten soll, hält auch jeden Bot auf, den Sie nicht genannt haben, darunter Claude-SearchBot und Claude-User. In unserer Prüfung haben 185 Top-Websites (3,4 %) eine Pauschalsperre über *, und nur 22 davon nennen Claude-SearchBot. Wenn Sie eine Pauschalsperre nutzen, ergänzen Sie für jeden AI-Such- und Nutzer-Bot, den Sie behalten wollen, eine eigene Gruppe.
Um ClaudeBot zu bremsen statt zu sperren, unterstützt Anthropic die nicht standardisierte Direktive Crawl-delay, die Googlebot ignoriert:
User-agent: ClaudeBot
Crawl-delay: 1
Um Anthropic komplett auszusperren, sperren Sie alle drei Tokens. Ergänzen Sie anthropic-ai und Claude-Web, wenn Sie ältere Tools abdecken wollen, aber verlassen Sie sich nicht allein auf sie:
User-agent: ClaudeBot
User-agent: Claude-SearchBot
User-agent: Claude-User
Disallow: /
Bevor Sie eine Änderung live stellen, prüfen Sie sie so, wie der Bot sie liest:
Jedes Token einzeln testen
Fügen Sie Ihre Datei in unseren robots.txt-Tester ein und testen Sie ClaudeBot, Claude-SearchBot und Claude-User nacheinander gegen eine wichtige URL. Jedes Token sollte das Ergebnis liefern, das Sie beabsichtigt haben.
Auf jeder Subdomain wiederholen
Anthropic liest die robots.txt pro Host, also brauchen docs.example.com und blog.example.com eigene Regeln. Eine Datei auf der Hauptdomain deckt sie nicht ab.
CDN und Firewall prüfen
Bot-Management-Regeln im CDN oder in der WAF können einen Crawler sperren, den Ihre robots.txt erlaubt. Wenn Claude-SearchBot rein soll, stellen Sie sicher, dass auch die Edge ihn durchlässt.
Unser robots.txt-Guide behandelt den Rest der Syntax, einschließlich der Regeln, die Google ignoriert.
Wie prüfen Sie, ob eine Anfrage wirklich von Anthropic kommt?
Gleichen Sie das Token im User-Agent-String ab und prüfen Sie dann die IP gegen Anthropics veröffentlichte Liste. User-Agent-Strings lassen sich trivial fälschen, und die vollständigen Strings variieren: Cloudflares Bot-Verzeichnis führt zum Beispiel zwei verschiedene Claude-User-Strings. Der Abgleich auf ClaudeBot, Claude-SearchBot oder Claude-User erfasst die echten; die IP-Prüfung filtert die Nachahmer heraus.
Anthropic veröffentlicht die IP-Bereiche seiner Crawler unter claude.com/crawling/bots.json und verlinkt die Datei von seiner Hilfeseite. Die Version, die wir abgerufen haben, war auf den 20. Oktober 2026 datiert und enthielt 14 IPv4-Präfixe. Manche Seiten, die für „claudebot“ ranken, behaupten noch, Anthropic veröffentliche keine IP-Bereiche, doch seine Hilfeseite verlinkt genau diese Liste.
📌Profi-Tipp: Nutzen Sie die IP-Liste zum Verifizieren, nicht zum Sperren. Anthropic warnt, dass das Sperren seiner IPs womöglich nicht richtig funktioniert und kein dauerhaftes Opt-out garantiert, weil ein gesperrter Bot die robots.txt mit Ihrem Opt-out nicht lesen kann. Die robots.txt ist die Opt-out-Methode, die Anthropic dokumentiert.
Nichts davon sehen Sie in Google Analytics oder einem anderen skriptbasierten Analytics-Tool. Crawler führen kein JavaScript aus, also tauchen ClaudeBot, Claude-SearchBot und Claude-User nur in Server-Logs oder in den Bot-Berichten Ihres CDN auf. Was skriptbasierte Analytics zeigen kann, ist die andere Seite: die Besucher, die Claude Ihnen schickt. Unser AI Traffic Analytics schlüsselt diese Besuche nach Assistent auf, sodass Sie sehen, ob sich die Claude-Referrals nach einer Änderung an der robots.txt bewegen.
Was sind die häufigsten Fehler bei ClaudeBot?
Die ClaudeBot-Probleme, die wir in robots.txt-Dateien gefunden haben, stammen aus Regeln, die für einen anderen Bot geschrieben wurden oder für eine Version von Anthropics Bot-Aufstellung, die Anthropic nicht mehr dokumentiert.
- Nur die alten Tokens sperren.
anthropic-ai und Claude-Web stehen nicht auf Anthropics aktueller Liste. Wir fanden 47 Top-Websites, die ein altes Token sperren, ohne ClaudeBot zu nennen; nach den Abgleichsregeln des Standards ist ClaudeBot auf keiner davon komplett gesperrt. Ergänzen Sie eine ClaudeBot-Gruppe.
- Eine Pauschalsperre über
*, die die AI-Suche mitnimmt. Regeln gegen Scraper erfassen am Ende auch Claude-SearchBot und Claude-User. Nennen Sie die Bots, die Sie behalten wollen.
- Annehmen, eine ClaudeBot-Sperre entferne Sie aus Claude. Das tut sie nicht. Claude-SearchBot und Claude-User arbeiten weiter, und ältere Trainingsdaten bleiben.
- Annehmen, sie lösche vergangenes Training. Laut Anthropic gilt eine ClaudeBot-Sperre für Ihre künftigen Materialien, nicht für Seiten, die bereits gesammelt wurden.
- Anthropics IPs in der Firewall sperren. Laut Anthropic hält das womöglich nicht, und es hindert den Bot daran, die robots.txt zu lesen, mit der Sie sauber widersprochen hätten.
- Subdomains vergessen. Jeder Host braucht seine eigene robots.txt.
Häufig gestellte Fragen
Wie lautet der User-Agent von ClaudeBot?
ClaudeBot meldet sich mit dem Token ClaudeBot in seinem User-Agent-String; Cloudflares Bot-Verzeichnis führt ihn als ClaudeBot/1.0 (+https://anthropic.com/claudebot). In der robots.txt brauchen Sie nur das Token: User-agent: ClaudeBot. Die anderen beiden Anthropic-Bots nutzen Claude-SearchBot und Claude-User.
Ist ClaudeBot dasselbe wie Clawdbot?
Nein. ClaudeBot ist der Trainings-Crawler von Anthropic. Clawdbot war ein Open-Source-AI-Assistent für den persönlichen Gebrauch, der nichts mit Anthropic zu tun hat und sich im Januar 2026 erst in Moltbot und dann in OpenClaw umbenannte. Wenn Sie eigentlich dieses Projekt suchen, ist OpenClaw das Richtige.
Hält sich ClaudeBot an die robots.txt?
Anthropic dokumentiert die robots.txt als den Weg, seinen Bots zu widersprechen, und unterstützt die nicht standardisierte Direktive Crawl-delay. Aus robots.txt-Dateien allein können wir die Einhaltung nicht prüfen. Sehen Sie ClaudeBot auf Pfaden, die Sie gesperrt haben, prüfen Sie, ob die IP auf Anthropics Liste steht (User-Agent-Strings sind leicht zu fälschen), und schreiben Sie dann von einer Adresse Ihrer Domain an claudebot@anthropic.com, wie es Anthropics Hilfeseite verlangt.
Schadet eine ClaudeBot-Sperre meinen Google-Rankings?
Nein. ClaudeBot spielt für die Suche bei Google oder Bing keine Rolle. Googles eigene Crawler (Googlebot und das Token Google-Extended für das Gemini-Training) sind davon getrennt, und eine ClaudeBot-Regel berührt sie nicht.
Verschwindet meine Website durch eine ClaudeBot-Sperre aus Claudes Antworten?
Nein. Claudes Live-Antworten aus dem Web stützen sich auf Claude-SearchBot und Claude-User, die eine ClaudeBot-Regel nicht erfasst. Um aus Claudes Antworten zu verschwinden, müssten Sie auch diese beiden sperren, und Anthropic warnt, dass das Ihre Sichtbarkeit in Claudes Suchergebnissen verringern kann.
Was ist der Unterschied zwischen ClaudeBot und GPTBot?
Beide sind Trainings-Crawler: GPTBot sammelt Seiten für die Modelle von OpenAI, ClaudeBot für die von Anthropic. Im Cloudflare-Netz stellt ClaudeBot derzeit mehr als doppelt so viele AI-Bot-Anfragen wie GPTBot. Jedes Labor betreibt außerdem einen Such-Bot (OAI-SearchBot, Claude-SearchBot) und einen Bot für Nutzerabrufe (ChatGPT-User, Claude-User), und alle sechs steuern Sie getrennt.
Was ist Claude-SearchBot?
Claude-SearchBot ist der Anthropic-Crawler, der Seiten indexiert, um die Ergebnisse von Claudes Websuche zu verbessern. Er sorgt dafür, dass Claude Ihre Seite findet, wenn die Frage eines Nutzers aktuelle Informationen braucht. Anthropic nennt Training als Aufgabe von ClaudeBot, nicht von Claude-SearchBot. Bei einer Claude-SearchBot-Sperre geht es also darum, ob Claudes Suche überhaupt weiß, dass Ihre Seite existiert.
Kann ich ClaudeBot in Google Analytics sehen?
Nein. ClaudeBot führt kein JavaScript aus, also erfassen skriptbasierte Analytics-Tools ihn nie. Suchen Sie in Ihren Server-Access-Logs oder in den Bot-Analysen Ihres CDN nach dem Token ClaudeBot, und prüfen Sie die IP gegen Anthropics bots.json-Liste.
So haben wir gemessen
Wir haben /robots.txt von jeder Domain der Tranco-Liste der Top-Websites abgerufen (Listen-ID 746VX, heruntergeladen am 31. Oktober 2026), und zwar von den ersten 10.000. Jede Domain bekam eine HTTPS-Anfrage mit einem selbst identifizierenden User-Agent, mit einem zweiten Versuch auf www., wenn die reine Domain keine Datei lieferte, und einem Timeout von 10 Sekunden. Eine Antwort zählte nur dann als robots.txt-Datei, wenn sie HTTP 200 lieferte und sich ihr Inhalt als robots.txt statt als HTML-Seite parsen ließ.
5.386 der 10.000 Domains lieferten eine aus. Die übrigen 4.614 antworteten mit einem Fehler oder einer HTML-Seite, liefen in den Timeout oder hatten gar keine Website: 1.508 Namen ließen sich nicht auflösen, weil viele Tranco-Einträge CDN- und API-Hostnamen statt Websites sind.
Für jede Datei haben wir die Regeln so gruppiert, wie RFC 9309 es beschreibt: Aufeinanderfolgende User-agent-Zeilen bilden eine Gruppe, Tokens werden ohne Rücksicht auf Groß- und Kleinschreibung abgeglichen, ein Bot befolgt jede Gruppe, die ihn nennt, und ein nirgends genannter Bot befolgt die *-Gruppe. Danach haben wir jedes Token auf zwei Arten eingeordnet: was die Datei sagt, wenn sie das Token nennt, und was der Bot tatsächlich bekommt, sobald der Rückfall auf * greift. „Komplett gesperrt“ heißt Disallow: / (oder /*) ohne Allow-Regel; „teilweise gesperrt“ heißt, es gibt nur Sperren auf Pfadebene.
Die Traffic- und Referral-Zahlen stammen aus der API von Cloudflare Radar, abgerufen am 31. Oktober 2026: ai/bots/summary/user_agent für die Anteile an AI-Bot-Anfragen und bots/crawlers/summary/crawl_refer_ratio für die Crawl-to-Refer-Verhältnisse. Wir haben jeden Kalendermonat einzeln abgerufen, damit jeder Monat denselben Zeitraum abdeckt; der Oktober reicht vom 1. bis 30. Oktober. Radar sieht nur Traffic, der durch Cloudflare läuft, meldet Anteile statt absoluter Zahlen und korrigiert die jüngsten Monate.
Die Grenzen gehören offen auf den Tisch. Wir haben nur die robots.txt im Stammverzeichnis gelesen; eine Subdomain mit eigenen Regeln ist also nicht erfasst. Es ist eine Momentaufnahme eines einzigen Tages. Die robots.txt drückt eine Absicht aus und setzt nichts durch. Eine Website kann einen Bot also in ihrem CDN sperren, während die Datei ihn erlaubt, und wir haben nicht getestet, ob sich irgendein Bot an die Dateien hält, die er liest.
Was sollten Sie diese Woche tun?
Öffnen Sie Ihre robots.txt und suchen Sie nach vier Tokens: ClaudeBot, Claude-SearchBot, Claude-User und *. Entscheiden Sie, welches der vier Ziele aus der Tabelle oben Ihres ist, schreiben Sie eine Gruppe pro Bot und testen Sie jedes Token im robots.txt-Tester, bevor Sie live gehen. Wenn Sie in Claudes Antworten bleiben wollen, lassen Sie die beiden Abruf-Bots offen und prüfen Sie dann die AI-Sichtbarkeit Ihrer Marke, um zu sehen, wie AI-Assistenten Sie heute beschreiben. Die robots.txt ist die einzige Datei, die Anthropic zur Crawler-Steuerung dokumentiert; eine llms.txt ist optional.


 Aufgeschrieben von Emre Elbeyoglu