
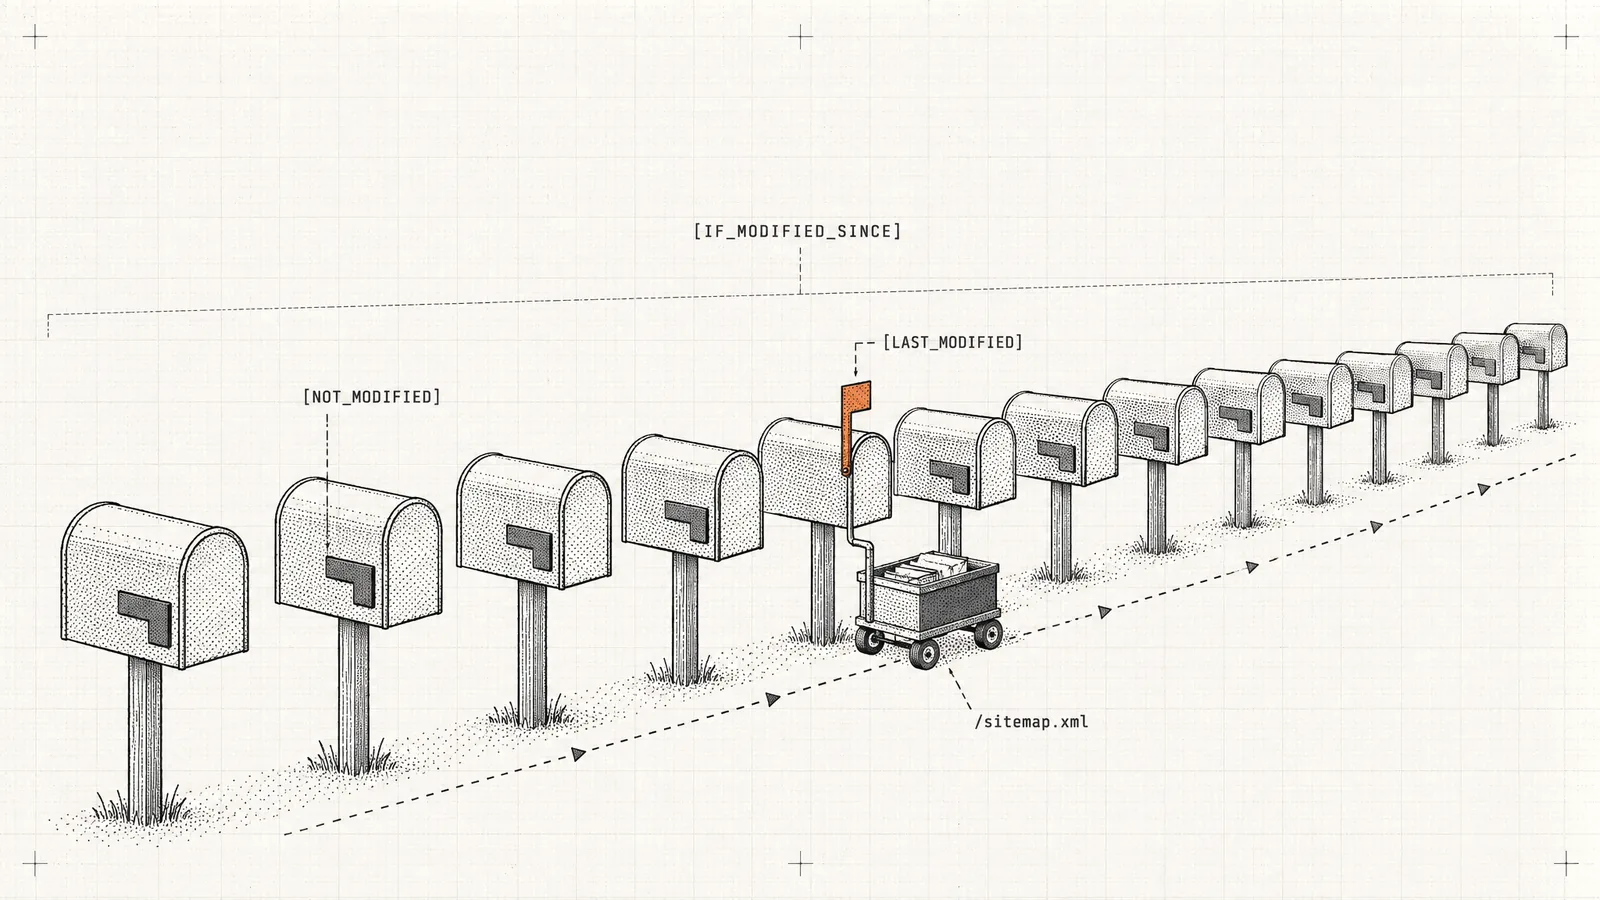
· 13 Min. Lesezeit
Last-Modified und If-Modified-Since: 549 Websites im Test
Wir haben 549 Top-Startseiten erneut abgefragt: 86,7 % beachten If-Modified-Since, nur 58,1 % If-None-Match. So funktionieren Last-Modified und ETag.
Dieser kostenlose Website-Crawl-Test beantwortet zwei Fragen zu jeder URL: ob robots.txt und Meta-Robots Google und Bing die Indexierung erlauben, und wie viel der Seite bereits existiert, bevor JavaScript ausgeführt wird. Wir rufen sie als Googlebot ab, rendern sie in Headless Chrome und zeigen Ihnen den Unterschied. Ohne Anmeldung.
 Geprüft von Charles Duncan, Mitgründer & CTO
Zu jeder URL laufen zwei Prüfungen parallel. Die erste wertet Ihre robots.txt nach Googles Longest-Match-Regel aus und liest das Meta-Robots-Tag der Seite. Die zweite ruft die Seite zweimal ab – einmal als rohes HTML mit dem Smartphone-User-Agent von Googlebot, einmal über Headless Chrome, sodass JavaScript tatsächlich ausgeführt wird – und zählt dieselben Signale in beiden Fassungen mit demselben Tokenizer. Der Unterschied, den Sie sehen, ist damit ein echter Unterschied und kein Artefakt zweier Messmethoden.
Kein Konto, keine Website-Verifizierung, kein Eigentumsnachweis. Fügen Sie eine Startseite, eine Produktseite oder eine tief liegende gefilterte Kategorie ein – die Seiten mit Rendering-Problemen sind selten die Startseite.
Zuerst das rohe HTML, angefordert mit dem echten Smartphone-User-Agent von Googlebot – bei Mobile-First-Indexierung entscheidet dessen Sicht. Anschließend dieselbe URL über Headless Chrome, mit aktiviertem JavaScript und Zeit, bis das Netzwerk zur Ruhe kommt.
Title, H1, Meta-Description, Canonical, Wortzahl, interne Links, Überschriften und JSON-LD-Blöcke werden in beiden gezählt. Was nur in der zweiten Fassung existiert, ist der Teil Ihrer Seite, den Google spät oder gar nicht indexiert.
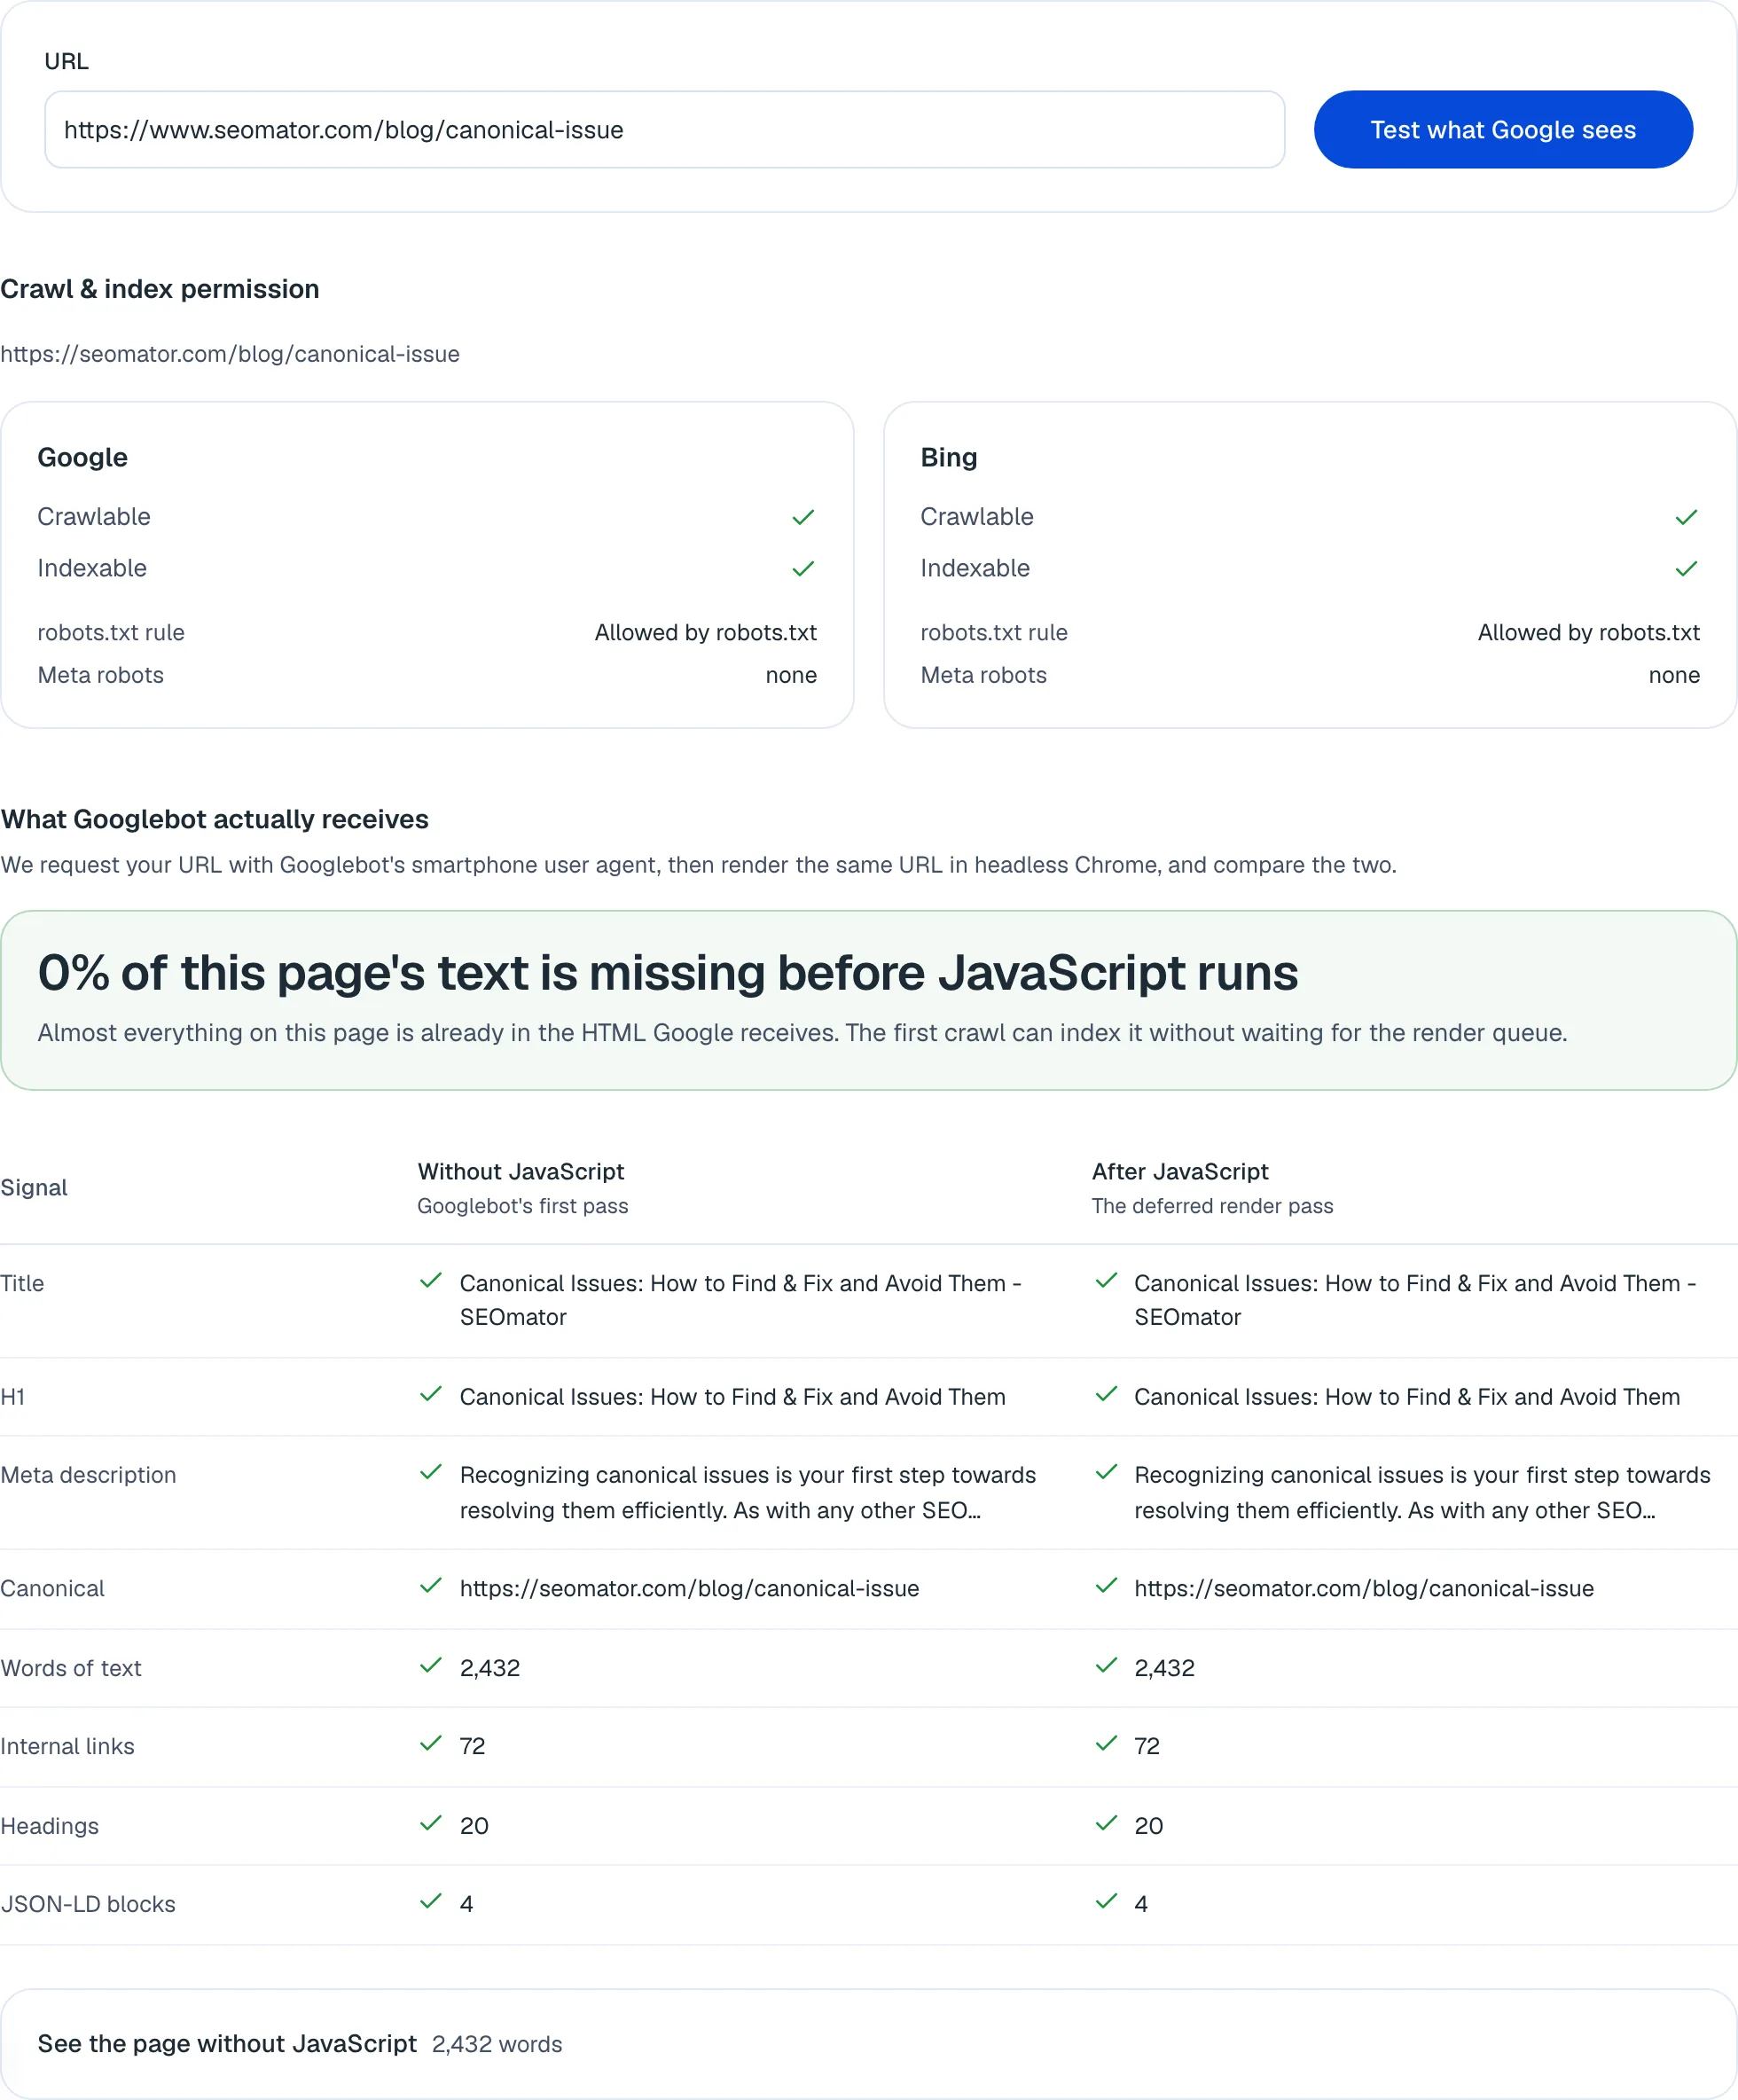
Alles, was der Test ausgibt, ist kostenlos und benötigt kein Konto. Ein kostenloses SEOmator-Konto macht aus der Prüfung einer einzelnen URL eine laufende Überwachung.
Getrennte Crawlbar-/Indexierbar-Verdikte je Suchmaschine, jeweils mit der robots.txt-Regel, die entschieden hat, und dem Meta-Robots-Wert der Seite.
Die Rohanfrage trägt den echten Smartphone-User-Agent von Googlebot, Sie sehen also die Mobile-First-Sicht. Weist Ihr Server diesen Agent ab, meldet der Test das – schon das erklärt manche Indexierungsprobleme.
Eine Kennzahl: der Anteil des Seitentextes, der erst existiert, wenn JavaScript läuft – gemessen gegen einen vollständigen Headless-Chrome-Render.
Lesen Sie den Text, den Ihr Server tatsächlich ausgeliefert hat. Ist dieses Feld leer, ist eine leere Seite das, womit Googles erster Durchgang arbeiten muss.
Links, die erst nach der Hydration erscheinen, sind Crawl-Pfade, denen Googlebot womöglich nie folgt. Beide Zahlen werden ausgewiesen, denn ein Auffindbarkeitsproblem wiegt schwerer als ein Inhaltsproblem.
Per JavaScript eingefügtes JSON-LD wird erst im aufgeschobenen Render-Durchgang gelesen. Der Test zeigt, ob Ihres im HTML steht oder später eintrifft.
Alle Tests aufbewahren und die Lücke zwischen roh und gerendert über Deployments hinweg verfolgen, statt sie aus dem Gedächtnis zu vergleichen.
Werden Sie benachrichtigt, wenn ein Release Inhalte aus dem Server-HTML drängt – der Fehler, den niemand bemerkt, bis Wochen später der Traffic einbricht.
Diese Seite prüft eine URL. Ein Konto crawlt die komplette Website und berichtet Rendering, Indexierbarkeit und über 250 weitere Prüfungen für jede Seite.
Überwachung, Verlauf und Website-weite Crawls gibt es mit einem kostenlosen Konto.
Kostenloses Konto erstellen Geprüft vonCharles Duncan · Mitgründer & CTO
Ich habe das gebaut, weil „Erreicht Googlebot die URL?" nie die interessante Frage war – die Freigabe lässt sich trivial prüfen und ist selten das eigentliche Problem. Interessant ist, wie viel der Seite existiert, bevor JavaScript läuft, und diese Zahl überrascht die meisten: Die Diskrepanz zwischen rohem und gerendertem Inhalt ist der achthäufigste Fehler, den unsere Audit-Engine über die von uns gecrawlten Sites protokolliert. Die ehrliche Einschränkung: Unser Headless Chrome ist nicht Googles Renderer. Wir warten, bis das Netzwerk ruhig ist, und erstellen eine Momentaufnahme; Googles Web Rendering Service hat eigene Timeouts, ein eigenes Ressourcenbudget und eine Warteschlange, die niemand außerhalb von Google einsehen kann. Lesen Sie eine große Lücke hier als starkes Signal, der Sache nachzugehen – nicht als Beweis, dass eine bestimmte Seite nicht indexiert ist. Die URL-Prüfung in der Search Console bleibt das einzige Werkzeug, das berichtet, was Google tatsächlich gespeichert hat.
 Charles Duncan · Mitgründer & CTO
Über die mehr als 100.000 Sites, die unsere Audit-Engine 2026 gecrawlt hat, ist Inhalt, der im gerenderten DOM vorhanden, im rohen HTML aber nicht auffindbar ist, der achthäufigste Fehler, den wir protokollieren – er tritt bei 31,4% der auditierten Sites auf (H1 2026). Das ist kein Nischenproblem einzelner Single-Page-Apps. Es zeigt sich regelmäßig auf Sites, deren Teams überzeugt sind, serverseitig zu rendern.
Die Startseite ist meist die eine Route, an deren Pre-Rendering ein Team denkt. Paginierte Listen, gefilterte Kategorien und Suchergebnisseiten sind die Stellen, an denen das Rendering still auf den Client zurückfällt – und dort liegen zugleich die meisten indexierbaren URLs einer Site.
Null interne Links im rohen HTML ist gravierender als dünner Rohtext. Text, der spät eintrifft, wird spät indexiert; Links, die spät eintreffen, können bedeuten, dass die dahinterliegenden Seiten nie gefunden werden.
Google gibt an, Canonical-Angaben nach dem Rendern zu verarbeiten. In der Praxis ist ein Canonical, das erst nach dem Render existiert, jedoch eine der häufigsten Ursachen dafür, dass die falsche URL indexiert wird. Steht es im Server-HTML, entfällt die Mehrdeutigkeit.
Trägt die erste Antwort ein noindex, wird das im ersten Durchgang befolgt. Es später per JavaScript zu entfernen, macht das nicht rückgängig – die Entscheidung fiel, bevor die Render-Warteschlange überhaupt erreicht wurde.
Die Rendering-Strategie ist keine Eigenschaft Ihres Frameworks, sondern Ihrer aktuellen Konfiguration. Major-Upgrades, eine neue Edge-Caching-Regel oder eine von Server auf Client umgestellte Komponente sind Ein-Zeilen-Änderungen, die eine Seite von serverseitig gerendert zu JavaScript-abhängig verschieben können.
Die meisten Crawl-Checker beantworten eine Frage: Darf diese URL indexiert werden? Das ist eine Frage der Freigabe, und beantwortet wird sie von zwei kleinen Textstücken – einer Regel in Ihrer robots.txt und einem meta robots-Tag in Ihrem HTML. Die Prüfung lohnt sich, sie dauert Millisekunden, und sie ist fast nie der Grund, warum eine Seite bei Google fehlt.
Die zweite Frage ist schwieriger und weitaus häufiger die Ursache: Was erhält Googlebot tatsächlich, wenn es Ihre URL anfordert?
Das sind unterschiedliche Fehler mit unterschiedlichen Lösungen. Eine Seite kann einwandfrei freigegeben sein und trotzdem als nahezu leeres Dokument indexiert werden – weil der Inhalt, den Besucher sehen, in deren Browser von JavaScript zusammengesetzt wurde, das die erste Anfrage von Googlebot nie ausgeführt hat. Dieser Test führt beide Prüfungen nebeneinander aus:
robots.txt wird nach Googles Longest-Match-Regel ausgewertet und der meta robots-Wert der Seite gelesen. Daraus entstehen getrennte Crawlbar-/Indexierbar-Verdikte für Google und Bing.Alles Folgende dreht sich um die zweite Hälfte – denn dafür fehlt den meisten Menschen schlicht ein Werkzeug.
Google crawlt und rendert nicht in einem Schritt. Es laufen zwei Durchgänge, getrennt durch eine unbekannte Zeitspanne.
Durchgang eins – HTML crawlen und indexieren. Googlebot fordert Ihre URL an und erhält, was Ihr Server sendet. Diese Antwort wird geparst; Text, Überschriften, Links, Meta-Tags und strukturierte Daten werden aus dieser Antwort extrahiert und indexiert. Zugleich wird jeder gefundene Link zum Crawlen eingereiht. Dieser Durchgang ist schnell – und er findet immer statt.
Durchgang zwei – Rendern. Die Seite geht an einen separaten Dienst, der sie in einem Headless-Browser lädt, JavaScript ausführt und ein gerendertes DOM erzeugt. Google indexiert die Seite anschließend aus diesem DOM erneut. Dieser Durchgang ist aufgeschoben: Er steht in einer Warteschlange, hat eigene Timeouts und ein eigenes Ressourcenbudget und wird priorisiert wie jede endliche Ressource.
Bei den meisten Seiten der meisten Websites kommt der zweite Durchgang. Aus der Architektur folgen jedoch drei Dinge – und genau sie machen das rohe HTML so wichtig:
Deshalb ist „Google rendert JavaScript" zwar richtig, aber kein Grund zur Entspannung. Das Rendern ist eine zweite Chance – nicht die erste.
Die Vergleichstabelle hat eine Zeile je Signal und eine Spalte je Durchgang. Die linke Spalte zeigt, was Durchgang eins erhält; die rechte, was nach JavaScript existiert. Was die einzelnen Zeilen bedeuten:
Title, Meta-Description, Canonical. Diese drei gehören ausnahmslos ins Server-HTML. Ein per JavaScript gesetzter Title kann im ersten Durchgang übersehen werden, und ein Canonical, das erst nach dem Render existiert, ist eine bekannte Ursache dafür, dass die falsche URL indexiert wird. Steht eines davon rechts und fehlt links, beheben Sie das zuerst – meist ist es eine Änderung von einer Zeile.
H1 und Überschriften. Eine fehlende H1 im rohen HTML bei gleichzeitig vorhandener H1 nach JavaScript ist die klassische Signatur einer Single-Page-App. Ihr Dokument trifft ohne erklärtes Thema ein.
Wörter Text. Die Prozentzahl oben auf dieser Seite stammt aus dieser Zeile: wie viel des gerenderten Seitentextes im rohen HTML fehlt. Kleine Lücken sind normal und kein Handlungsbedarf – ein Cookie-Banner, ein nachgeladenes Testimonial, ein Chat-Widget. Große Lücken bedeuten, dass die Substanz der Seite nicht in der Antwort steht, die Google zuerst indexiert.
Interne Links. Behandeln Sie diese Zeile als die wichtigste nach den Meta-Tags. Text, der spät eintrifft, wird spät indexiert. Links, die spät eintreffen, können bedeuten, dass die dahinterliegenden Seiten nie gefunden werden. Null interne Links im rohen HTML auf einer Seite, die nach dem Rendern Dutzende hat, ist ein Architekturproblem im Rendering-Kostüm.
JSON-LD-Blöcke. Per JavaScript eingefügte strukturierte Daten werden im Render-Durchgang gelesen – sofern er kommt. Eine Rich-Result-Eignung, die davon abhängt, ist eine Wette.
Unter der Tabelle gibt die Textvorschau den sichtbaren Text aus, der tatsächlich aus der Antwort Ihres Servers extrahiert wurde. Das ist die am wenigsten abstrakte Ausgabe dieser Seite: buchstäblich die Fassung Ihrer Seite, die Google zuerst indexiert. Ist sie leer, ist genau das der Befund.
Über die mehr als 100.000 Sites, die unsere Audit-Engine 2026 gecrawlt hat, ist Inhalt, der im gerenderten DOM vorhanden, im rohen HTML aber nicht auffindbar ist, der achthäufigste Fehler, den wir protokollieren – er tritt bei 31,4% der auditierten Sites auf (H1 2026). Er liegt damit auf einer Stufe mit fehlenden Alt-Texten und doppelten Title-Tags: nicht exotisch, nicht auf experimentelle Stacks beschränkt und häufig auf Sites zu finden, deren Teams überzeugt sind, serverseitig zu rendern.
Fünf Muster erklären den Großteil dessen, was wir sehen.
Teams rendern die Startseite vor, weil sie die Seite ist, die sie vorführen, testen und die jedes Tool voreinstellt. Paginierte Listen, gefilterte Kategorien, Suchergebnisse und kontonahe Seiten fallen auf Client-Rendering zurück – und dort liegen die meisten indexierbaren URLs einer Website. Testen Sie immer eine tiefe Seite.
Menüs und Paginierungen aus Klick-Handlern und router.push() erzeugen kein href, dem Googlebot in Durchgang eins folgen könnte. Für Menschen sind die Seiten erreichbar, für den ersten Crawl unsichtbar. Die Lösung ist unspektakulär: echte <a href>-Elemente, wobei JavaScript sie ergänzt statt ersetzt.
Das Rendering-Verhalten ist eine Eigenschaft der Konfiguration, nicht des Frameworks. Ein Major-Upgrade, eine von Server auf Client verschobene Komponente oder eine neue Edge-Caching-Regel können eine Route von serverseitig gerendert auf rein clientseitig umstellen – ohne sichtbare Änderung im Browser. Niemand bemerkt es, weil die Seite für alle, die hinsehen, weiterhin korrekt aussieht.
Eine Seite, die nach zwölf Sekunden API-Aufrufen korrekt rendert, ist eine Seite, deren Rendern in ein Timeout laufen kann. Googles Renderer gibt – wie unserer – irgendwann auf. Langsames Rendern ist ein Rendering-Fehler mit Verzögerung.
Manche Server weisen Anfragen mit dem User-Agent von Googlebot ab – meist als Bot-Filterung, an deren Aktivierung sich niemand mehr erinnert. Meldet dieser Test, dass der Googlebot-User-Agent abgewiesen wurde, gehen Sie dem sofort nach: Der echte Googlebot weist sich per Reverse-DNS aus, doch eine pauschale Sperre auf den User-Agent-String trifft ihn ebenfalls.
Nach Wirkung geordnet:
<a href="/produkte/widget"> im HTML, was auch immer das Klickverhalten darüber hinaus tut.noindex-Entscheidungen in der Serverantwort – und meinen Sie sie ernst. Ein noindex im rohen HTML wird im ersten Durchgang befolgt. Es später per JavaScript zu entfernen, macht das nicht rückgängig: Die Entscheidung fiel, bevor die Render-Warteschlange erreicht wurde.Das rohe HTML zu reparieren ist dauerhafter, als den Render-Durchgang beschleunigen zu wollen – es beseitigt die Abhängigkeit, statt gegen sie anzutreten.
Drei ehrliche Einschränkungen gehören dazu.
Unser Renderer ist nicht Googles. Dieser Test nutzt Headless Chrome und wartet, bis das Netzwerk ruhig ist, bevor er die Momentaufnahme erstellt. Googles Web Rendering Service hat eigene Timeouts, ein eigenes Ressourcenbudget und eine Warteschlange, die niemand außerhalb von Google beobachten kann. Eine große Lücke hier ist ein starkes Indiz dafür, dass eine Seite gefährdet ist – kein Beweis, dass eine bestimmte URL nicht indexiert ist.
Er kann nicht sagen, was Google tatsächlich gespeichert hat. Das kann nur die URL-Prüfung in der Search Console, und auch nur für Properties, die Sie verifiziert haben. Zeigt dieser Test eine große Lücke, die Search Console die Seite aber als indexiert mit vollständigem Inhalt, dann hat der Render-Durchgang sie erreicht – Sie hatten Glück statt Sicherheit, aber die Seite ist heute in Ordnung.
Er prüft eine URL. Ein einzelnes Ergebnis lässt sich auf Templates verallgemeinern, nicht auf eine ganze Website. Fällt eine Produktseite durch, nehmen Sie an, dass alle Produktseiten durchfallen – bestätigen Sie es aber mit einem vollständigen Site-Audit, statt es vorauszusetzen.
Für die angrenzenden Prüfungen: Der robots.txt-Tester erklärt ein blockiertes Verdikt im Detail, der Sitemap-Finder zeigt, was Sie tatsächlich zum Crawlen einreichen, und der Mobile-Friendly-Test deckt die andere Hälfte der Mobile-First-Indexierung ab. Zeigt die Search Console das Symptom bereits, ist „Gecrawlt – zurzeit nicht indexiert" der Bericht, der am häufigsten auf das zurückführt, was dieser Test misst.
Sie haben eine Route auf eine Client-Komponente umgestellt und wollen vor dem Produktivgang wissen, ob Texte und Links noch in der Serverantwort stehen.
Seiten sind indexiert, ranken aber für nichts, oder die Search Console meldet „Gecrawlt – zurzeit nicht indexiert". Zu prüfen, was das HTML tatsächlich enthält, dauert zehn Sekunden und schließt die größte Ursache ein oder aus.
Sie brauchen einen konkreten, vorführbaren Befund – „84% Ihrer Produktseite existieren erst, wenn JavaScript läuft" ist ein besserer Einstieg als ein allgemeiner Website-Score.
Jedes Ergebnis auf dieser Seite – beide Verdikte, der vollständige Vergleich, die Textvorschau – ist kostenlos und erfordert kein Konto, keine E-Mail und keine Website-Verifizierung.
Freigabe und Realität sind unterschiedliche Fehler mit unterschiedlichen Lösungen. Die meisten Tools beantworten eine davon; dieses beantwortet beide aus einer URL.
Der Vergleich schickt Ihre Seite durch Headless Chrome. Er wird nicht aus Framework-Fingerabdrücken oder einem Text-zu-HTML-Verhältnis abgeleitet – so raten die meisten „JS-SEO-Checker".
Der Rohabruf weist sich als Googlebot Smartphone aus, denn dieser Crawler entscheidet über die Indexierung Ihrer Site. Ein Abruf mit Desktop-Browser kann deutlich anderes HTML zurückgeben.
Die Vorschau ohne JavaScript gibt den tatsächlich extrahierten Text aus. Sie lesen die Fassung Ihrer Seite, die Google indexiert, statt einer Zahl darüber zu vertrauen.
Kombinieren Sie ihn mit dem robots.txt-Tester, dem Sitemap-Finder und dem kostenlosen Site-Audit, um einen Einzelbefund über die gesamte Website zu prüfen.
„Abruf wie durch Google" (Fetch as Google) war eine Funktion der Search Console, die zeigte, wie Googlebot eine Seite abruft und rendert. Google hat sie 2019 eingestellt und ihre Fähigkeiten in die URL-Prüfung überführt, die verifizierten Zugriff auf die Property voraussetzt. Diese Seite ist das kostenlose öffentliche Äquivalent für den Teil, den die meisten brauchten: Sie ruft Ihre URL mit dem User-Agent von Googlebot ab, rendert dieselbe URL in Headless Chrome und zeigt den Unterschied – für jede URL, ohne Verifizierung.
Ja, aber nicht sofort und nicht bedingungslos. Googlebot crawlt zuerst das rohe HTML und indexiert, was dort steht. Das Rendern erfolgt in einem zweiten Durchgang durch einen separaten Dienst mit eigener Warteschlange, eigenen Timeouts und eigenem Ressourcenbudget. Bei den meisten Seiten kommt dieser zweite Durchgang, aber unter Umständen erst Stunden oder Tage später – und Seiten, die langsam, fehleranfällig oder niedrig priorisiert sind, können allein anhand ihres rohen HTML indexiert werden. Inhalte, die erst nach JavaScript existieren, sollten Sie daher als Inhalte betrachten, die indexiert werden könnten, nicht als solche, die es werden.
Weil Ihr Browser JavaScript ausführt und die erste Spalte dieses Tests nicht. Zeigt die Spalte mit dem rohen HTML eine Handvoll Wörter, die gerenderte Spalte aber die vollständige Seite, liefert Ihr Server eine Hülle aus und der Browser setzt den Inhalt zusammen. Für clientseitig gerenderte Anwendungen ist das normal und im Alltag unsichtbar – genau deshalb fällt es erst auf, wenn Seiten nicht mehr indexiert werden.
Nein – nicht das Framework ist das Problem, sondern die Rendering-Konfiguration. React, Vue, Angular und Svelte können alle vollständig serverseitig gerendertes HTML erzeugen, und alle lassen sich so konfigurieren, dass sie stattdessen eine leere Hülle ausliefern. Dasselbe Repository kann eine Route serverseitig gerendert und die nächste rein clientseitig ausliefern. Deshalb lohnt es sich, konkrete URLs zu testen, statt vom eigenen Stack auf das Ergebnis zu schließen.
Nach Wirkung geordnet: Verlagern Sie den Hauptinhalt, die H1, die Meta-Tags und das Canonical der Seite in die Serverantwort (Server-Side Rendering, statische Generierung oder Prerendering, je nach Framework); sorgen Sie dafür, dass interne Links echte Anchor-Elemente mit href-Attribut im HTML sind statt Klick-Handler; und halten Sie strukturierte Daten serverseitig. Das rohe HTML zu reparieren ist dauerhafter, als den Render-Durchgang beschleunigen zu wollen – es beseitigt die Abhängigkeit, statt gegen sie anzutreten.
Website-Crawling ist der Prozess, mit dem Suchmaschinen neue Webseiten entdecken und indexieren. Er wird von automatisierten Programmen namens "Spider" oder "Bots" durchgeführt, die Links auf Webseiten folgen, um neue Seiten zu entdecken, und anschließend deren Inhalt lesen, um den Kontext zu verstehen.
Suchmaschinen nutzen automatisierte Programme namens "Spider" oder "Bots", um Websites zu crawlen. Diese Crawler folgen Links auf Webseiten, um neue Seiten zu finden, und lesen dann den Inhalt dieser Seiten, um deren Inhalt und Kontext zu verstehen. Sie erfassen außerdem Informationen zu jeder Seite, etwa wann sie zuletzt aktualisiert wurde, wie wichtig die Seite ist und alle weiteren Metadaten, die zum Verständnis des Inhalts oder Kontexts nützlich sein könnten.
Die Häufigkeit des Crawlings kann variieren – abhängig von der Beliebtheit einer Website, der Anzahl der auf sie verweisenden Links und davon, wie häufig ihr Inhalt aktualisiert wird. Websites mit viel Traffic oder häufig aktualisierten Inhalten werden möglicherweise öfter gecrawlt als Websites mit wenig Traffic. Wichtig ist jedoch: Es gibt keinen festen Zeitplan dafür, wann eine Website gecrawlt wird.
Website-Betreiber können die robots.txt-Datei und Meta-Tags nutzen, um zu steuern, wie Suchmaschinen ihre Websites crawlen. Die robots.txt-Datei ist eine einfache Textdatei, die im Stammverzeichnis einer Website abgelegt werden kann; sie teilt Suchmaschinen mit, welche Seiten oder Bereiche der Website nicht gecrawlt werden sollen. Auch Meta-Tags wie das "noindex"-Tag lassen sich nutzen, um zu steuern, wie Suchmaschinen eine Webseite indexieren und anzeigen.
Um Ihre Website von Suchmaschinen indexieren zu lassen, können Sie Folgendes tun: eine Sitemap an die Google Search Console übermitteln, interne Verlinkung innerhalb der Website einbauen, externe Links von anderen Websites gewinnen, strukturierte Daten und Schema-Markup verwenden und sicherstellen, dass die Website mobilfreundlich ist und eine schnelle Ladezeit hat.
Crawling ist der Prozess, mit dem Suchmaschinen neue Webseiten entdecken, und Indexierung ist der Prozess, diese Seiten in die Datenbank einer Suchmaschine aufzunehmen. Crawling ist der erste Schritt, Indexierung der zweite. Sobald eine Seite indexiert ist, ist sie in der Datenbank der Suchmaschine enthalten und kann in den Suchergebnissen ausgegeben werden.
Vertiefende Beiträge aus dem SEOmator-Blog zu dem, was dieses Tool misst.
· 13 Min. Lesezeit
Wir haben 549 Top-Startseiten erneut abgefragt: 86,7 % beachten If-Modified-Since, nur 58,1 % If-None-Match. So funktionieren Last-Modified und ETag.
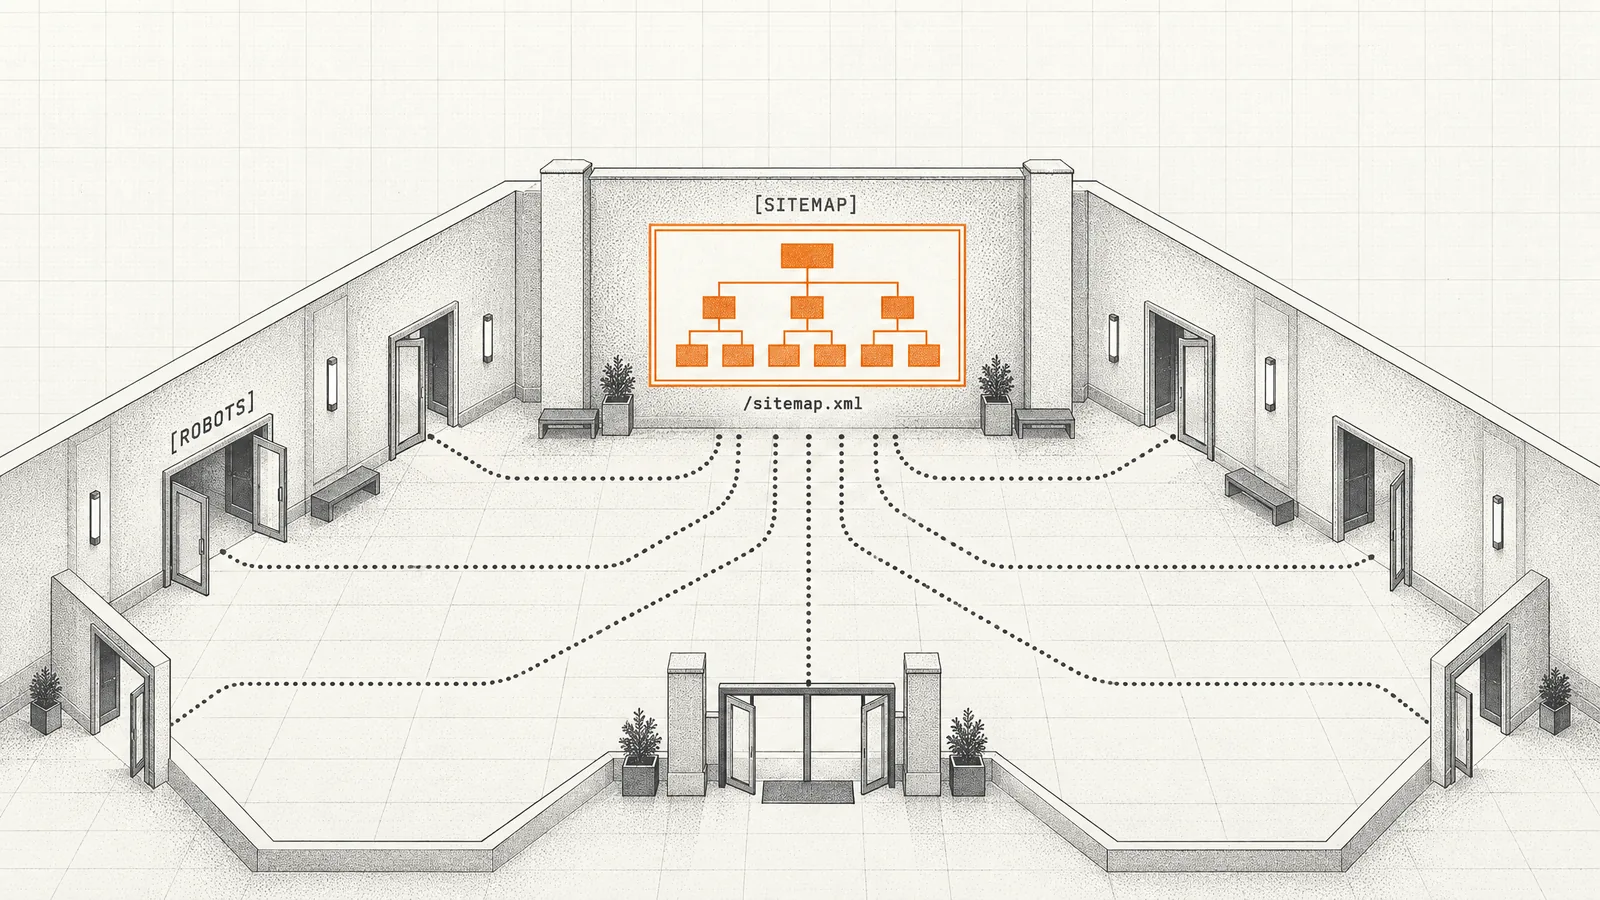
· 9 Min. Lesezeit
Ähnlich wie ein Bauplan, der das Design eines Hauses skizziert, hilft eine Sitemap den Suchmaschinen, eine Website effizient zu navigieren und alle Seiten richtig zu indizieren. In diesem Sinne spielen Sitemaps eine zentrale Rolle in der SEO-Strategie jeder Website.
· 22 Min. Lesezeit
Wir haben 151 B2B-SaaS-Preisseiten von Googles Seite 1 getestet. Rendering und Canonicals passen meist; nur 32,5 % zeichnen Preise aus. Das 8-Schritte-Audit.
Verbessern Sie Ihre Online-Präsenz mit unserem Tool: Werden Sie gefunden, kommen Sie voran


