SEOmators AI Crawler Report für September 2026: Crawling zu Suchzwecken erreichte weltweit 10,6 % der AI-Bot-Anfragen, viermal so viel wie im Januar (2,6 %) und fast doppelt so viel wie im Juli (5,6 %). In denselben Monaten fiel GPTBot, der Trainings-Crawler von OpenAI, von 12,6 % des AI-Bot-Traffics auf 6,2 %, während PerplexityBot nach Juli auf mehr als das Sechsfache wuchs, auf 2,2 %. Die globalen Zahlen sind Kalendermonate aus Cloudflare Radar; die Zahlen unseres eigenen Panels reichen bis Juli 2026.
Die wichtigsten Erkenntnisse aus dem AI Crawler Report für September 2026:
- Crawling zu Suchzwecken: 2,6 % (Januar) → 5,6 % (Juli) → 10,6 % (September 2026) der AI-Bot-Anfragen auf Cloudflare Radar. Training sank von seinem Juni-Höchststand von 52,6 % auf 44,0 %, zurück auf das Januar-Niveau.
- GPTBot: 12,6 % (Januar) → 6,2 % (September) des AI-Bot-Traffics. OAI-SearchBot hat sich mehr als verdoppelt, 1,7 % → 3,6 %. Im Januar kam etwa jede fünfte AI-Bot-Anfrage von OpenAI aus seinen Such- oder Nutzer-Agents, im September waren es 45 %.
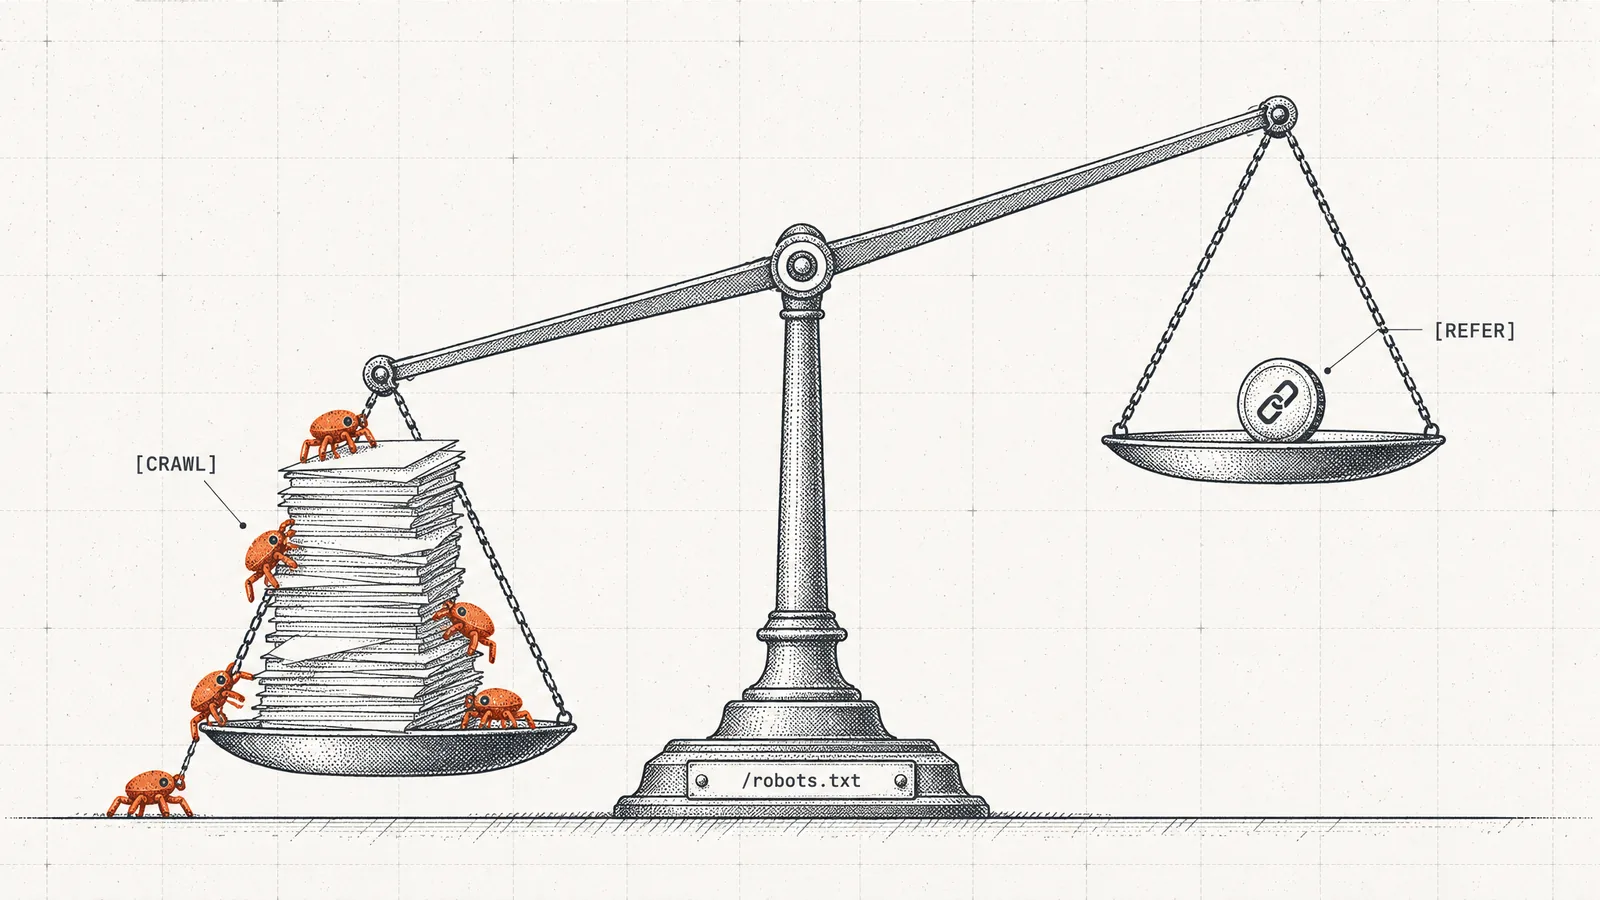
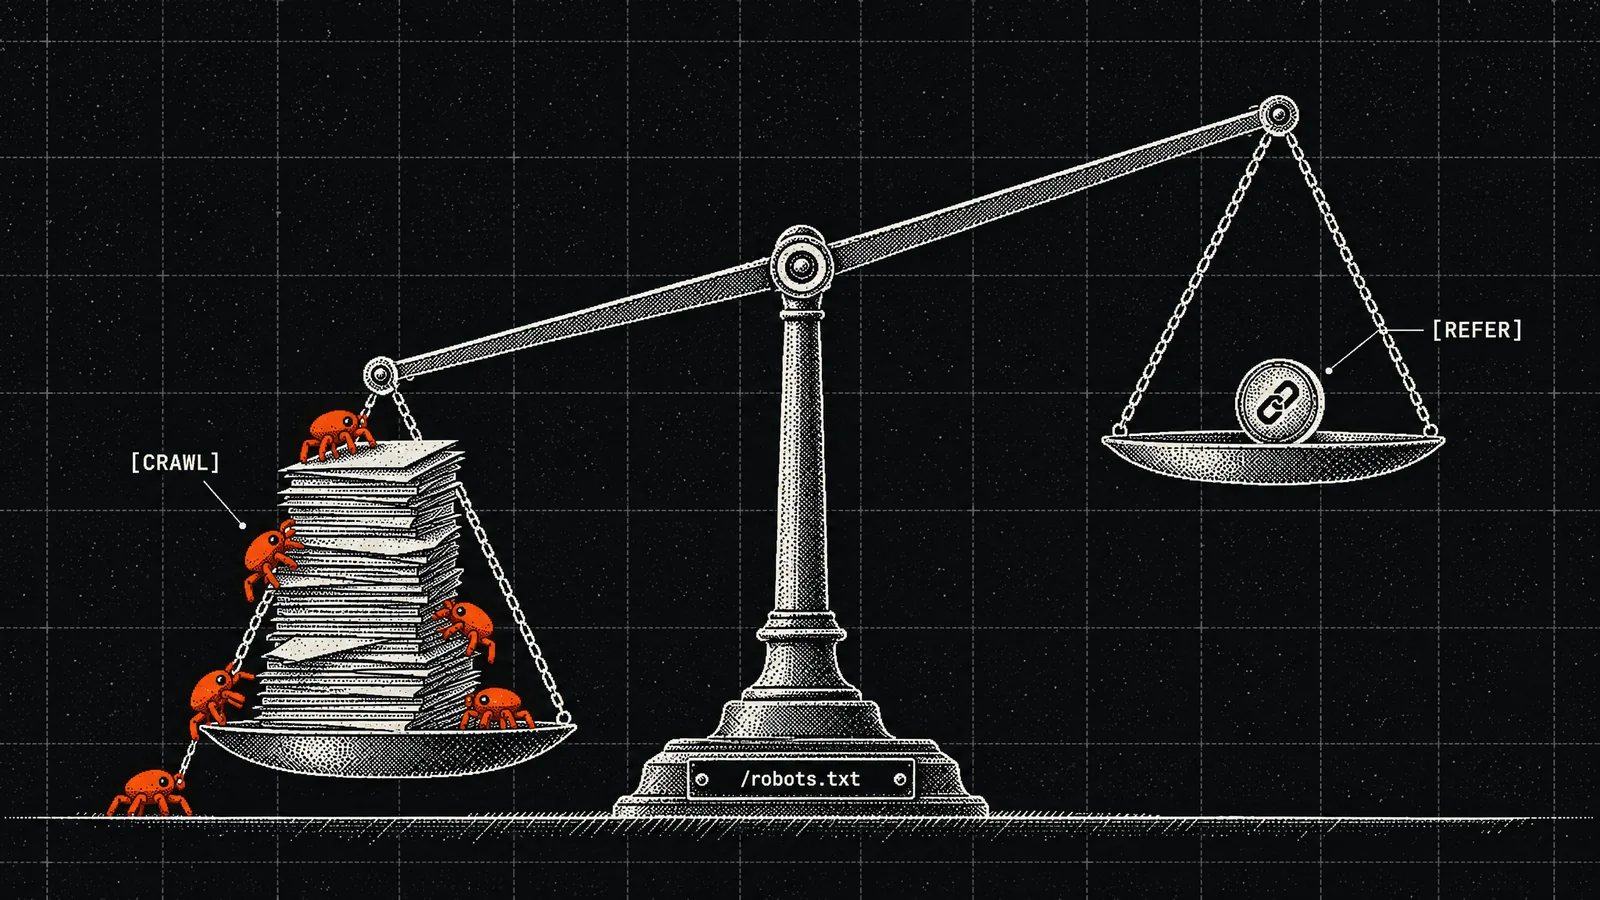
- PerplexityBot: 0,3 % (Juli) → 2,2 % (September) des AI-Bot-Traffics, während Perplexitys Crawl-to-Refer-Verhältnis von 296:1 auf 2.373:1 stieg. Es crawlt mehr und schickt weniger zurück.
- ClaudeBot pendelte sich im September bei 12,0 % ein, gleichauf mit 11,8 % im Januar. Meta-ExternalAgent (13,1 %) hält seit August Platz 2 hinter Googlebot.
- 38,1 % der Crawler-Anfragen wurden im September 2026 mit einem 4xx-Status beantwortet, der höchste Monat des Jahres (33,1 % im Januar). Bewusste 403-Antworten allein machten 23,8 % aus.
- In Radars Scan von 4.261 robots.txt-Dateien vom 5. Oktober 2026 wird GPTBot in 703 Dateien genannt und in 546 gesperrt. Such-Agents werden etwa so oft erlaubt wie gesperrt: OAI-SearchBot ist in 316 Dateien erlaubt und in 279 gesperrt.
Wer betrieb im September 2026 den meisten Bot-Traffic?
Google betreibt nach wie vor mehr Bot-Traffic als alle anderen, und der Abstieg ist gestoppt. Sein Anteil am globalen Bot-Traffic auf Cloudflare Radar rutschte von 37,3 % im Januar 2026 auf einen Tiefstwert von 26,6 % im August und stieg im September wieder leicht auf 27,3 %. Meta ist mit 17,5 % klar die Nummer 2. Die beiden Labs, die die AI-Schlagzeilen bestimmen, gingen den umgekehrten Weg: Anthropic fiel von 12,7 % im Juni auf 7,3 %, OpenAI von 9,2 % im Januar auf 4,7 %, die Hälfte seines Ausgangswerts.
| Betreiber | Panel, Jan. | Panel, Juli* | Radar, Jan. | Radar, Juli | Radar, Aug. | Radar, Sep. |
|---|
| Google | 42,6 % | 30,8 % | 37,3 % | 27,1 % | 26,6 % | 27,3 % |
| Meta | 13,5 % | 12,2 % | 15,1 % | 14,6 % | 18,6 % | 17,5 % |
| Anthropic | 14,1 % (Juni) | 12,7 % | 12,7 % (Juni) | 11,0 % | 8,5 % | 7,3 % |
| OpenAI | 9,7 % | 7,4 % | 9,2 % | 6,5 % | 5,7 % | 4,7 % |
| Microsoft | 7,2 % | 6,2 % | 6,5 % | 5,5 % | 5,1 % | 5,5 % |
| Amazon | 3,2 % | 4,3 % | 3,6 % | 4,7 % | 4,8 % | 4,3 % |
* Die Panel-Zahlen für Juli 2026 umfassen den 1.–21. Juli (Teilmonat); für August und September wurde das Panel nicht neu ausgewertet. Radar: Anteil am globalen Bot-Traffic nach Betreiber, Kalendermonate 2026. Anthropic taucht in beiden Reihen ab Juni 2026 auf, als Radar seine Bot-Taxonomie erweiterte (unser Panel folgt dieser Taxonomie), deshalb zeigt die erste Spalte Juni.
Im Mittelfeld steckt die eigentliche Veränderung des Jahres. Apple hat seinen Anteil verdreifacht, von 1,5 % des globalen Bot-Traffics im Januar auf 4,5 % im September, und Applebot ist inzwischen der viertgrößte AI-Bot auf Radar. Der Crawler von Ahrefs, ein SEO-Tool und kein AI-Lab, liegt bei 4,4 %, gleichauf mit Amazon. Die Crawl-Landschaft zersplittert weiter: Kein einzelner Betreiber hat die zehn Punkte aufgefangen, die Google in diesem Jahr abgegeben hat.
Auf den Websites, die wir tracken, fiel Googles Betreiber-Anteil von 42,6 % im Januar auf 30,8 % im Juli (1.–21. Juli), dieselbe Kurve von einem höheren Startpunkt; der wahrscheinlichste Grund ist unser B2B-Schwerpunkt, denn Softwareunternehmen leben von der Google-Suche. Das Volumen hinter all diesen Anteilen wächst weiter: Laut Daten von Cloudflare Radar, die CEO Matthew Prince am 3. Juni 2026 geteilt hat, erzeugen Bots inzwischen 57,5 % des HTML-Traffics im Web.
📊In Zahlen: OpenAIs Anteil am globalen Bot-Traffic hat sich 2026 halbiert, von 9,2 % im Januar auf 4,7 % im September auf Cloudflare Radar. Meta (17,5 %) betreibt inzwischen mehr als dreimal so viel Bot-Traffic wie OpenAI.
Wer von den Betreibern auf einzelne Bots in unserem Panel hinunterzoomt, sieht die Streuung noch deutlicher. Googlebot allein stand im Januar 2026 für etwa 21 % aller Bot-Zugriffe in unserem Panel; bis Juli (1.–21. Juli) sank der Wert auf etwa 12,5 %. Im Juni und Juli war der zweitgrößte einzelne Bot, den wir sahen, gar kein Such-Crawler. Es war Claude-User, der Agent, der eine Seite abruft, weil ein Mensch Claude eine Frage gestellt hat, mit rund 10–11 % der Bot-Zugriffe. Woher dieser Agent-Traffic kommt, unterscheidet sich je nach Region stark; das haben wir in unserer Auswertung zum AI-Bot-Traffic nach Land kartiert.
Such-Bots legen zu, GPTBot halbiert sich: Was hat sich im September bewegt?
Die Schlagzeile im September ist ein Jobwechsel, keine Größenänderung. OpenAIs Trainings-Crawler schrumpft, während sein Such-Crawler wächst. GPTBot fiel von 12,6 % des globalen AI-Bot-Traffics im Januar 2026 auf 6,2 % im September, knapp die Hälfte. OAI-SearchBot, der Seiten für die Suchantworten von ChatGPT abruft, stieg von 1,7 % auf 3,6 %. Nimmt man ChatGPT-User dazu, den Live-Abrufer, hat sich OpenAIs Mix gedreht: Im Januar kamen 19 % seiner AI-Bot-Anfragen aus Such- oder Nutzer-Agents, im September 45 %.
| AI-Bot-User-Agent | Jan. | Juni | Juli | Aug. | Sep. |
|---|
| Googlebot | 38,5 % | 25,2 % | 24,5 % | 23,0 % | 24,5 % |
| Meta-ExternalAgent | 10,9 % | 10,2 % | 12,5 % | 14,1 % | 13,1 % |
| ClaudeBot | 11,8 % | 19,8 % | 16,5 % | 11,9 % | 12,0 % |
| Applebot | 2,5 % | 6,0 % | 6,5 % | 6,6 % | 8,5 % |
| Bingbot | 9,9 % | 7,8 % | 8,9 % | 7,5 % | 7,6 % |
| Amazonbot | 4,8 % | 5,4 % | 6,0 % | 8,1 % | 6,2 % |
| GPTBot | 12,6 % | 9,4 % | 9,7 % | 8,3 % | 6,2 % |
| OAI-SearchBot | 1,7 % | 1,5 % | 1,6 % | 3,1 % | 3,6 % |
| Bytespider | 3,5 % | 7,6 % | 5,3 % | 3,7 % | 3,3 % |
| Claude-SearchBot | 0,7 % | 3,3 % | 3,5 % | 3,7 % | 2,7 % |
| PerplexityBot | 0,2 % | 0,2 % | 0,3 % | 1,1 % | 2,2 % |
| ChatGPT-User | 1,3 % | 1,3 % | 1,3 % | 2,5 % | 1,5 % |
Cloudflare Radar, Anteil am globalen AI-Bot-Traffic nach User-Agent, Kalendermonate 2026. Die August-Spalte der Juli-Ausgabe umfasste den 1.–28. August; hier stehen die Werte für den ganzen Monat.
PerplexityBot ist der schnellste Aufsteiger der Tabelle. Er lag von Januar bis Juni bei 0,2 % des AI-Bot-Traffics, erreichte im Juli 0,3 %, dann 1,1 % im August und 2,2 % im September, mehr als das Sechsfache seines Juli-Anteils in zwei Monaten. Seine Referrals hielten nicht Schritt; der Abschnitt zum Crawl-to-Refer-Verhältnis weiter unten zeigt das in Zahlen.
Der Sommer-Ausschlag von ClaudeBot ist endgültig vorbei. Er verdoppelte sich zwischen Mai und Juni (9,9 % auf 19,8 %), kühlte im Juli auf 16,5 % ab und liegt seit August bei 11,9–12,0 %, auf dem Januar-Niveau. Das war ein großer Re-Crawl-Zyklus, keine dauerhafte Veränderung des Appetits. Claude-SearchBot, der Zitations-Crawler von Anthropic, sank im September von 3,7 % auf 2,7 %.
📈Trend im Blick: Googlebot hielt im Januar 2026 38,5 % des globalen AI-Bot-Traffics und im September 24,5 %. In denselben Monaten stieg Applebot von 2,5 % auf 8,5 % und PerplexityBot von 0,2 % auf 2,2 %. Die Crawl-Landschaft löst sich Schritt für Schritt von einem einzigen dominanten Bot.
Auch der Long Tail hat sich schnell gefüllt. Bravebot, der AI-Such-Crawler von Brave, und der Grok-Agent von xAI lagen bis August nahe null und kamen im September auf jeweils etwa 0,8 % des AI-Bot-Traffics. ShapBot (1,5 %), YouBot (1,4 %), MistralAI-User (0,8 %), cohere-ai (0,8 %) und CCBot (0,8 %) sind seit Juli alle um ein Mehrfaches gewachsen. Die meisten dieser Neuzugänge sind Such- oder Assistenz-Agents, also dieselbe Verschiebung, die auch die Zweck-Daten unten zeigen.
⚠️Häufiger Fehler: GPTBot und OAI-SearchBot sind verschiedene Bots mit verschiedenen Aufgaben, genau wie ClaudeBot und Claude-SearchBot. Der erste jedes Paares sammelt Trainingsdaten, der zweite ruft Seiten ab, um sie in Antworten zu zitieren. Eine robots.txt-Regel, die beide sperrt, kostet dich Zitate, nicht nur Trainings-Präsenz.
Was machen AI Crawler mit deinen Inhalten?
Weniger Training, mehr Suche. Crawling zu Trainingszwecken erreichte im Juni 2026 mit 52,6 % der globalen AI-Bot-Anfragen seinen Höchststand und fiel bis September auf 44,0 %, zurück auf die 43,9 % vom Januar. Crawling zu Suchzwecken entwickelte sich umgekehrt und stieg in sieben der acht Monate seit Januar: 2,6 % im Januar, 5,6 % im Juli, 8,4 % im August, 10,6 % im September. Rechnet man die Abrufe durch Nutzeraktionen dazu, erreichte die Abruf-Seite des AI-Crawlings im September 13,7 %, nach 4,8 % im Januar.
| Zweck | Panel, Jan. | Panel, Juli* | Radar, Jan. | Radar, Juli | Radar, Aug. | Radar, Sep. |
|---|
| Training | 39,1 % | 46,1 % | 43,9 % | 50,7 % | 48,2 % | 44,0 % |
| Suche | 8,3 % | 12,4 % | 2,6 % | 5,6 % | 8,4 % | 10,6 % |
| Nutzeraktion | 2,1 % | 2,5 % | 2,2 % | 2,6 % | 4,7 % | 3,1 % |
| Gemischter Zweck | 50,0 % | 38,3 % | 50,9 % | 39,9 % | 37,1 % | 40,5 % |
| Nicht angegeben | k. A. | k. A. | 0,5 % | 1,2 % | 1,6 % | 1,8 % |
* Die Panel-Zahlen für Juli 2026 umfassen den 1.–21. Juli (Teilmonat); in den Panel-Spalten bleibt Crawling ohne angegebenen Zweck der kleine Rest. Radar: globale Anteile nach Crawl-Zweck, Kalendermonate 2026, abgerufen am 10. Oktober 2026.
Vergleiche Panel und Radar hier nach der Richtung, nicht nach dem Niveau. Cloudflare hat seine Klassifizierung der Crawl-Zwecke nach unserer Juli-Ausgabe überarbeitet: Radars Juli 2026 zeigt jetzt 50,7 % Training und 5,6 % Suche, wo es bei unserer Veröffentlichung am 28. August 44,7 % und 11,6 % waren. Die Anteile für gemischten Zweck und Nutzeraktionen haben sich nicht verändert, also wurden rund sechs Punkte von Suche zu Training umgebucht. Unsere Panel-Zahlen wurden vor dieser Überarbeitung klassifiziert. In beiden Fassungen ist die Richtung dieselbe: Training stieg bis in den Sommer, und Suche legt seitdem zu.
Wenn August und September Bestand haben, verschiebt sich AI-Crawling vom Einsammeln hin zum Abrufen, und Abrufen ist die Art von Crawl, aus der ein Zitat werden kann, genau das, was unsere Answer Engine Insights zählen.
💡Schneller Einblick: Crawling zu Suchzwecken machte im September 2026 weltweit 10,6 % der AI-Bot-Anfragen aus, viermal so viel wie die 2,6 % im Januar auf Cloudflare Radar. Ein Such-Crawl ist ein Abruf, den eine Answer Engine zitieren kann; ein Trainings-Crawl nicht.
Auch was die Bots abrufen, verschiebt sich. Der HTML-Anteil an den AI-Bot-Anfragen fiel von 75,6 % im Januar auf 68,9 % im September, während sich reiner Text mehr als verdoppelte, von 4,0 % auf 9,2 %. JavaScript (6,5 %), JSON (6,1 %) und Bilder (5,0 %) teilen sich den Großteil des Rests. Radar schlüsselt die Kategorie „reiner Text“ nicht nach Dateien auf, daher können wir nicht sagen, wie viel des Anstiegs auf robots.txt, llms.txt oder etwas anderes entfällt.
Training macht immer noch den größeren Teil des Crawls aus. Cloudflares Bericht vom Juni 2026 ergab, dass inzwischen 52 % der Crawler-Anfragen dem AI-Training dienen, nach 22 % im Frühjahr 2025. Der Anstieg begann schon früher. Die Benchmarks 2026 von HUMAN Security maßen über das Kalenderjahr 2025 ein Wachstum des AI-Trainings-Crawler-Volumens um 136 %, mit dem steilsten Anstieg zwischen August und Oktober jenes Jahres.
Wenn du Dokumentation, Blog- oder Changelog-Inhalte veröffentlichst, kannst du davon ausgehen, dass knapp die Hälfte deiner AI-Bot-Zugriffe noch Trainings-Crawls sind und dass der Such-Anteil der wachsende Teil ist. Das erhöht den Einsatz bei der Entscheidung zwischen Erlauben und Sperren weiter unten.
Welche Branchen crawlen AI Crawler am stärksten?
Drei Branchen ziehen etwa zwei Drittel des gesamten Crawler-Traffics auf sich, und das ist die stabilste Tabelle in diesem Report: Der September sieht fast genauso aus wie der Juli.
| Branche | Panel, Juli* | Radar, Juli | Radar, Sep. |
|---|
| Shopping | 21,2 % | 25,7 % | 25,7 % |
| Internet & Telekommunikation | 21,6 % | 20,6 % | 20,9 % |
| Computer & Elektronik | 24,0 % | 19,1 % | 19,4 % |
| News & Medien | 7,9 % | 9,0 % | 8,3 % |
| Glücksspiel | 4,0 % | 6,9 % | 6,3 % |
| Finanzen | 2,7 % | 2,6 % | 2,8 % |
| Games | 1,3 % | 2,2 % | 2,3 % |
* Anteil der Crawler-Zugriffe in unserem Panel, Juli 2026 (1.–21. Juli). Radar: Anteil am globalen Crawler-Traffic nach Branche der Website, Kalendermonate 2026.
Shopping führt weltweit mit 25,7 % des Crawler-Traffics, im Juli wie im September. In unserem Panel lag im Juli Computer & Elektronik mit 24,0 % vorn, Shopping war mit 21,2 % Dritter; der hohe Anteil an Software-Kunden erklärt den Tausch. Die Zahl, die jeder Shop-Betreiber kennen sollte, ist die Last pro Website: Shopping-Sites sind etwa 20 % der Websites, die wir tracken, zogen aber 21,2 % der Crawler-Zugriffe auf sich. Ein Shop trägt also mehr Crawler-Traffic pro Website als ein Softwareunternehmen. Glücksspiel verliert das ganze Jahr über an Gewicht, von 7,6 % des globalen Crawler-Traffics im Januar auf 6,3 % im September; professionelle Dienstleistungen stiegen von 2,7 % auf 3,0 %.
📌Profi-Tipp: Wenn du einen Onlineshop betreibst, ist Crawler-Management keine Option, sondern Pflicht. Shopping ist die am stärksten gecrawlte Branche im globalen Web (25,7 % des Crawler-Traffics auf Cloudflare Radar, September 2026) und zog in unserem Panel mehr Zugriffe pro Website auf sich als jedes andere Segment.
Wie oft werden AI Crawler blockiert?
Jeden Monat öfter. Im September 2026 wurden weltweit 38,1 % der Crawler-Anfragen auf Cloudflare Radar mit einem 4xx-Status beantwortet, der höchste Monat des Jahres, und der Anteil sauberer 2xx-Antworten fiel auf 46,6 %. Die 4xx-Quote lag im Januar bei 33,1 %, im Juli bei 35,8 % und im August bei 37,8 %. Auf den Websites, die wir überwachen, lag die Juli-Quote (1.–21. Juli) bei 36,4 %, weniger als einen Punkt über Radar.
| Status (global) | Jan. | Juli | Aug. | Sep. |
|---|
| 200 ausgeliefert | 49,3 % | 45,7 % | 44,2 % | 44,8 % |
| 403 verboten | 20,1 % | 21,4 % | 23,9 % | 23,8 % |
| 404 nicht gefunden | 7,5 % | 8,1 % | 8,5 % | 8,4 % |
| 429 Rate-Limit | 4,4 % | 5,2 % | 4,3 % | 4,8 % |
| 301/302 Weiterleitung | 11,4 % | 12,9 % | 13,0 % | 12,1 % |
| Alle 4xx | 33,1 % | 35,8 % | 37,8 % | 38,1 % |
Cloudflare Radar, Anteil der globalen Crawler-Anfragen nach Antwortstatus, Kalendermonate 2026. Gezeigt sind die größten Codes; 204, 304, 503 und weitere Codes bilden den Rest.
Die Mauer besteht vor allem aus 403-Antworten. Bewusste Ablehnungen machten im September weltweit 23,8 % aller Crawler-Anfragen aus, fast dreimal so viel wie die 404-Fehler (8,4 %). Die Ablehnungen sind also eine Entscheidung, keine kaputten Links. Rate-Limiting hatte seinen Moment im Juni, als 429-Antworten auf 7,2 % der globalen Crawler-Anfragen hochschnellten; seitdem liegen sie zwischen 4,3 % und 5,2 %.
🔑Kernaussage: Mehr als jede dritte Crawler-Anfrage weltweit (38,1 % im September 2026) wird auf Cloudflare Radar mit einem 4xx-Status abgewiesen, nach 33,1 % im Januar. 403-Antworten allein machen inzwischen 23,8 % der Crawler-Anfragen aus.
robots.txt ist die Absichtsebene über diesen Statuscodes. In 4.257 robots.txt-Dateien von Top-Domains, die unser Audit-Crawler am 20. Juli 2026 geparst hat, waren die vier am häufigsten genannten Agents allesamt AI Crawler. Cloudflare Radars globaler Scan von 4.261 Dateien vom 5. Oktober 2026 zeigt dieselben vier in derselben Reihenfolge:
| Agent | Unser Crawl (20. Juli) | Radar (5. Okt.) |
|---|
| GPTBot | 773 | 703 |
| ClaudeBot | 629 | 611 |
| Google-Extended | 578 | 563 |
| CCBot | 568 | 521 |
Gezählt werden robots.txt-Dateien, die den Agent nennen. Unsere: 4.257 Dateien von Top-Domains, geparst am 20. Juli 2026. Radar: 4.261 Dateien von Top-Domains, geparst am 5. Oktober 2026.
Googlebot, der Agent, an den sich diese Dateien zwei Jahrzehnte lang gerichtet haben, wird in Radars Oktober-Scan in 412 Dateien genannt, seltener als acht Agents aus der AI-Ära, darunter PerplexityBot, ChatGPT-User und OAI-SearchBot. Und die Dateien unterscheiden zunehmend, welche Aufgabe ein Bot hat. Trainings-Crawler werden weit häufiger gesperrt als erlaubt; Such- und Nutzer-Agents werden etwa so oft erlaubt wie gesperrt:
| Agent | Aufgabe | Gesperrt in | Erlaubt in |
|---|
| GPTBot | Training | 546 | 338 |
| ClaudeBot | Training | 473 | 296 |
| CCBot | Training | 452 | 179 |
| Bytespider | Training | 408 | 105 |
| Meta-ExternalAgent | Training | 329 | 129 |
| PerplexityBot | Suche | 348 | 344 |
| ChatGPT-User | Nutzeraktion | 328 | 305 |
| OAI-SearchBot | Suche | 279 | 316 |
| Claude-SearchBot | Suche | 184 | 164 |
| Googlebot | Suche | 314 | 290 |
Cloudflare-Radar-Scan der robots.txt-Dateien, 5. Oktober 2026: Dateien mit mindestens einer Disallow- (bzw. Allow-)Regel für den Agent, von 4.261 geparsten. Eine Datei kann beides enthalten. Die Sperren für Googlebot sind fast alle partiell: Nur 27 Dateien sperren ihn vollständig, gegenüber 360 bei GPTBot.
Wie viel Traffic schicken AI Crawler zurück?
Das Crawl-to-Refer-Verhältnis ist die Anzahl der Seiten, die ein Bot-Betreiber für jeden Referral-Besuch abruft, den sein Produkt zurückschickt. Es ist das fairste einzelne Maß dafür, ob ein Crawler ein Tauschgeschäft ist oder eine Entnahme, und im September bewegten sich die Betreiber, die die meisten für „Suche“ halten, in entgegengesetzte Richtungen.
| Betreiber | Panel, Juli* | Radar, Jan. | Radar, Juli | Radar, Aug. | Radar, Sep. |
|---|
| Perplexity | 263:1 | 112:1 | 296:1 | 822:1 | 2.373:1 |
| Anthropic | 2.363:1 | 47.779:1 | 1.914:1 | 910:1 | 549:1 |
| OpenAI | 179:1 | 1.309:1 | 256:1 | 424:1 | 341:1 |
| Mistral | 6.021:1 | 23:1 | 29.944:1 | keine Referrals | keine Referrals |
| Microsoft | 35:1 | 36:1 | 36:1 | 37:1 | 40:1 |
| Google | 4:1 | 4,7:1 | 4,8:1 | 5,2:1 | 4,7:1 |
| DuckDuckGo | 3:1 | 1,4:1 | 2,4:1 | 1,8:1 | 3,6:1 |
* Gecrawlte Seiten pro Referral-Sitzung in unserem Panel, Juli 2026 (1.–21. Juli). Radar: globales Crawl-to-Refer-Verhältnis nach Betreiber, Kalendermonate 2026. Für August und September weist Radar das Verhältnis von Mistral als undefiniert aus: Crawling ohne messbare Referrals.
Perplexity ist die Entnahme-Geschichte des Septembers. Sein Verhältnis stieg von 112:1 im Januar auf 2.373:1 im September, und das meiste davon geschah nach Juli, in denselben Monaten, in denen der Crawl-Anteil von PerplexityBot auf das Sechsfache wuchs. Anthropic bewegte sich weiter in die andere Richtung: Auf Radar fiel es von 47.779:1 im Januar auf 549:1 im September (in unserem Panel waren es im Januar etwa 57.000:1 und im Juli 2.363:1). OpenAI hat sich seit Juli im Bereich von 250–450:1 eingependelt. Von Mistral kommen seit August überhaupt keine messbaren Referrals mehr. Die klassischen Suchmaschinen liegen konstruktionsbedingt bei 2:1 bis 5:1, und unter ihnen lohnt sich ein Blick auf Baidu: 3,7:1 im Januar, 39,6:1 im September. Die vollständige Analyse der Extraktionslücke, Monat für Monat, steht in unserem Deep Dive zum Crawl-to-Refer-Verhältnis.
Solltest du AI Crawler erlauben oder sperren?
Erlaube die Bots, die dich zitieren und für Nutzer abrufen; behandle reine Trainings-Bots als Geschäftsentscheidung. Das ist das ganze Gerüst. Die September-Daten schärfen nur beide Seiten davon.
| Bot-Klasse | Beispiele | Entscheidung |
|---|
| Suche / Zitate | OAI-SearchBot, PerplexityBot | Erlauben |
| Nutzeraktion | ChatGPT-User, Claude-User | Erlauben |
| Nur Training | GPTBot, CCBot, Bytespider | Im Einzelfall |
Eine Pauschalregel wäre einfacher als „im Einzelfall“, aber genau mit Pauschalregeln sperren Websites am Ende die Bots, die ihnen Leser schicken.
- Wer Such- und Nutzeraktions-Bots sperrt (einschließlich Claude-SearchBot), entfernt seine Seiten aus den Antworten, die diese Engines schreiben: Du verlierst Zitate und Referrals und gewinnst nichts, was den ganzen Sinn von Answer Engine Optimization zunichtemacht. Mit Such-Crawling bei 10,6 % der AI-Bot-Anfragen und weiter steigend ist das der wachsende Teil des Crawls. Die Referral-Ökonomie ist dünn, aber real. Forschung der Stanford Graduate School of Business aus dem Jahr 2025, zusammengefasst in der Analyse von Arc XP, bezifferte die Klickraten aus AI-Chatbots auf 0,33 % und aus AI-Suchmaschinen auf 0,74 %, gegenüber 8,6 % für die Google-Suche. Dünn, aber ein Zitat hat einen Markenwert, den eine Klickrate nicht erfasst.
- Reine Trainings-Bots sind die eigentliche Verhandlung. GPTBot in seiner Trainingsrolle, CCBot und Bytespider nehmen Korpus-Wert mit und schicken auf keiner messbaren Zeitskala etwas zurück. Training macht weltweit noch 44,0 % der AI-Bot-Anfragen aus, ein pauschales „alles erlauben“ verschenkt also viel.
- Die Antwort ist nicht endgültig, in beide Richtungen. Anthropics Verhältnis fiel von 47.779:1 im Januar auf 549:1 im September, ein Bot, den man im Januar besser sperrte, kann im September also erlaubenswert sein. Perplexity ging im selben Zeitraum von 112:1 auf 2.373:1. Prüfe die Entscheidung monatlich, pro Betreiber.
🚩Warnsignal: Wer Claude-SearchBot, OAI-SearchBot oder ChatGPT-User sperrt, entfernt seine Seiten aus den Antworten, die diese Engines schreiben. Du verlierst Zitate und Referrals, während die Trainingsdebatte ohne dich weitergeht.
AI-Crawler-Verzeichnis: Wer betreibt was?
Die Entscheidung funktioniert nur, wenn du die Bots auseinanderhalten kannst, und die Namensgebung hilft nicht: drei Agents von Anthropic, drei von OpenAI, drei von Google, jeder mit einer anderen Aufgabe. Die Rollen unten stammen aus dem Bot-Verzeichnis von Cloudflare Radar mit Stand 10. Oktober 2026, in einfache Worte übersetzt (Radars AI_CRAWLER ist ein Trainings-Crawler; AI_SEARCH und SEARCH_ENGINE_CRAWLER sind Such-Crawler; AI_ASSISTANT ruft Seiten für Nutzeraktionen ab).
| Agent | Betreiber | Rolle |
|---|
| GPTBot | OpenAI | Trainings-Crawler |
| OAI-SearchBot | OpenAI | Such-Crawler |
| ChatGPT-User | OpenAI | Abruf für Nutzeraktion |
| ClaudeBot | Anthropic | Trainings-Crawler |
| Claude-SearchBot | Anthropic | Such-Crawler |
| Claude-User | Anthropic | Abruf für Nutzeraktion |
| Meta-ExternalAgent | Meta | Trainings-Crawler |
| Amazonbot | Amazon | Trainings-Crawler |
| Applebot | Apple | Such-Crawler |
| GoogleOther | Google | Trainings-Crawler |
| Google-CloudVertexBot | Google | Trainings-Crawler |
| Bravebot | Brave | Such-Crawler |
| Grok Bot | xAI | Abruf für Nutzeraktion |
| MistralAI-User | Mistral AI | Abruf für Nutzeraktion |
Quelle: Bot-Verzeichnis von Cloudflare Radar (radar/bots), 10. Oktober 2026. Die robots.txt-Compliance-Angabe des Verzeichnisses haben wir bewusst weggelassen: Sie stimmte bei unserer Gegenprüfung nicht mit der veröffentlichten Dokumentation jedes Betreibers überein. Lies also die Crawler-Seite des jeweiligen Betreibers, bevor du dich darauf verlässt, dass eine Regel eingehalten wird.
Wenn du unterscheidest, dann präzise. Unser robots.txt-Guide erklärt Direktiven pro Agent, CDN-Tools wie Cloudflares AI Crawl Control bieten dieselben Erlauben-/Sperren-Hebel pro Bot, und unser llms.txt-Guide behandelt die vorgeschlagene Begleitdatei (die Verbreitung ist real, eine messbare Wirkung noch nicht).
So erstellst du diesen Report für deine eigene Website
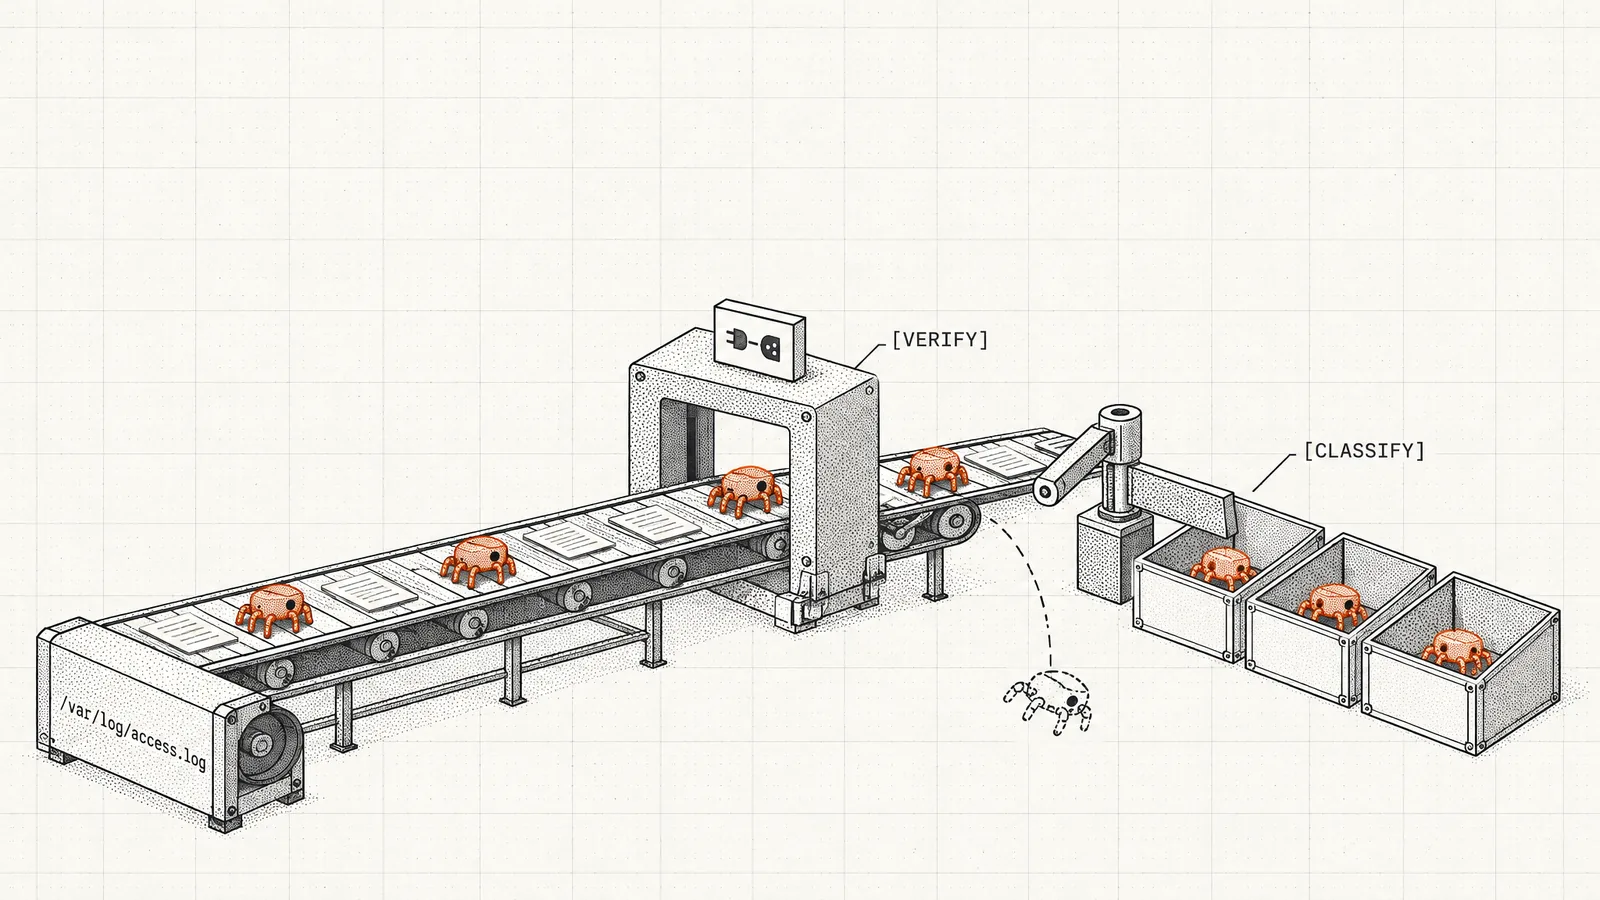
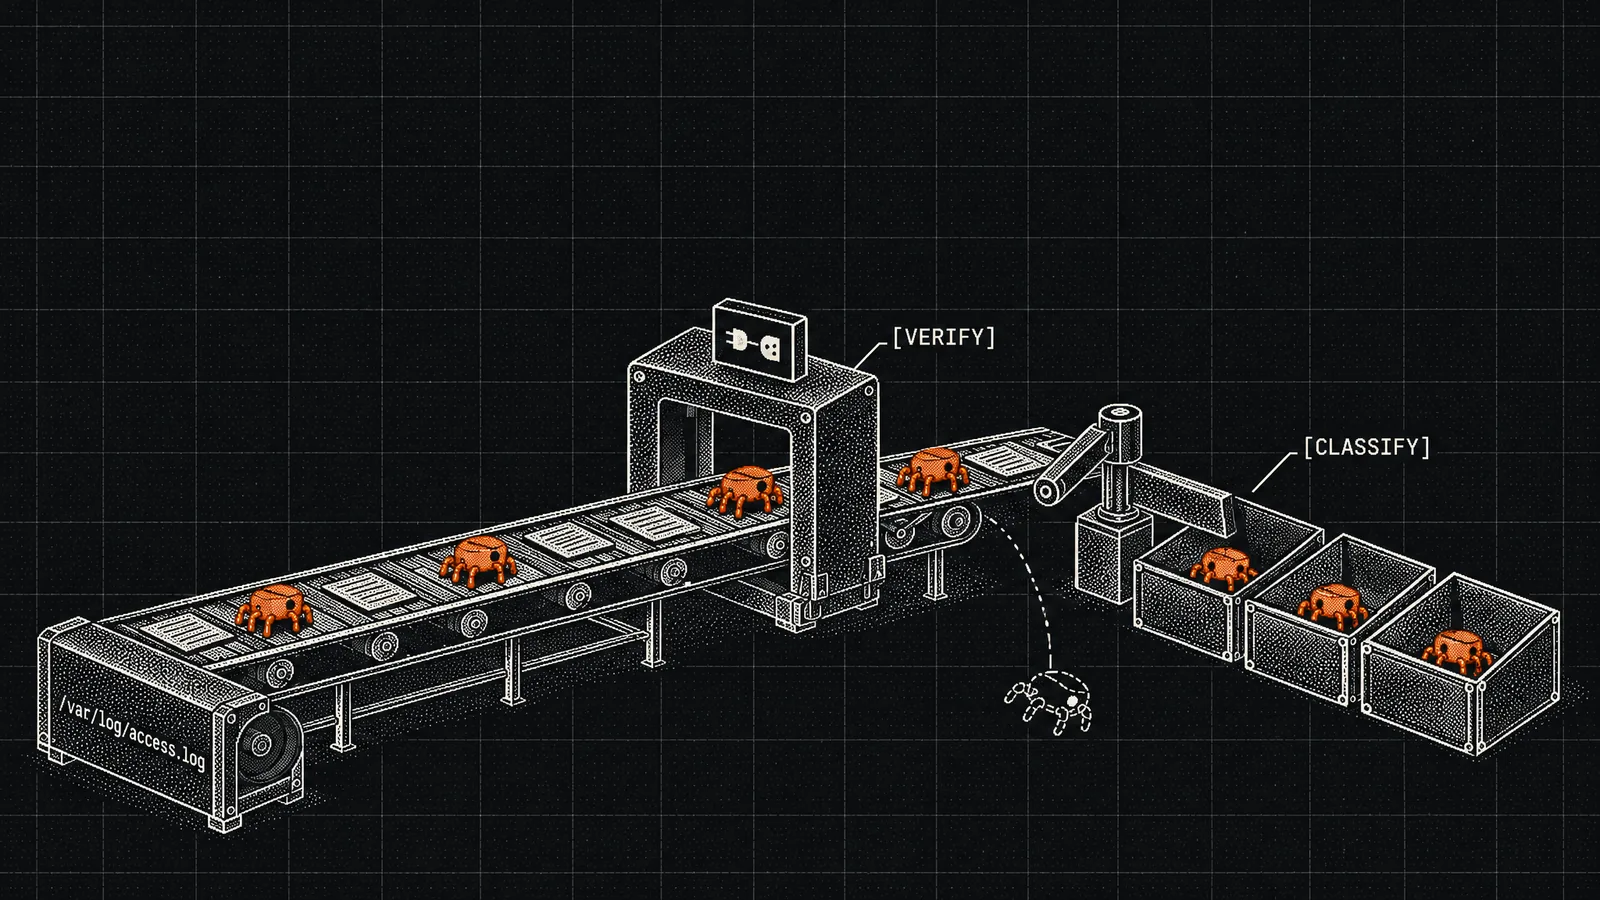
Jede Zahl in diesem AI Crawler Report stammt aus einer wiederholbaren Pipeline: Logs rein, User-Agents verifiziert und zugeordnet, Zwecke klassifiziert, Sperren und Referrals gezählt. Denselben Report kannst du für eine Website an einem Nachmittag erstellen. Kein globales Dashboard sagt dir, was deine Seiten crawlt.
- Zieh dir 30 Tage Roh-Access-Logs von deinem Origin oder CDN. Du brauchst vier Felder pro Anfrage: User-Agent, IP, Pfad und Statuscode.
- Erst verifizieren, dann zählen. Prüfe angebliche Zugriffe von Googlebot, GPTBot oder ClaudeBot per Reverse-DNS oder gegen die veröffentlichten IP-Bereiche des Betreibers. Dieser Schritt wird am häufigsten übersprungen, und gefälschte Agents sind so verbreitet, dass das Überspringen den Rest des Reports unbemerkt wertlos macht.
- Ordne User-Agents den Betreibern zu und halte die Rollen getrennt. ClaudeBot, Claude-SearchBot und Claude-User gehören alle zu Anthropic, haben aber verschiedene Aufgaben; dein Report sollte sie nie zusammenlegen. Das Verzeichnis oben ist die Ausgangskarte.
- Klassifiziere den Zweck jedes Bots (Training, Suche, Nutzeraktion) anhand der Dokumentation des Betreibers, berechne dann deinen Zweck-Mix und vergleiche ihn mit den Radar-Zahlen oben.
- Berechne deine Sperrquote und dein Referral-Verhältnis. Den Anteil verifizierter Bot-Anfragen pro Agent, die mit 4xx beantwortet werden, abgeglichen mit dem, was deine robots.txt eigentlich vorsieht. Wo beides auseinanderläuft, stirbt das Crawl-Budget. Segmentiere dann die Sitzungen, die von chatgpt.com, perplexity.ai und Co. kommen, um dein eigenes Crawl-to-Refer-Verhältnis zu erhalten.
- Wiederhole das monatlich und lies Veränderungen, nicht Niveaus. Ein einzelner Monat ist eine Randnotiz. Der Ausschlag und das Abkühlen von ClaudeBot bedeuteten nur etwas, weil Mai, Juni, Juli und August nebeneinanderstanden, und Perplexitys Versechsfachung zeigt sich nur vor seinem flachen ersten Halbjahr.
📌Profi-Tipp: Vertrau nie einem User-Agent-String allein. Verifiziere angebliche Bot-Zugriffe per Reverse-DNS-Lookup oder gegen die veröffentlichten IP-Bereiche des Betreibers, bevor sie in deinen Report eingehen. Gefälschte Agents blähen sonst jede Zahl darin auf.
Genau diese Pipeline automatisiert SEOmator Agent Analytics. Es ist das Instrument hinter jeder Panel-Zahl in diesem Beitrag: Es klassifiziert AI-Bot-Zugriffe, Zwecke, Sperrquoten und Referrals über 500+ Websites und 50M+ getrackte Nutzer pro Monat. Wenn du lieber klein anfangen willst, findet ein kostenloses SEO-Audit robots.txt- und Crawlability-Probleme in etwa einer Minute, und unser GEO-Audit-Tool prüft, wie deine Seiten für die Answer Engines lesbar sind, die diese Crawler beliefern.
Frühere Ausgaben
Die Juli-Ausgabe (auf Englisch veröffentlicht am 28. August 2026) führte mit ClaudeBot. Der Trainings-Crawler von Anthropic hatte seinen Anteil am AI-Bot-User-Agent-Mix in unserem Panel zwischen Mai und Juni 2026 mehr als verdoppelt und dann einen Teil wieder abgegeben:
| AI-Bot-User-Agent | Mai | Juni | Juli* |
|---|
| Googlebot | 27,7 % | 26,0 % | 25,5 % |
| ClaudeBot | 10,7 % | 22,4 % | 19,2 % |
| Meta-ExternalAgent | 13,8 % | 10,7 % | 12,7 % |
| GPTBot | 11,5 % | 9,2 % | 9,9 % |
| Bytespider | 9,7 % | 7,1 % | 5,4 % |
| Claude-SearchBot | 2,5 % | 3,7 % | 3,9 % |
* Anteil am AI-Bot-User-Agent-Mix in unserem Panel; Juli 2026 umfasst den 1.–21. Juli (Teilmonat).
Global verlief dieselbe Kurve eine Stufe tiefer: ClaudeBot stieg auf Cloudflare Radar von 9,9 % des AI-Bot-Traffics im Mai auf 19,8 % im Juni und lag im Juli bei 16,5 %, während Meta-ExternalAgent sich von 10,2 % auf 12,5 % erholte. Die Ausgabe deutete die Form als auslaufenden großen Re-Crawl-Zyklus, nicht als dauerhaften Sprung. August und September bestätigten das: ClaudeBot lag bei 11,9 % und 12,0 %, dem Januar-Niveau, und Meta-ExternalAgent übernahm im August mit 14,1 % Platz 2.
Methodik und Quellen
Globale Daten. Quelle: Cloudflare Radar – radar/bots/summary/bot_operator, radar/ai/bots/summary/user_agent, radar/ai/bots/summary/crawl_purpose, radar/ai/bots/summary/content_type, radar/bots/crawlers/summary/response_status, radar/bots/crawlers/summary/response_status_category, radar/bots/crawlers/summary/vertical, radar/bots/crawlers/summary/crawl_refer_ratio, radar/robots_txt/top/user_agents/directive, radar/bots (radar.cloudflare.com), abgerufen am 10. Oktober 2026. Jede globale Zahl ist ein Kalendermonat 2026, Januar bis September. Der robots.txt-Scan ist auf den 5. Oktober 2026 datiert (4.261 geparste Dateien); die Zahlen für Sperren und Erlaubnisse nutzen den Direktiven-Filter, und eine Datei kann beides enthalten. Radar-Anteile sind prozentual normalisiert; wir zitieren Rangfolgen und Anteile, keine absoluten Anfragevolumen. Zwei Hinweise zu Überarbeitungen: Radar hat die Crawl-Zwecke nach unserer Juli-Ausgabe neu klassifiziert (der Juli zeigt jetzt 50,7 % Training und 5,6 % Suche, gegenüber 44,7 % und 11,6 % bei unserer Veröffentlichung), und die August-Zahlen der Juli-Ausgabe umfassten den 1.–28. August, während diese Ausgabe ganze Monate verwendet.
Panel-Daten. Alle Zahlen zum „Panel“ und zu den „Websites, die wir tracken“ stammen aus SEOmator Agent Analytics: 500+ Websites und 50M+ getrackte Nutzer pro Monat, Januar bis Juli 2026. Das Panel ist auf das Business-Web ausgerichtet (etwa 60 % B2B-SaaS, 20 % E-Commerce, 20 % gemischt), Panel-Anteile beschreiben also diese Population, nie das Web insgesamt. Die Panel-Zahlen für Juli 2026 sind unvollständig und umfassen den 1.–21. Juli, und für August und September wurde das Panel nicht neu ausgewertet, seine Spalten enden also im Juli. Die Crawl-Zwecke im Panel wurden vor Radars Überarbeitung klassifiziert; vergleiche sie mit Radar deshalb nach der Richtung, nicht nach dem Niveau. Anthropic erscheint in beiden Datensätzen ab Juni 2026 als eigener Betreiber, als Radar seine Bot-Klassifizierung erweiterte (unser Panel folgt derselben Taxonomie). Die robots.txt-Zahlen stammen von unserem Audit-Crawler: 4.257 robots.txt-Dateien von Top-Domains, geparst am 20. Juli 2026.
Rhythmus. Dieser Report wird monatlich unter dieser URL aktualisiert. Frühere Ausgaben werden mit jedem neuen Monat auf der Seite archiviert, damit Vergleiche von Monat zu Monat nachprüfbar bleiben.
Häufig gestellte Fragen
Was ist ein AI Crawler Report?
Ein AI Crawler Report zeigt, wie AI-Bots auf eine Website oder das Web insgesamt zugreifen: Traffic-Anteil nach Crawler und Betreiber, Mix der Crawl-Zwecke (Training, Suche, Nutzeraktion), Sperrquoten, robots.txt-Direktiven und Crawl-to-Refer-Verhältnisse. Monatliche Ausgaben sind wichtig, weil sich die Anteile schnell bewegen: Auf Cloudflare Radar hat ClaudeBot 2026 seinen Anteil am AI-Bot-Traffic in einem einzigen Monat verdoppelt, und PerplexityBot wuchs in zwei Monaten auf das Sechsfache.
Was hat sich bei der AI-Crawler-Aktivität im September 2026 verändert?
Such-Crawling ist gewachsen, und OpenAIs Trainings-Crawler ist geschrumpft. Crawling zu Suchzwecken erreichte auf Cloudflare Radar weltweit 10,6 % der AI-Bot-Anfragen, nach 5,6 % im Juli, während Training von seinem Juni-Höchststand von 52,6 % auf 44,0 % fiel. GPTBot sank auf 6,2 % des AI-Bot-Traffics, während OAI-SearchBot auf 3,6 % stieg und PerplexityBot 2,2 % erreichte. Die Ablehnungsquoten erreichten einen Höchststand für 2026: 38,1 % der Crawler-Anfragen wurden mit 4xx beantwortet.
Ist ChatGPT ein Webcrawler?
Nein. ChatGPT ist eine Anwendung; das Crawling läuft über separate User-Agents von OpenAI. GPTBot sammelt Trainingsdaten, OAI-SearchBot versorgt Suche und Zitate, und ChatGPT-User ruft eine Seite live ab, wenn ein Nutzer danach fragt. Jeder lässt sich in der robots.txt einzeln ansprechen, du kannst also in ChatGPT zitierbar bleiben und trotzdem dem Modelltraining widersprechen.
Welches sind 2026 die wichtigsten AI-Crawler-Bots?
Auf Cloudflare Radar waren im September 2026 die größten AI-Bot-User-Agents Googlebot (24,5 %), Meta-ExternalAgent (13,1 %), ClaudeBot (12,0 %), Applebot (8,5 %), Bingbot (7,6 %), Amazonbot (6,2 %), GPTBot (6,2 %) und OAI-SearchBot (3,6 %), dahinter Bytespider, Claude-SearchBot und PerplexityBot. Die Reihenfolge ändert sich von Monat zu Monat.
Welche AI Crawler sollte ich sperren und welche erlauben?
Erlaube Such- und Nutzeraktions-Bots (OAI-SearchBot, Claude-SearchBot, ChatGPT-User, Claude-User, PerplexityBot): Sie bringen Zitate und Referrals. Entscheide getrennt über reine Trainings-Crawler (GPTBot in seiner Trainingsrolle, CCBot, Bytespider), die Korpus-Wert mitnehmen, ohne Traffic zurückzuschicken. Pauschale Sperren entfernen dich komplett aus AI-Antworten; pauschales Erlauben verschenkt Trainingswert, ohne dass du es merkst.
Wie stoppe ich AI Crawler, die ich nicht will?
Nenne jeden Agent in der robots.txt mit einer Disallow-Regel; die großen AI Crawler halten sich daran. robots.txt ist eine Bitte, keine Mauer, also kombiniere sie mit Durchsetzung auf Server- oder CDN-Ebene (4xx-Antworten, Bot-Management-Regeln, Tools wie Cloudflares AI Crawl Control) für Agents, die Direktiven ignorieren. Die steigenden 403-Quoten auf Cloudflare Radar (23,8 % der globalen Crawler-Anfragen im September 2026) zeigen, dass viele Websites das bereits so durchsetzen.
Wie tracke ich AI-Crawler-Bots auf meiner Website?
Werte Server- oder CDN-Logs nach bekannten AI-User-Agents aus, verifiziere sie per Reverse-DNS oder gegen veröffentlichte IP-Bereiche und gruppiere sie dann nach Betreiber und Zweck. Beobachte monatlich vier Zahlen: Anteil pro Bot, Zweck-Mix, 4xx-Sperrquote und AI-Referrals. Eine Analytics-Ebene, die AI-Bots automatisch klassifiziert, wie das Agent-Analytics-Panel hinter diesem Report, ersetzt die manuelle Pipeline.
Schadet das Sperren von AI Crawlern der Sichtbarkeit in AI Overviews?
Googles AI Overviews basieren auf der normalen Googlebot-Indexierung. Wer Google-Extended sperrt (den Opt-out für das Gemini-Training), verschwindet also nicht aus den AI Overviews; wer Googlebot selbst sperrt, schon. Das größere Risiko sind alte Pauschalregeln gegen Trainings-Crawler, die auch Zitations-Bots wie OAI-SearchBot oder Claude-SearchBot erfassen und dich unbemerkt aus den Antworten anderer Engines entfernen.
Der Crawler von Meta liegt jetzt vorn. ClaudeBot schnellte auf Cloudflare Radar im Juni auf 19,8 % des AI-Bot-Traffics hoch und pendelte sich im August bei 11,9 % und im September bei 12,0 % ein, auf seinem Januar-Niveau. Meta-ExternalAgent übernahm im August Platz 2 hinter Googlebot (14,1 %) und hielt ihn im September (13,1 %).
Was zeigt ein AI Crawler Report von Cloudflare?
Cloudflare Radars AI Insights zeigen globale, prozentual normalisierte Anteile: Bot-Traffic nach Betreiber, AI-Bot-Traffic nach User-Agent, Mix der Crawl-Zwecke, abgerufene Inhaltstypen, Antwortcodes, Crawler-Traffic nach Branche, Crawl-to-Refer-Verhältnisse und welche Agents robots.txt-Dateien am häufigsten nennen. Das beschreibt das Internet insgesamt. Kombiniere es mit deinen eigenen Logdaten oder einer Panel-Ansicht: Ein globaler Durchschnitt kann dir nicht sagen, was deine Website crawlt oder warum.