Eine robots.txt ist eine einfache Textdatei im Stammverzeichnis einer Website, die Crawlern sagt, welche URLs sie abrufen dürfen. Sie steuert das Crawling, nicht die Indexierung: Eine gesperrte URL kann trotzdem bei Google erscheinen. 2026 ist KI ihre wichtigste Aufgabe. Bei den Top-1.000-Domains sperren 21,0 % der robots.txt-Dateien mindestens einen KI-Crawler komplett.
Diese Zahl ist neu, und sie ist der Grund für die Überarbeitung dieses Leitfadens. Die Syntax hat sich seit Jahren nicht geändert, wohl aber das Publikum Ihrer Regeln: Eine robots.txt spricht heute neben Googlebot auch Trainings-Crawler, KI-Such-Crawler und von Nutzern ausgelöste Agenten an, und jeder davon liest seine eigene Zeile.
Was ist eine Robots.txt-Datei?
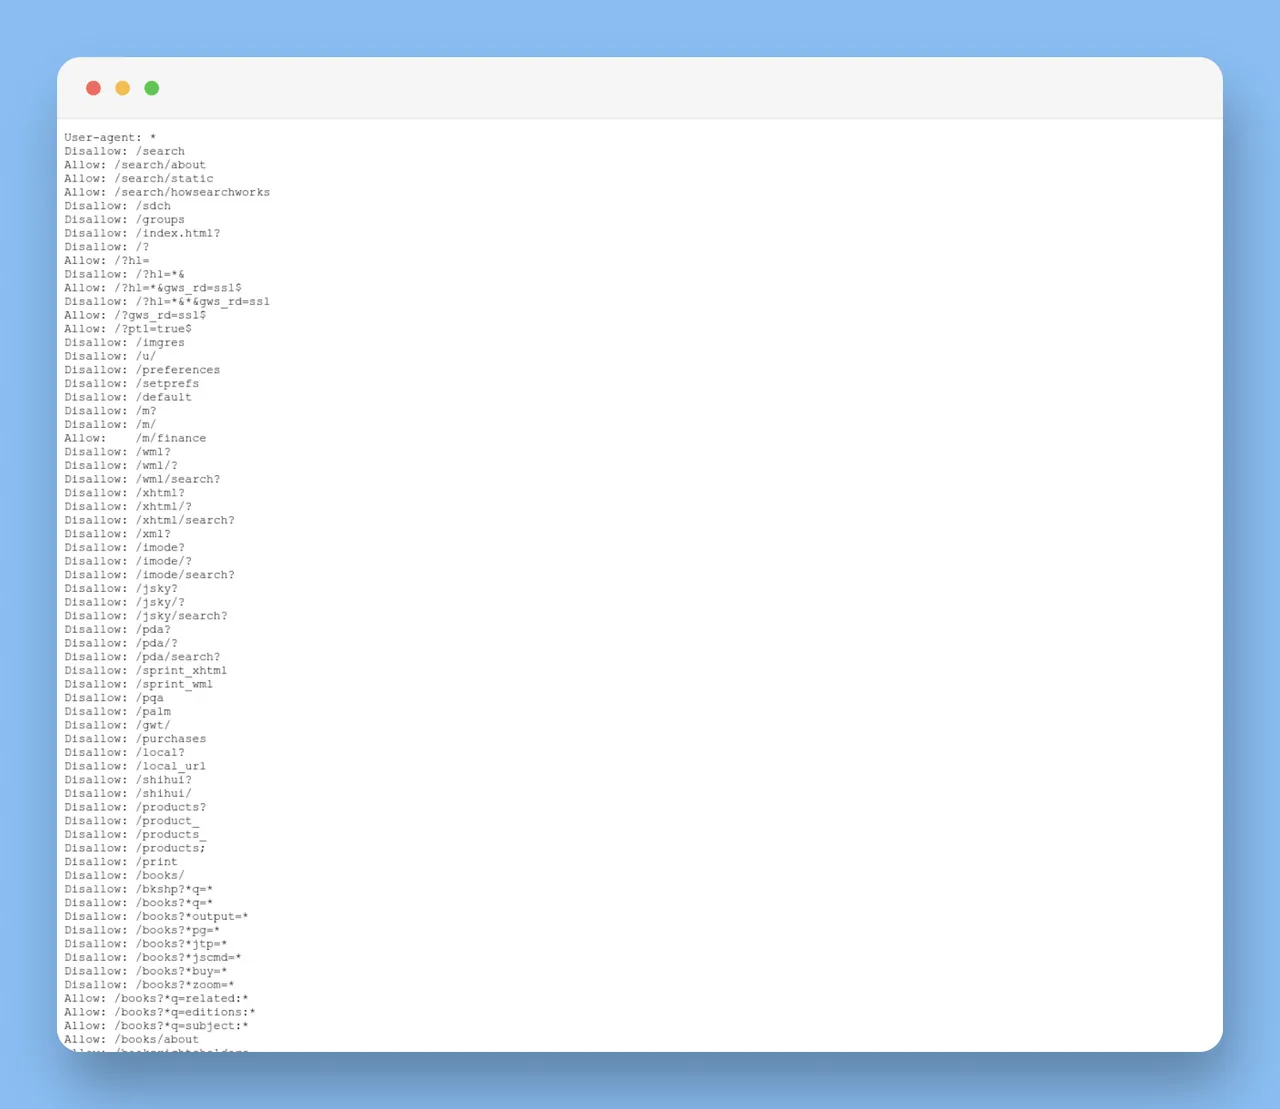
Robots.txt ist eine einfache Textdatei, die sich im Stammverzeichnis einer Website befindet. Ihre Hauptfunktion besteht darin, Web-Robots (auch Crawler oder Spider genannt) anzuweisen, wie sie mit der Website interagieren sollen. Das darin verwendete „Robots Exclusion Protocol“, 2022 als RFC 9309 standardisiert, bietet eine Reihe von Anweisungen, die Bots mitteilen, welche URLs sie abrufen dürfen und welche nicht.
Betrachten Sie die Datei als Wegweiser, nicht als Schloss. Seriöse Crawler lesen und befolgen sie, doch der RFC stellt selbst klar, dass ihre Regeln keine Form der Zugriffsberechtigung sind. Jeder kann Ihre robots.txt lesen, und wer sie ignoriert, kann Ihre Seiten trotzdem abrufen.
Warum ist Robots.txt wichtig?
Vielleicht fragen Sie sich jetzt, warum es für Sie als Marketer oder SEO-Experte wichtig ist, die robots.txt-Datei zu kennen. Hier sind die wichtigsten Gründe:
Crawling steuern: Robots.txt hält Crawler von URLs fern, die ihre Zeit verschwenden, etwa interne Suchergebnisse, Filterseiten und Warenkorbseiten, und verweist sie auf Ihre Sitemap.
Crawl-Budget-Optimierung: Eine robots.txt-Datei kann Ihr Crawl-Budget optimieren, indem sie verhindert, dass Suchmaschinen-Bots Anfragen auf irrelevante URLs verwenden. Googles eigener Leitfaden zum Crawl-Budget richtet sich an große Websites (1 Million+ Seiten) und sich schnell ändernde mittelgroße Websites (10.000+ Seiten); auf einer kleinen Website ist das Crawl-Budget selten der Engpass.
KI-Crawler steuern: In der robots.txt entscheiden Sie, welche KI-Unternehmen Ihre Seiten für das Modelltraining nutzen dürfen und welche sie abrufen dürfen, um Fragen in der KI-Suche zu beantworten. Das sind getrennte Crawler mit getrennten Regeln, mehr dazu weiter unten.
Denken Sie daran, dass eine fehlerhafte robots.txt Suchmaschinen-Bots komplett vom Crawlen Ihrer Website abhalten kann, was Ihrer Suchmaschinenoptimierung schadet. Ein vergessenes Disallow: / aus einer Staging-Umgebung ist der teuerste robots.txt-Fehler, den ich kenne, weil sichtbar nichts kaputtgeht, bis der Traffic sinkt.
Wie funktioniert eine robots.txt-Datei?
Das Funktionsprinzip einer robots.txt-Datei ist recht einfach. Wenn ein seriöser Bot eine URL abrufen möchte, prüft er zuerst die robots.txt-Datei im Stammverzeichnis dieses Hosts. Erlauben die Regeln die URL, crawlt er sie. Ob die Seite anschließend indexiert wird, entscheidet die Suchmaschine später und getrennt davon.
Die Struktur einer robots.txt-Datei besteht in der Regel aus „User-agent“, gefolgt von „Disallow“- oder „Allow“-Anweisungen.
- User-agent: Der Web-Crawler, für den die Regel gilt.
- Disallow: Die Anweisung, die dem User-agent sagt, eine bestimmte URL nicht zu crawlen.
- Allow: Die Anweisung, die einem User-agent erlaubt, eine URL zu crawlen (wird hauptsächlich verwendet, um den Zugriff auf Unterverzeichnisse in einem ansonsten gesperrten Verzeichnis zu gewähren).
Die Namen der Anweisungen bleiben immer Englisch. Eine Zeile wie „Nicht zulassen: /ordner/“ versteht kein Crawler.
Weitere Informationen finden Sie in Googles Leitfaden zum Erstellen einer robots.txt.
⚠️Häufiger Fehler: Mit robots.txt eine Seite aus Google heraushalten zu wollen. Laut Google ist robots.txt kein Mechanismus dafür. Eine gesperrte URL kann über Links trotzdem indexiert werden; nutzen Sie noindex oder einen Passwortschutz.
Terminologie und Syntax verstehen
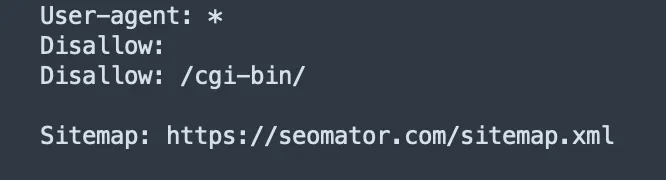
Um robots.txt gut einzusetzen, müssen Sie ihr Vokabular verstehen: die Terminologie und Syntax der robots.txt-Datei.
Die User-agent-Anweisung
Der User-agent ist das Herzstück jeder robots.txt-Datei. Alle Regeln darunter gelten für den Crawler, den er nennt.
Ein User-agent ist im Zusammenhang mit einer robots.txt-Datei das Produkt-Token eines Crawlers. Zu den bekannten User-agents gehören Googlebot für die Google-Suche, Bingbot für Bing sowie GPTBot und ClaudeBot für die Trainings-Crawler von OpenAI und Anthropic.
Die User-agent-Zeile in der robots.txt-Datei wird so geschrieben:
User-agent: [Name-des-Crawlers]
Wenn Sie zum Beispiel den Crawler von Google ansprechen möchten, sieht der User-agent so aus:
User-agent: Googlebot
Wenn Sie hingegen möchten, dass alle Bots den Anweisungen folgen, verwenden Sie ein Sternchen (*):
User-agent: *
Ein Crawler befolgt die spezifischste Gruppe, die ihn nennt, und ignoriert den Rest. Schreiben Sie also eine Gruppe User-agent: GPTBot, liest GPTBot Ihre Regeln unter User-agent: * gar nicht mehr.
Die Disallow-Anweisung
Nachdem der User-agent festgelegt ist, folgen die Regeln. An dieser Stelle kommt die Disallow-Anweisung ins Spiel.
Die Disallow-Anweisung teilt dem Bot mit, welche Pfade er nicht crawlen soll. Wenn Sie Crawler daran hindern wollen, eine bestimmte Seite oder einen Ordner abzurufen, verwenden Sie Disallow.
So sieht eine Disallow-Anweisung aus:
Disallow: /page-link/
Die Allow-Anweisung
Manchmal wollen wir bestimmte Ausnahmen zulassen, und da kommt die Allow-Regel gerade recht.
Allow ist besonders nützlich, wenn Sie den Zugriff auf ein bestimmtes Unterverzeichnis oder eine Seite in einem ansonsten gesperrten Verzeichnis erlauben wollen.
Betrachten Sie das folgende Beispiel:
User-agent: *
Disallow: /ordner/
Allow: /ordner/wichtige-seite.html
In diesem Fall gilt die allgemeine Regel, dass /ordner/ nicht abgerufen werden darf, aber es gibt eine Ausnahme: wichtige-seite.html darf gecrawlt werden.
Die Sitemap-Anweisung
Diese Anweisung erleichtert es Suchmaschinen, Ihre Sitemap zu finden. Sitemap-URLs werden in einzelne Zeilen geschrieben, denen „Sitemap“ vorangestellt wird:
Sitemap: https://www.ihrewebsite.de/sitemap.xml
Sie ist die am häufigsten genutzte optionale Zeile: 68,7 % der robots.txt-Dateien in unserer Top-1.000-Prüfung enthalten eine.
Platzhalter für präzisere Regeln
Sie können das Platzhalterzeichen * in Disallow- und Allow-Anweisungen verwenden, um eine beliebige Zeichenfolge abzudecken. Zum Beispiel:
Disallow: /*? sperrt alle URLs, die ein ? enthalten.
Mit '$' das Ende einer URL kennzeichnen
Wenn Sie einen bestimmten Dateityp abgleichen oder Mehrdeutigkeiten in URLs vermeiden möchten, setzen Sie das Dollarzeichen ($) an das Ende der URL. Zum Beispiel sperrt Disallow: /*.jpg$ alle .jpg-Dateien.
Mit der Raute (#) Kommentare hinzufügen
Rautensymbole können für Kommentare verwendet werden, auf die Sie später zurückgreifen können. Zum Beispiel:
# Sperrt alles unter /private/
Disallow: /private/
Achten Sie auf den abschließenden Schrägstrich. Regeln gleichen URL-Präfixe ab, Disallow: /private würde also auch /private-events/ oder /private.html sperren: jeden Pfad, der zufällig mit denselben Zeichen beginnt.
Die Funktion einer robots.txt-Datei
Nachdem Sie nun wissen, was eine robots.txt-Datei ist und wie ihre Syntax funktioniert, geht es darum, wofür sie in der Praxis gut ist.
Crawl-Budget optimieren
Das Crawl-Budget ist die Anzahl der URLs, die ein Suchmaschinen-Crawler auf Ihrer Website crawlen kann und will. Es effizient zu nutzen, ist vor allem auf großen Websites wichtig, auf denen Crawler nicht alles schaffen.
Zu viele unwichtige URLs können die Warteschlange verstopfen und es Crawlern erschweren, die wichtigen Seiten zu erreichen. Die robots.txt-Datei teilt diesen Crawlern mit, welche Bereiche sie überspringen können, und spart so Crawl-Budget für wichtige Seiten.
Crawler aus unwichtigen Bereichen fernhalten
Oft gibt es auf einer Website URLs, die für die Funktion notwendig, in der Suche aber nutzlos sind: Verwaltungsseiten, interne Suchergebnisse, Warenkorb- und Checkout-Schritte. Wenn Sie sie sperren, konzentrieren sich Crawler auf Inhalte, die ranken sollen.
Doppelte Inhalte sind die Ausnahme. Sperren Sie Duplikate nicht: Ein Crawler, der eine Seite nicht abrufen kann, sieht auch ihr Canonical-Tag nicht, sodass die Signale des Duplikats nie zusammengeführt werden. Verweisen Sie Duplikate stattdessen per Canonical-Tag auf die bevorzugte URL, wie unser Leitfaden zu Canonical-Problemen erklärt.
Ressourcen vor Crawlern verstecken, nicht vor Menschen
Einige Dateien sind nur für den internen Gebrauch bestimmt, etwa interne Dokumente, Exporte oder Bilder. Eine gut aufgebaute robots.txt-Datei kann Google und andere seriöse Crawler davon abhalten, solches Material abzurufen. Sie kann aber nicht garantieren, dass die URLs aus den Suchergebnissen verschwinden, denn Google kann eine gesperrte URL aufführen, die es über Links findet.
Es ist sehr wichtig zu beachten, dass robots.txt keine Sicherheitsmaßnahme ist. Die Datei ist öffentlich, wer darin einen sensiblen Pfad nennt, macht ihn also erst bekannt. Für sichere Inhalte sollten Sie immer einen angemessenen Passwortschutz oder andere Sicherheitsmaßnahmen verwenden.
🚩Warnsignal: Eine Zeile wie Disallow: /admin-backup/ zeigt jedem Besucher, ob Mensch oder Bot, genau, wo er suchen muss. Schützen Sie sensible Bereiche per Anmeldung, statt sie in einer öffentlichen Datei zu nennen.
Wenn Sie mehr erfahren möchten, lesen Sie Googles offizielle Dokumentation zum Blockieren der Indexierung mit noindex.
Robots.txt und KI-Crawler
KI-Unternehmen betreiben nicht nur einen Crawler. Die meisten haben getrennte Crawler für das Modelltraining, für ihre KI-Suchergebnisse und für Seiten, die ein Nutzer vom Assistenten öffnen lässt, und jeder liest seine eigene User-agent-Zeile. Wer einen davon sperrt, sperrt nicht die anderen.
Um zu sehen, wie Websites das tatsächlich nutzen, haben wir am 26. September 2026 die robots.txt der 1.000 höchstplatzierten Domains der Tranco-Liste abgerufen. 514 davon lieferten eine gültige Datei (viele Top-Domains sind CDNs und APIs ohne Website). So oft wird jeder Crawler genannt und so oft für die gesamte Website gesperrt:
| Token | Betreiber | Zweck | Genannt | Gesperrt |
|---|
| GPTBot | OpenAI | Training | 25,3 % | 12,6 % |
| OAI-SearchBot | OpenAI | ChatGPT-Suche | 17,1 % | 4,7 % |
| ChatGPT-User | OpenAI | Nutzeranfragen | 19,1 % | 6,4 % |
| ClaudeBot | Anthropic | Training | 23,7 % | 13,2 % |
| Claude-SearchBot | Anthropic | Claude-Suche | 13,2 % | 5,4 % |
| Claude-User | Anthropic | Nutzeranfragen | 13,8 % | 6,8 % |
| Google-Extended | Google | Gemini-Training | 22,0 % | 10,5 % |
| PerplexityBot | Perplexity | Perplexity-Suche | 22,8 % | 9,3 % |
| CCBot | Common Crawl | Webarchiv | 22,8 % | 14,6 % |
| Bytespider | ByteDance | Crawler | 20,4 % | 15,0 % |
| Googlebot | Google | Google-Suche | 15,8 % | 0,2 % |
Quelle: SEOmator-Prüfung der robots.txt-Dateien der Tranco-Top-1.000-Domains, abgerufen am 26. September 2026; 514 Domains lieferten eine gültige Datei. „Gesperrt“ heißt komplett gesperrt: Die Gruppe des Bots sperrt / ohne Allow-Regeln. Die Zwecke der Crawler stammen aus der Dokumentation der jeweiligen Betreiber.
Insgesamt nennen 34,2 % dieser Dateien mindestens einen KI-Crawler, und 21,0 % sperren mindestens einen komplett. Weitere 7,4 % sperren alle Bots, die sie nicht namentlich nennen, per User-agent: * und Disallow: /.
📊In Zahlen: Bei den Top-1.000-Domains (26. September 2026) war GPTBot in 12,6 % der robots.txt-Dateien komplett gesperrt, OpenAIs Such-Crawler OAI-SearchBot dagegen nur in 4,7 %. Websites steigen aus dem Training aus und bleiben in der KI-Suche sichtbar.
Die Trennung zwischen Training und Suche ist das Muster, auf das es ankommt. ClaudeBot wird mehr als doppelt so oft komplett gesperrt wie Claude-SearchBot (13,2 % gegenüber 5,4 %), dasselbe Bild wie bei OpenAIs Crawler-Paar. Das ist gewollt, und die Betreiber unterstützen es: Laut OpenAI sind die beiden Einstellungen voneinander unabhängig, eine Website kann also OAI-SearchBot erlauben, um in der ChatGPT-Suche zu erscheinen, und GPTBot vom Training ausschließen.
Drei Details sorgen oft für Verwirrung:
- Google-Extended berührt die Google-Suche nicht. Google zufolge hat es keinen Einfluss darauf, ob eine Website in der Google-Suche erscheint, und ist kein Ranking-Signal. Es steuert das Gemini-Training und das Grounding. Da AI Overviews Teil der Google-Suche sind, nimmt Sie eine Sperre von Google-Extended nicht aus ihnen heraus.
- Von Nutzern ausgelöste Agenten befolgen robots.txt womöglich nicht. OpenAI schreibt, dass für ChatGPT-User robots.txt-Regeln unter Umständen nicht gelten, weil diese Aktionen von einem Nutzer ausgelöst werden. Betrachten Sie diese Tokens als Absichtserklärung, nicht als Mauer.
- Googlebot sperrt niemand. Nur eine Website der Stichprobe (0,2 %) sperrte ihn vollständig. Die KI-Regeln stehen neben den Google-Regeln, nicht an ihrer Stelle.
Wenn Sie aus dem Training heraus, in KI-Antworten aber sichtbar bleiben wollen, sieht ein gängiges Muster so aus:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /
Bevor Sie Trainings-Crawler sperren, wägen Sie ab, was sie zurückgeben. Unsere Analyse des Crawl-to-Refer-Verhältnisses misst, wie viele Seiten jeder KI-Betreiber pro gesendetem Besuch crawlt. Robots.txt ist außerdem nicht die einzige Datei, die KI-Systeme lesen; manche Websites ergänzen eine llms.txt.
🔑Kernaussage: Entscheiden Sie nach Zweck, nicht nach Unternehmen. Sperren Sie die Trainings-Tokens, die Sie ablehnen, und lassen Sie die Such-Tokens offen, wenn Sie in KI-Antworten zitiert werden wollen.
Was Google in der robots.txt ignoriert
Viele robots.txt-Zeilen bewirken bei Google nichts. Die folgenden Punkte stammen aus Googles robots.txt-Spezifikation, ergänzt um ihre Häufigkeit in unserer Top-1.000-Stichprobe:
| Regel | Was Google tut | Top 1.000 |
|---|
crawl-delay | Nicht unterstützt | noch 12,8 % |
noindex in robots.txt | Seit 1.9.2019 ignoriert | noch 0,4 % |
| Dateien über 500 KiB | Rest wird ignoriert | 0 Dateien |
| Caching | Bis zu 24 Std. gecacht | – |
| 4xx-Antwort (außer 429) | Wie keine Datei: alles erlaubt | – |
| 5xx-Antwort | 12 Std. kein Crawling | – |
Die noindex-Zeile kostet noch immer Traffic. Google kündigte 2019 an, die Unterstützung dafür einzustellen; eine Seite, die nur in der robots.txt auf „noindex“ steht, bleibt also indexierbar. Nutzen Sie stattdessen ein Robots-Meta-Tag oder einen X-Robots-Tag-Header.
Die Caching-Regel erklärt eine häufige Panik. Nachdem Sie einen robots.txt-Fehler behoben haben, kann Google bis zu einen Tag lang nach der alten Datei handeln. Erwarten Sie also nicht, dass das Crawling in der Minute nach dem Deployment wieder anläuft.
💡Schneller Einblick: 12,8 % der robots.txt-Dateien der Top-1.000-Domains setzen noch crawl-delay. Bing beachtet es, Google nicht; Google passt seine Crawling-Rate stattdessen an die Antworten Ihres Servers an.
Eine robots.txt-Datei erstellen und implementieren
Eine robots.txt-Datei ist in wenigen Minuten und ohne spezielle Werkzeuge erstellt. So gehen Sie vor.
Eine Datei anlegen und robots.txt nennen
Beginnen Sie mit einer neuen Textdatei. Das geht mit einem einfachen Texteditor wie Notepad (Windows) oder TextEdit (Mac). Sobald Sie ein leeres Dokument geöffnet haben, speichern Sie die Datei als robots.txt, komplett kleingeschrieben: URLs unterscheiden Groß- und Kleinschreibung, eine Datei namens Robots.txt oder ROBOTS.TXT wird unter /robots.txt also nicht gefunden.
Anweisungen zur robots.txt hinzufügen
Überlegen Sie, was Sie erlauben oder sperren wollen, und tragen Sie auf dieser Grundlage Anweisungen ein. Hier ein sehr einfaches Beispiel:
User-agent: *
Disallow: /private/
Dies weist alle Bots (wegen des Platzhalters *) an, nichts unter dem Verzeichnis /private/ zu crawlen.
Die robots.txt hochladen
Sobald Ihre robots.txt-Datei fertig ist, laden Sie sie in das Stammverzeichnis Ihrer Website hoch. Denken Sie daran, dass die robots.txt-Datei im Stammverzeichnis (z. B. www.ihrewebsite.de/robots.txt) liegen muss, damit Bots sie finden und erkennen.
So finden Sie eine robots.txt-Datei
Um zu sehen, ob eine robots.txt-Datei vorhanden ist, geben Sie einfach /robots.txt am Ende der Haupt-URL Ihrer Website in Ihren Browser ein.
Ihre robots.txt testen
Testen Sie Ihre robots.txt-Datei zum Schluss, um sicherzustellen, dass sie sperrt und erlaubt, was Sie beabsichtigt haben. Das Robots.txt-Tester-Tool von SEOmator prüft jede URL gegen die Live-Regeln einer Website. In der Google Search Console zeigt der robots.txt-Bericht (unter „Einstellungen“), welche robots.txt-Dateien Google gefunden hat, wann es sie zuletzt abgerufen hat und ob es Parsing-Fehler gibt. Er hat den alten robots.txt-Tester abgelöst.
📌Profi-Tipp: Testen Sie genau die URLs, auf die es Ihnen ankommt, nicht nur die Startseite. Eine Regel wie Disallow: /*? kann still jede paginierte oder gefilterte URL sperren, während die Startseite den Test besteht.
Best Practices für robots.txt
Mit den Grundlagen im Griff trennen ein paar Best Practices eine funktionierende robots.txt von einer, die unbemerkt Probleme verursacht.
Keine CSS- und JS-Dateien in der robots.txt sperren
Eine wichtige Regel ist, JavaScript- und CSS-Dateien nicht zu sperren. Diese Dateien braucht Googlebot, um Inhalt und Struktur Ihrer Website zu verstehen.
Früher galt das Sperren solcher Dateien nicht als Problem, doch Googlebot rendert Seiten heute ähnlich wie ein Browser und braucht deshalb Zugriff auf diese Dateien, um die Seite zu analysieren.
Wenn Sie CSS- oder JS-Dateien per Disallow sperren, kann das zu schlechteren Rankings führen, weil Google Ihr Seitenlayout oder die interaktiven Elemente möglicherweise nicht vollständig versteht.
Getrennte robots.txt-Dateien für verschiedene Subdomains verwenden
Wenn Ihre Website mehrere Subdomains hat, braucht jede Subdomain ihre eigene robots.txt-Datei. Haben Sie beispielsweise einen Blog auf einer Subdomain (wie blog.ihrewebsite.de), benötigen Sie eine separate robots.txt-Datei unter blog.ihrewebsite.de/robots.txt.
Das liegt daran, dass Crawler jeden Host als eigene Website behandeln. Wenn Sie dieses Detail übersehen, crawlen Bots unter Umständen Bereiche Ihrer Website oder lassen sie aus, entgegen Ihrer Absicht.
SEO-Best-Practices für robots.txt
Hier einige SEO-bezogene Best Practices für robots.txt:
Suchmaschinen nicht komplett sperren: Wenn Sie alle Suchmaschinen-Bots sperren, wird Ihre Website möglicherweise überhaupt nicht gecrawlt. Setzen Sie Disallow mit Bedacht und nur für Bereiche ein, die Crawler nicht brauchen.
Nicht zum Entfernen von URLs verwenden: Wenn eine URL aus den Suchergebnissen verschwinden soll, ist eine Sperre in der robots.txt nicht der richtige Weg, da die URL über externe Links weiterhin in den Ergebnissen erscheinen kann. Nutzen Sie stattdessen „noindex“, das Tool zum Entfernen von URLs oder einen Passwortschutz; unser Leitfaden zum Entfernen von URLs aus Google geht jede Methode durch.
Auf Ihre XML-Sitemap verlinken: Eine bewährte Praxis ist, in der robots.txt auf Ihre XML-Sitemap zu verweisen. Das erhöht die Wahrscheinlichkeit, dass Bots Ihre Sitemap finden und Ihre Seiten schneller entdecken.
Bewusst über KI-Crawler entscheiden: Schreiben Sie eigene Gruppen für die KI-Crawler, die Sie sperren oder erlauben wollen, statt sich auf User-agent: * zu verlassen, damit Ihre Absicht für jeden Betreiber eindeutig ist.
Mehr Details finden Sie in Googles Einführung in robots.txt.
Fazit: Die zentrale Rolle von robots.txt in der SEO
Sie kennen jetzt die Grundlagen: was robots.txt ist, wie ihre Syntax funktioniert, wofür sie gut ist, wie KI-Crawler sie lesen, was Google ignoriert und wie Sie die Datei erstellen und testen.
Vor- und Nachteile der Verwendung von robots.txt
Wie bei allen Optimierungsstrategien gibt es auch bei robots.txt Vorteile und potenzielle Fallstricke:
Vorteile:
- Kontrolle über das Crawling: robots.txt gibt Ihnen eine einfache Möglichkeit, Bots zu sagen, wohin sie auf Ihrer Website gehen sollen und wohin nicht.
- Crawl-Budget-Optimierung: Sie ermöglicht die effiziente Nutzung Ihres Crawl-Budgets, indem sie Crawler zu den wichtigen Bereichen Ihrer Website lenkt.
- KI-Opt-outs: Hier sagen Sie KI-Unternehmen, ob sie mit Ihren Inhalten trainieren oder sie für ihre Suchergebnisse abrufen dürfen.
Nachteile:
- Freiwillig, nicht durchgesetzt: Bots können Ihre robots.txt ignorieren, insbesondere bösartige Bots, die Ihre Website nach Schwachstellen durchsuchen. RFC 9309 stellt klar, dass ihre Regeln keine Zugriffsberechtigung sind.
- Kann Crawling-Probleme verursachen: Bei falscher Konfiguration können Sie Bots versehentlich vom Crawlen Ihrer Website abhalten.
Die Auswirkungen von robots.txt auf Crawl-Budget und SEO
Eine gut aufgebaute robots.txt-Datei hilft Suchmaschinen, ihr Crawling auf die Bereiche Ihrer Website zu richten, die es verdienen. Auf einer großen Website kann das beschleunigen, wie schnell neue und aktualisierte Seiten entdeckt werden; auf einer kleinen Website besteht ihre wichtigste SEO-Aufgabe darin, nichts Wichtiges zu sperren.
Wohin sich robots.txt entwickelt
Robots.txt war fast dreißig Jahre lang eine inoffizielle Konvention, bevor RFC 9309 sie 2022 standardisierte. Der Druck kommt heute von KI. Die Liste der KI-Crawler-Tokens wächst jedes Jahr, und Websites reagieren: Ein Drittel der Dateien der Top-1.000-Domains nennt bereits mindestens einen KI-Crawler.
Zwei neuere Signale stehen daneben. Manche Websites ergänzen Content-Signal-Zeilen, um festzulegen, wie KI ihre Inhalte nutzen darf; wir fanden sie in 2,9 % der Top-1.000-Dateien. Andere veröffentlichen eine llms.txt, um KI-Systeme zu ihren besten Inhalten zu führen. Keins davon ersetzt die robots.txt, die weiterhin die eine Datei ist, die jeder große Crawler zuerst liest.
Häufig gestellte Fragen
Wofür wird robots.txt verwendet?
Robots.txt sagt Crawlern, welche URLs einer Website sie abrufen dürfen. Website-Betreiber nutzen sie, um Crawler von unwichtigen Bereichen wie interner Suche und Warenkorbseiten fernzuhalten, um auf die Sitemap zu verweisen und zunehmend, um festzulegen, welche KI-Crawler die Website für Training oder KI-Suche nutzen dürfen.
Funktioniert robots.txt überhaupt?
Bei seriösen Crawlern ja: Googlebot, Bingbot, GPTBot, ClaudeBot und ähnliche Bots befolgen sie. Durchgesetzt wird sie aber nicht. Laut RFC 9309 sind ihre Regeln keine Zugriffsberechtigung, bösartige Bots ignorieren sie, und OpenAI zufolge gelten robots.txt-Regeln für von Nutzern ausgelöste Besuche von ChatGPT-User unter Umständen nicht.
Kann eine per robots.txt gesperrte Seite trotzdem indexiert werden?
Ja. Robots.txt verhindert das Crawling, nicht die Indexierung, daher kann Google eine gesperrte URL, die es über Links findet, trotzdem indexieren, meist ohne Beschreibung. Die Search Console meldet solche Seiten als „Indexiert, obwohl durch robots.txt-Datei blockiert“. Um eine Seite aus den Ergebnissen herauszuhalten, erlauben Sie das Crawling und setzen ein noindex-Tag.
Sollte ich KI-Crawler in der robots.txt sperren?
Das hängt davon ab, was Sie von KI wollen. Wer Trainings-Crawler wie GPTBot und ClaudeBot sperrt, hält seine Inhalte aus künftigem Modelltraining heraus. Wer Such-Crawler wie OAI-SearchBot, Claude-SearchBot und PerplexityBot sperrt, verschwindet aus diesen KI-Suchergebnissen. Bei den Top-1.000-Domains werden Trainings-Crawler mehr als doppelt so oft gesperrt wie Such-Crawler.
Nimmt eine Sperre von Google-Extended meine Website aus den AI Overviews?
Nein. Google zufolge hat Google-Extended keinen Einfluss darauf, ob eine Website in der Google-Suche erscheint. Es steuert, ob Ihre Inhalte für Gemini-Training und Grounding genutzt werden. AI Overviews sind Teil der Google-Suche und folgen daher Ihren Googlebot-Regeln.
Unterstützt Google crawl-delay oder noindex in der robots.txt?
Beides nein. Googles Spezifikation führt crawl-delay als nicht unterstützt, und die Unterstützung für noindex in der robots.txt hat Google am 1. September 2019 eingestellt. Nutzen Sie für noindex ein Robots-Meta-Tag oder einen X-Robots-Tag-Header. Seine Crawling-Rate richtet Google nach den Antworten Ihres Servers.
Sie können auch lesen: