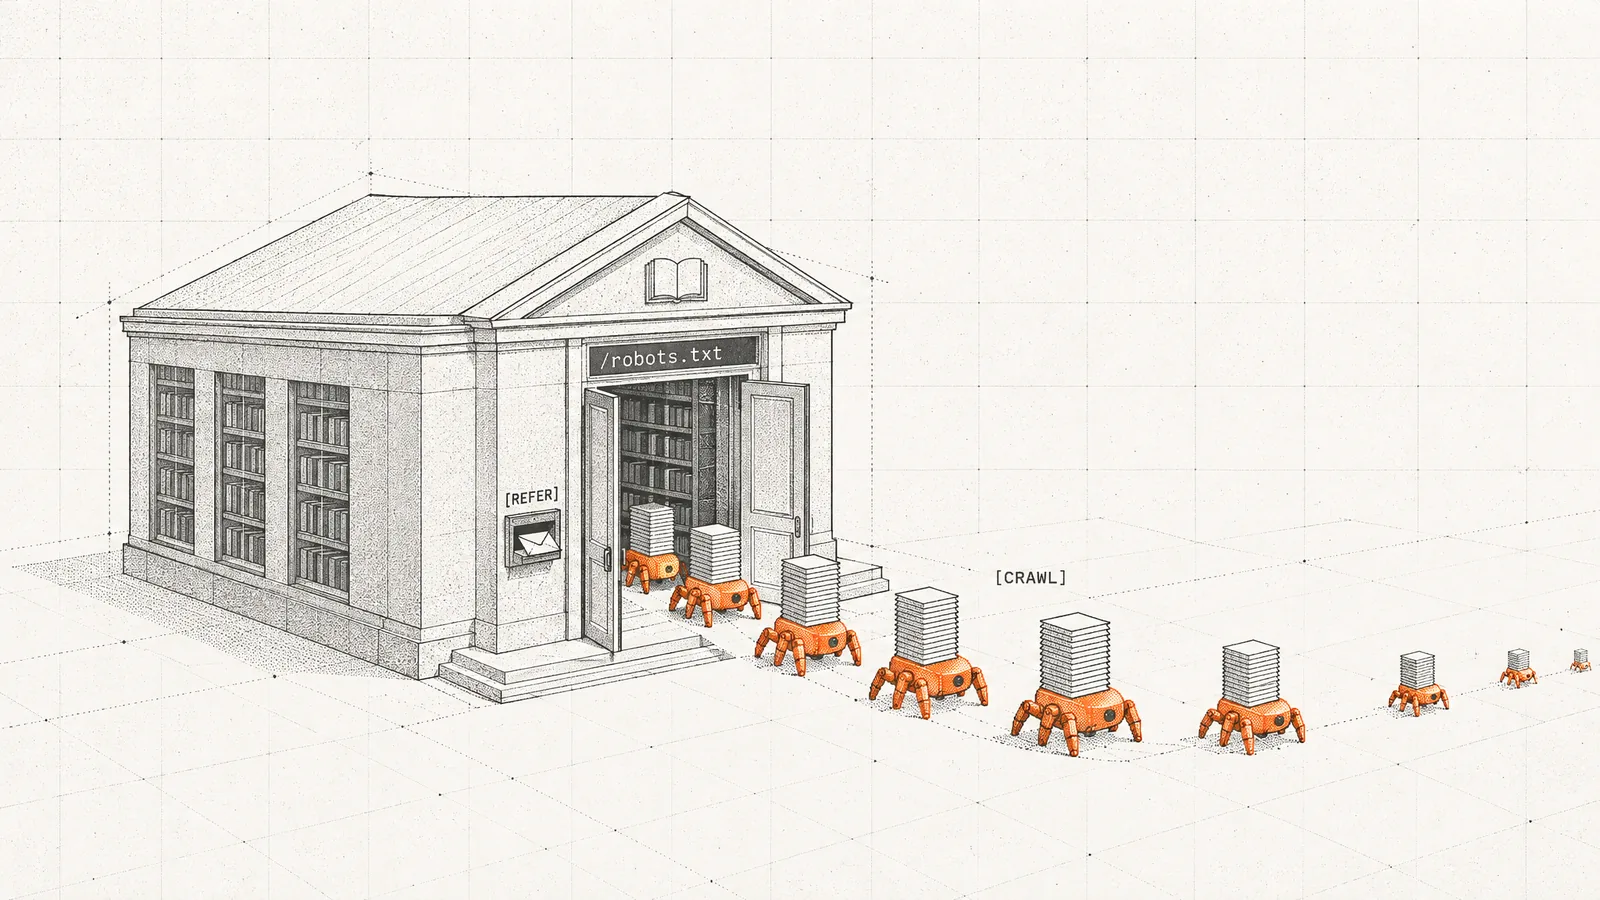
Perplexitys Crawler holt sich inzwischen 4.056 Seiten für jeden Referral, den seine Plattform an einen Website-Betreiber zurückschickt. Im Januar waren es 112. Dieser 36-fache Anstieg macht Perplexity im Oktober 2026 zum extraktivsten AI-Betreiber, der überhaupt noch Traffic zurückschickt. Mistral ist auf andere Weise schlimmer: Den dritten Monat in Folge hat Cloudflare von Mistral keine Referrals gezählt, sein Verhältnis hat also keinen endlichen Wert. Anthropic ging den umgekehrten Weg, von 47.779:1 im Januar auf 482:1, und schickt damit zum ersten Mal in diesem Jahr mehr Referrals pro gecrawlter Seite zurück als OpenAI. OpenAIs Verhältnis hat sich auf 775:1 mehr als verdoppelt, vor allem weil ChatGPTs Links keinen Referrer mehr mitschicken – eine Änderung, die wir in den eigenen Analytics von seomator.com live mitverfolgen konnten. DuckDuckGo liegt bei 4,0:1. Alle Werte stammen aus Cloudflare Radars Crawl-to-Refer-Verhältnis, Monat für Monat von Januar bis Oktober 2026 abgerufen. Dieses Verhältnis steht im Zentrum dieses Reports: Das Crawl-to-Refer-Verhältnis ist die Anzahl der Seiten, die ein AI Crawler oder LLM Bot abruft, geteilt durch die Referrals, die seine Mutterplattform (ChatGPT, Claude, Perplexity, Mistral, Copilot) zurückschickt.
Datenquellen: Cloudflare Radar – AI Insights (Crawl-to-Refer-Verhältnis) und Bot & Crawler Analytics, Kalendermonate Januar–September 2026 plus 1.–30. Oktober über die Radar-API; robots.txt- und Agent-Readiness-Scans vom 26. Oktober 2026; dazu SEOmators eigene Analytics für die AI-Assistenten-Besuche, die seomator.com im September und Oktober 2026 erhalten hat.
Was ist das Crawl-to-Refer-Verhältnis und warum ist es für GEO und SEO wichtig?
Das Crawl-to-Refer-Verhältnis misst, wie viele Seiten ein AI Crawler oder LLM Bot von deiner Website crawlt für jeden Referral-Besuch, den er zurückschickt. Ein Verhältnis von 100:1 bedeutet, dass der Bot 100 deiner Seiten gecrawlt hat, bevor seine Mutterplattform einen einzigen Nutzer auf deine Seite gelenkt hat.
Diese Kennzahl ist wichtig, weil AI Crawler – GPTBot, ClaudeBot, PerplexityBot und andere – deine Serverressourcen verbrauchen (Bandbreite, Rechenleistung und Crawl-Budget), während sie deine Inhalte für ihre LLM-Modelle indexieren. Die Referral-Seite misst, ob sich diese Investition durch tatsächlichen Traffic auszahlt, der an deine Seite zurückfließt.
Für SEO- und GEO-Profis fungiert dieses Verhältnis als Return-on-Investment-Kennzahl für den Crawler-Zugriff. Jede Seite, die von einem LLM Bot gecrawlt wird, ist eine Seite, die stattdessen vom Googlebot hätte gecrawlt werden können – was sich direkt auf die Verteilung des Crawl-Budgets deiner Seite auswirkt. Und die Last ist längst kein Rundungsfehler mehr. Im Oktober 2026 machten AI Bots allein 6,3 % der von Cloudflare klassifizierten Anfragen aus, nach 5,3 % im September, und Crawler mit gemischtem Zweck wie Googlebot, die sowohl Suche als auch AI-Produkte speisen, weitere 4,0 %.
Wie schneiden die führenden AI Crawler und LLM Bots beim Crawl-to-Refer-Verhältnis ab?
Die Spanne zwischen dem besten und dem schlechtesten Crawl-to-Refer-Verhältnis umfasst weiterhin drei Größenordnungen, und die Reihenfolge in der Mitte der Tabelle hat sich im Oktober erneut verändert. Perplexity ist weiter gestiegen. Anthropic liegt erstmals 2026 unter OpenAI. Mistral bleibt außerhalb des messbaren Bereichs.
| Betreiber | Crawl-to-Refer-Verhältnis (Okt. 2026*) | Sep. 2026 | Was das bedeutet |
|---|
| Mistral | Keine messbaren Referrals | Keine messbaren Referrals | Dritter Monat in Folge mit Crawling, aber ohne Referrals, die Cloudflare zählen konnte |
| Perplexity (PerplexityBot) | 4.056:1 | 2.373:1 | 71 % mehr in einem Monat und 36-mal so hoch wie im Januar; der extraktivste Betreiber, der noch Traffic verweist |
| OpenAI (GPTBot) | 775:1 | 341:1 | Mehr als verdoppelt, weil ChatGPTs Links keinen Referrer mehr mitschicken (siehe Referral-Abschnitt) |
| Anthropic (ClaudeBot) | 482:1 | 549:1 | Erstmals in diesem Jahr unter OpenAI; seit Mai jeden Monat gefallen |
| Baidu | 56:1 | 40:1 | 15-mal so hoch wie im Januar |
| Microsoft (Copilot) | 40:1 | 40:1 | Unverändert; umfasst Copilot- und Bing-AI-Funktionen |
| Yandex | 16:1 | 31:1 | Fast halbiert, der niedrigste Wert des Jahres |
| ByteDance | 11:1 | 9,0:1 | Seit Mai kaum verändert |
| Google (Gemini / AI Overviews) | 4,8:1 | 4,7:1 | Klassische Suche treibt hohes Referral-Volumen |
| DuckDuckGo | 4,0:1 | 3,6:1 | Weiterhin das effizienteste Verhältnis aller Betreiber |
*Oktober umfasst den 1. bis 30. Oktober 2026: Die Daten wurden am 31. Oktober abgerufen, und Radar liefert kein Zeitfenster, das in der Zukunft endet. Alle anderen Monate sind volle Kalendermonate. Ein erneuter Abruf von Januar bis September am 31. Oktober ergab dieselben Werte wie der Abruf für die September-Ausgabe; kein früherer Monat wurde revidiert.
Mistral und Perplexity sitzen aus unterschiedlichen Gründen am extraktiven Ende. Mistrals Verbraucherprodukt schickt fast keinen klickbaren Traffic zurück. Perplexity zitiert und verlinkt seine Quellen zwar, aber sein Crawling wuchs weit schneller als seine Referrals (mehr zu beiden unten). Google und DuckDuckGo sitzen am effizienten Ende, weil ihre Kernfunktion darin besteht, Nutzer an Websites zu schicken – jeder Klick auf ein Suchergebnis ist ein Referral. Ich verfolge diese Betreiber seit fast einem Jahr in Server-Logs, und die Diskrepanz ist auf Ebene der einzelnen Seite immer noch frappierend.
Was sich seit der September-Ausgabe verändert hat
- Perplexity: 2.373:1 → 4.056:1. 71 % mehr in einem Monat. Sein Verhältnis ist seit März jeden Monat gestiegen.
- OpenAI: 341:1 → 775:1. Mehr als verdoppelt, aber der Großteil der Bewegung hat mit Messung zu tun, nicht mit Crawling: Der Anteil von chatgpt.com an den Referrals bei Cloudflare fiel von 0,41 % auf 0,17 %, weil ChatGPTs Links keinen Referrer mehr mitschicken.
- Anthropic: 549:1 → 482:1. Der fünfte Rückgang in Folge und der erste Monat in diesem Jahr, in dem Anthropics Verhältnis niedriger ist als das von OpenAI.
- Mistral: weiterhin keine messbaren Referrals. Der dritte Monat in Folge. Der Anteil seines Fetchers an den AI-Bot-Anfragen halbierte sich von 0,78 % auf 0,37 %.
- Yandex: 31:1 → 16:1. Fast halbiert, so niedrig wie nie zuvor in diesem Jahr.
- Baidu: 40:1 → 56:1. Erneut gestiegen, nachdem es sich im September fast verdreifacht hatte.
Dieses Verhältnis zu verstehen, ist inzwischen ein zentraler Teil jeder ernsthaften AI-Search-Optimierungs-Strategie.
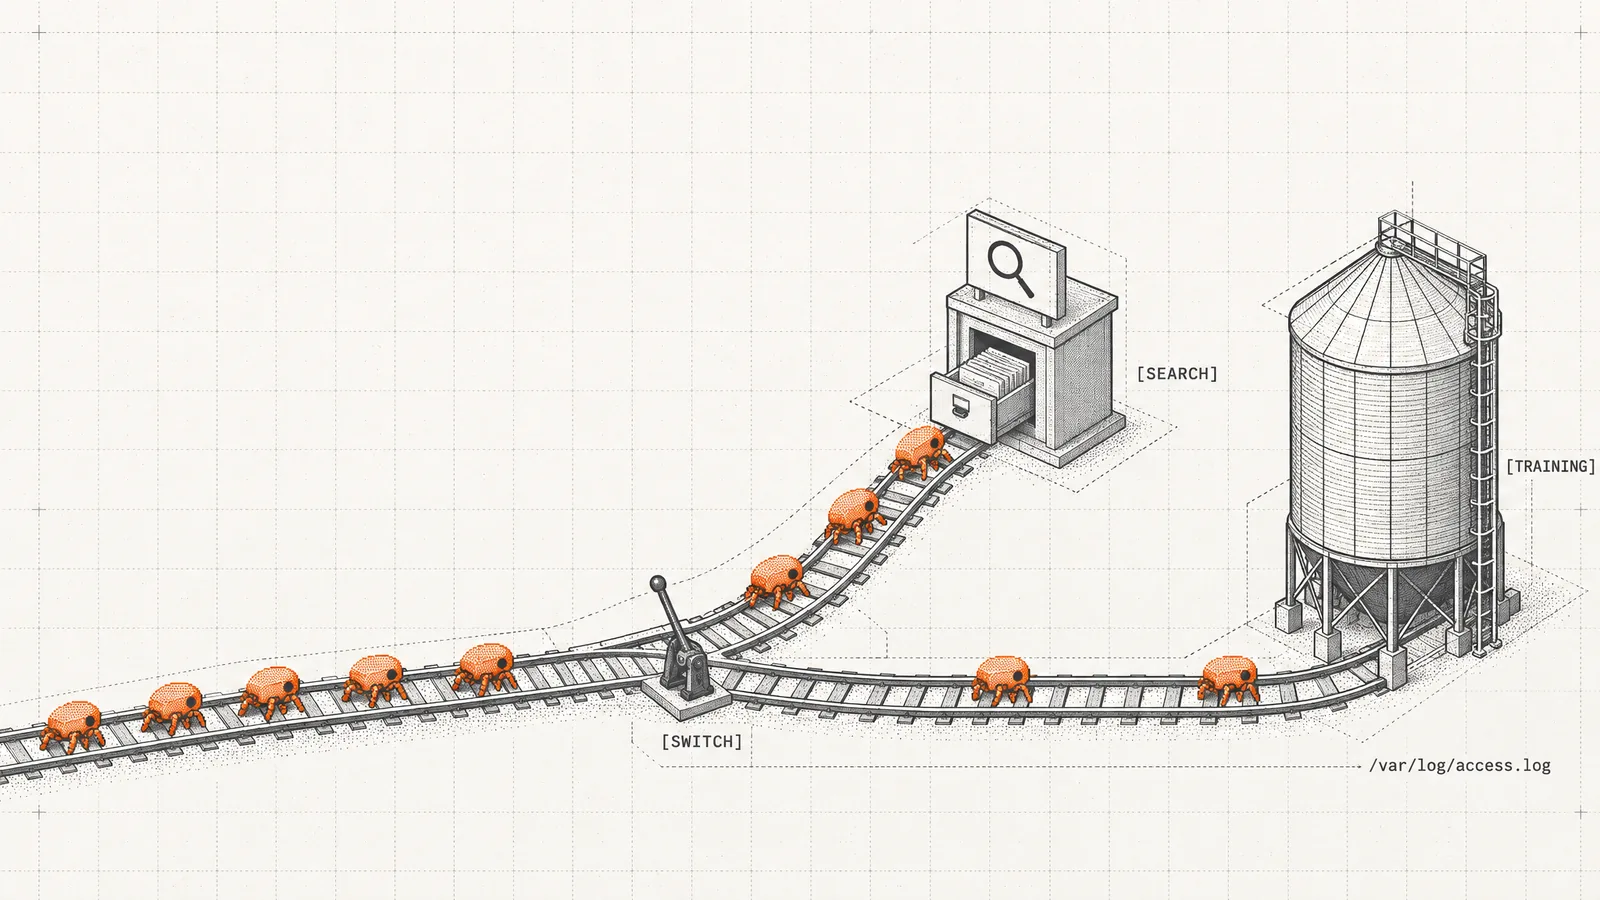
Im Januar 2026 war Anthropics Verhältnis eine fünfstellige Zahl und OpenAIs lag deutlich über tausend. Der Grund, warum beide so weit gefallen sind, ist nicht, dass sie weniger crawlen – sondern dass ihre Plattformen endlich begonnen haben, Traffic zurückzuschicken. Als ChatGPT Search und Claudes Oberflächen mit zitierten Quellen reiften, tauchten Referrals im Nenner des Verhältnisses auf, und die Zahl fiel schnell.
Cloudflare Radars Monatsreihe zeigt den Abstieg und die Umkehrungen, die danach kamen:
| Betreiber | Jan | Mai | Jul | Aug | Sep | Okt* |
|---|
| Anthropic | 47.779:1 | 12.874:1 | 1.914:1 | 910:1 | 549:1 | 482:1 |
| OpenAI | 1.309:1 | 1.066:1 | 256:1 | 424:1 | 341:1 | 775:1 |
| Perplexity | 112:1 | 139:1 | 296:1 | 822:1 | 2.373:1 | 4.056:1 |
| Mistral | 23:1 | 51:1 | 29.944:1 | Keine Referrals | Keine Referrals | Keine Referrals |
| Google | 4,7:1 | 4,9:1 | 4,8:1 | 5,2:1 | 4,7:1 | 4,8:1 |
Kalendermonate, Cloudflare Radar bots/crawlers/summary/crawl_refer_ratio; *1.–30. Oktober. „Keine Referrals" bedeutet, dass Radar das Verhältnis als unendlich ausweist: Es hat Crawling gezählt, aber keine Referrals.
Die Anthropic-Linie ist das klarste Signal im Datensatz: Ein Betreiber, der im Januar rund 48.000 Seiten pro Referral nahm, lag im Oktober bei 482, eine rund 99-fache Verbesserung, als Claudes nutzerseitige Oberflächen begannen, Klicks zurückzugeben. OpenAI folgte demselben Pfad bis Juli und driftete danach wieder nach oben, weil ChatGPTs Anteil an den Referrals sank, und im Oktober hat sich sein Verhältnis aus einem Grund mehr als verdoppelt, der mit Crawling wenig zu tun hat (siehe den Referral-Abschnitt unten). Das ist die Referral-Seite des Handels, die sich wieder durchsetzt – und es bestätigt eine Aussage, die ich das ganze Jahr über gegenüber Kunden gemacht habe: Extraktionsverhältnisse sind nicht fix und bewegen sich in dem Moment, in dem eine Plattform ein Produkt ausliefert, das nach außen verlinkt.
Sie sind auf unterschiedlichen Wegen dorthin gekommen, und Radars User-Agent-Daten zeigen beide.
Mistral ist das Spiegelbild der Anthropic-Geschichte. In den ersten fünf Monaten des Jahres 2026 lag sein Verhältnis im niedrigen zweistelligen Bereich. Ab Juni hob sein Crawling ab: MistralAI-User, Mistrals Fetcher, stieg von 0,004 % der AI-Bot-Anfragen im Juni auf 0,78 % im September, ein rund 190-facher Anstieg des Anteils. Seine Plattform schickte fast nichts zurück. Im Juli lag das Verhältnis bei 29.944:1, und von August bis Oktober zählte Radar überhaupt keine Mistral-Referrals mehr. Im Oktober ging sein Crawling erstmals zurück: Der Anteil des Fetchers halbierte sich auf 0,37 %, was immer noch rund 90-mal so viel ist wie im Juni.
Auch Perplexitys Sprung kommt vom Crawling. Der Anteil von PerplexityBot an den AI-Bot-Anfragen stieg von 0,18 % im Juni auf 2,57 % im Oktober, fast fünfzehnmal so viel, und seine Referrals hielten nicht Schritt. Anders als Mistral schickt Perplexity durchaus Besucher, weil seine Antworten Quellen zitieren und verlinken. Das Verhältnis besagt, dass sein Crawling inzwischen rund 4.000 Seiten vor jedem Besuch liegt, den es zurückgibt.
Diese Kombination – ein starker Anstieg des Crawlings mit wenig oder gar keinem Referral im Gegenzug – ist genau das Profil, das ClaudeBot vor einem Jahr zum Aushängeschild der Extraktion machte. Wenn du dieses Quartal den AI-Crawler-Zugriff prüfst, sind MistralAI-User und PerplexityBot die Namen, die du in deinen Logs im Auge behalten solltest. Nur wenige Seiten haben nachgezogen: MistralAI-User gehört nicht zu den 40 User-Agents, die robots.txt-Dateien am häufigsten sperren (mehr dazu unten). Die Lehre aus Anthropic ist, dass sich das Verhältnis verbessern kann, sobald ein Verbraucherprodukt nach außen verlinkt; die Frage für Publisher ist, ob sie das Crawling in der Zwischenzeit subventionieren wollen.
Wie viel deiner Crawl-Last ist tatsächlich AI – und was holen sich die Bots?
Bevor du entscheidest, was du blockierst, hilft es, die Zusammensetzung des Traffics zu sehen. In Cloudflares Netzwerk teilen sich Menschen und AI Bots den Anfragestrom inzwischen so auf:
| Client-Typ | Anteil am Traffic (Okt. 2026*) |
|---|
| Nicht-AI-Bot | 54,6 % |
| Mensch | 35,0 % |
| AI Bot | 6,3 % |
| Gemischter Zweck | 4,0 % |
Die 6,3-%-Zahl für „AI Bot" untertreibt den Druck auf Content-Seiten im Speziellen, weil sie ein Durchschnitt über alles ist, was Cloudflare ausliefert. Die Branchenaufschlüsselung weiter unten zeigt, wo sich das Crawling konzentriert.
Was holen sich all diese Bots eigentlich? Nach deklariertem Crawl-Zweck über AI Bots hinweg:
| Crawl-Zweck | Anteil an AI-Bot-Anfragen (Jan. 2026) | Anteil an AI-Bot-Anfragen (Okt. 2026*) |
|---|
| Training | 43,9 % | 43,8 % |
| Gemischter Zweck | 50,9 % | 39,2 % |
| Search / Answer-Retrieval | 2,6 % | 11,6 % |
| Nutzer-ausgelöste Aktion | 2,2 % | 3,9 % |
| Nicht deklariert | 0,5 % | 1,5 % |
Search ist die Linie, die sich bewegt hat. Sie hat sich mehr als vervierfacht, von 2,6 % der AI-Bot-Anfragen im Januar auf 11,6 % im Oktober. Training ist mit 43,8 % der größte deklarierte Zweck, etwa dort, wo es ins Jahr gestartet ist, nach einem Höchststand von 50,7 % im Juli. Nutzer-ausgelöste Abrufe, bei denen ein Assistent eine Seite öffnet, weil ein Mensch danach gefragt hat, wuchsen auf 3,9 %. Die praktische Lesart: AI Bots crawlen deine Seite zunehmend, um live Nutzerfragen zu beantworten, nicht nur zum Trainieren – und das ist genau der Traffic, für den du zitierbar sein willst.
Und nach Content-Typ sind AI Crawler überwältigend auf deine Prosa aus, nicht auf deine Assets:
| Content-Typ | Anteil an AI-Bot-Anfragen (Okt. 2026*) |
|---|
| HTML | 72,9 % |
| Klartext | 8,4 % |
| JSON | 5,4 % |
| JavaScript | 4,9 % |
| Bilder | 4,5 % |
| XML / CSS / sonstige | 3,9 % |
Fast drei Viertel der AI-Crawler-Anfragen zielen auf HTML. Deine geschriebenen Inhalte – Artikel, Dokumentation, Produktbeschreibungen – sind der Korpus. Das ist zugleich das Risiko (er wird genommen) und die Chance (er ist das, was zitiert wird). Klartext ist die Linie, die du beobachten solltest: Sein Anteil stieg von 5,9 % im Juli auf 9,2 % im September und hielt sich im Oktober bei 8,4 %, während HTML sich auf 72,9 % erholte, nachdem es im September auf 68,9 % gefallen war.
Welche AI Crawler und LLM Bots crawlen tatsächlich die meisten Seiten?
Betrachtet man den Gesamtanteil der User-Agents am gesamten Crawler-Traffic (nicht nur AI), führt Googlebot weiterhin mit großem Abstand. Der Bot auf dem zweiten Platz ist aber nach wie vor ein AI Crawler: Anthropics ClaudeBot.
| User-Agent | Anteil am gesamten Crawler-Traffic (Okt. 2026*) | Kategorie |
|---|
| Googlebot | 23,68 % | Suchmaschine |
| ClaudeBot (Anthropic) | 11,84 % | AI Crawler / LLM Bot |
| Meta-ExternalAgent (Meta AI) | 9,24 % | AI Crawler / LLM Bot |
| Bingbot | 8,74 % | Suchmaschine |
| Applebot | 7,33 % | Suche / AI |
| GPTBot (OpenAI) | 6,73 % | AI Crawler / LLM Bot |
| facebookexternalhit | 5,77 % | Social-Vorschau |
| ShapBot (Parallel) | 4,57 % | AI Crawler / LLM Bot |
| Amazonbot | 3,38 % | AI Crawler / LLM Bot |
Radars nicht klassifizierter Bereich „other" wuchs von 13,5 % des Crawler-Traffics im Juli auf 18,7 % im Oktober, kleine Verschiebungen in diesen Anteilen solltest du also mit Vorsicht lesen.
ClaudeBots Vorsprung ist seit dem Sommer geschrumpft. Sein Anteil am gesamten Crawler-Traffic fiel von 19,5 % im Juli auf 11,8 % im Oktober, der von GPTBot von 12,7 % auf 6,7 %. Innerhalb der AI-Bot-Population im Speziellen holte sich ClaudeBot im Oktober die Führung von Meta-ExternalAgent zurück, mit 12,6 % der AI-Bot-Anfragen gegenüber 11,2 % für Meta und 5,5 % für GPTBot. OpenAIs Such-Crawler OAI-SearchBot hat seinen Anteil seit Juli fast verdreifacht, von 1,6 % auf 4,3 %. Ein neuer Name kam unter die ersten neun: ShapBot, der Crawler, mit dem Parallel Web Systems Seiten für seine Web-APIs indexiert, mit 4,6 % des gesamten Crawler-Traffics. Cloudflare zählt ihn zu den AI Bots, führt ihn aber nicht in seinem Bot-Verzeichnis. Behalte die Meta-Zahl für den Abschnitt übers Blockieren im Kopf: Meta-ExternalAgent ist der zweitgrößte reine AI Crawler, und Meta hat überhaupt kein Referral-Produkt. Unsere frühere Recherche zu AI-SEO-Statistiken hat den Wechsel von OpenAI zu Anthropic an der Spitze verfolgt, und der monatliche AI Crawler Report zeigt diese Anteile Monat für Monat.
Woher stammt der Referral-Traffic tatsächlich?
Trotz all dieses Crawlings stammt der Referral-Traffic weiterhin überwältigend von Google. Nach Cloudflares Zahlen ist ChatGPT ans Ende der Liste gefallen, und Claude schickt inzwischen mehr als doppelt so viel.
| Referrer | Anteil am gesamten Referral-Traffic (Okt. 2026*) |
|---|
| Google | 91,19 % |
| Bing | 2,78 % |
| TikTok | 1,87 % |
| DuckDuckGo | 1,56 % |
| Yandex | 1,27 % |
| Claude (claude.ai) | 0,40 % |
| Baidu (mobil) | 0,33 % |
| Baidu (Desktop) | 0,19 % |
| ChatGPT | 0,17 % |
Die Juli-Ausgabe meldete, dass ChatGPT die 1-%-Marke der Referrals überschritten hatte (1,05 % in den 28 Tagen bis zum 21. Juli), und nannte das früher als erwartet. Es hielt nicht. Auf Kalendermonaten stieg chatgpt.com von 0,18 % im Januar auf einen Höchststand von 0,90 % im Juli und fiel dann auf 0,53 % im August, 0,41 % im September und 0,17 % im Oktober, knapp unter den Wert, mit dem es ins Jahr gestartet war. claude.ai ging den umgekehrten Weg, von 0,30 % im August auf 0,40 % im Oktober.
Hat ChatGPT im Oktober aufgehört, Traffic zu schicken?
Zu uns nicht. Nach allem, was wir sehen können, ist der Einbruch im Oktober vor allem eine Messänderung: ChatGPTs Links schicken keinen Referrer mehr mit. Cloudflare zählt einen Referral, wenn ein Besuch mit einem Referer-Header ankommt, der die Plattform nennt. Auf seomator.com sehen wir sowohl diesen Header als auch das Tag utm_source=chatgpt.com, das ChatGPT an die angezeigten Links hängt, und im Oktober liefen die beiden auseinander:
| Woche ab (2026) | ChatGPT-Sessions auf seomator.com (mit utm-Tag) | Davon mit chatgpt.com-Referrer |
|---|
| 13. Sep. | 274 | 149 |
| 20. Sep. | 322 | 149 |
| 27. Sep. | 444 | 120 |
| 4. Okt. | 473 | 69 |
| 11. Okt. | 291 | 5 |
| 18. Okt. | 601 | 3 |
| 25. Okt.* | 405 | 1 |
*25.–30. Oktober, sechs Tage.
Die ChatGPT-Besuche kamen weiter an und wurden mehr, während der Anteil mit einem chatgpt.com-Referrer innerhalb von zwei Wochen von etwa der Hälfte auf fast null fiel. Radars wöchentliche Referral-Reihe bricht im selben Moment ein: Der Anteil von chatgpt.com an den Referrals lag in der Woche ab dem 28. September bei 0,37 % und in den beiden letzten Oktoberwochen jeweils bei 0,07 %. In denselben Wochen stieg OpenAIs wöchentliches Crawl-to-Refer-Verhältnis von 362:1 auf 1.884:1. Radar begann Ende September außerdem, einen neuen OpenAI-Bot zuzuordnen, „ChatGPT agent", der im Oktober 65 % der OpenAI-Bot-Anfragen ausmachte. OpenAIs Verhältnis bewegte sich in der Woche, in der dieser Bot auftauchte, kaum. Es sprang in der Woche, in der die Referrer verschwanden.
OpenAIs Oktober-Verhältnis von 775:1 übertreibt also, wie wenig ChatGPT zurückgibt – und das gilt für jeden Analytics-Report, der ChatGPT-Traffic allein am Referrer erkennt. Falls deine GA4-Zeile „chatgpt.com / referral" im Oktober abgestürzt ist, prüfe utm_source=chatgpt.com, bevor du schließt, dass ChatGPT keine Besucher mehr schickt. Eine einzelne Seite kann uns nicht sagen, warum der Header verschwunden ist oder ob jede ChatGPT-Oberfläche betroffen ist. Sie zeigt aber, dass die ChatGPT-Sessions auf seomator.com von September bis Oktober um 48 % gestiegen sind.
SEOmators eigene Website zeigt außerdem, wie anders eine einzelne Seite aussehen kann. Vom 1. bis 30. Oktober 2026 hatte seomator.com 77.672 Sessions, und 2.281 davon (2,9 %) kamen von AI-Assistenten, nach 2,6 % im September. So verteilen sich diese AI-Sessions:
| AI-Assistent | Sessions auf seomator.com (Okt. 2026*) | Anteil an den AI-Sessions |
|---|
| ChatGPT | 1.992 | 87,3 % |
| Gemini | 191 | 8,4 % |
| Perplexity | 74 | 3,2 % |
| Claude | 23 | 1,0 % |
| Qwen | 1 | <0,1 % |
In Cloudflares Netzwerk ist Claudes Referral-Anteil inzwischen mehr als doppelt so hoch wie der von ChatGPT. Auf seomator.com schickte ChatGPT rund 87-mal so viele Sessions wie Claude. Ein Teil dieser Lücke ist die Referrer-Änderung oben: Unsere Analytics erkennen ChatGPT am utm-Tag, Radars Referral-Zählung braucht den Header. Der Rest ist das Publikum. Eine einzelne Seite ist keine Stichprobe, und das Publikum eines SEO-Tools ist nicht typisch. Trotzdem ist es eine nützliche Warnung: Netzwerkweite Daten sagen dir, welche Plattformen insgesamt Traffic schicken, und nur deine eigenen Analytics sagen dir, welche ihn zu dir schicken. Prüfe deine, bevor du entscheidest, von welchen Assistenten sich das Crawlen lohnt.
Welche Branchen werden von AI Crawlern und LLM Bots am meisten gecrawlt?
Retail- und Infrastruktur-Inhalte absorbieren einen überproportionalen Anteil der Crawler-Aufmerksamkeit relativ zu ihrem Fußabdruck im Web.
| Branche | Anteil am Crawler-Traffic (Okt. 2026*) |
|---|
| Shopping & Handelswaren | 24,4 % |
| Internet & Telekommunikation | 21,6 % |
| Computer & Elektronik | 19,4 % |
| News, Medien & Publikationen | 8,4 % |
| Glücksspiel | 6,2 % |
| Business & Industrie | 3,6 % |
| Professionelle Dienstleistungen | 3,2 % |
| Finance | 2,6 % |
Shopping-Seiten absorbieren fast ein Viertel des gesamten Crawler-Traffics, mehr als jede andere Branche, und diese Anteile haben sich seit Juli kaum bewegt. Was gecrawlt wird, ist weit stabiler als die Frage, wer crawlt. Wenn ich technische SEO-Audits für SaaS-Kunden durchführe, sind branchenspezifische Crawl-Muster immer das Erste, was ich prüfe – ein Finance-SaaS und ein Unterhaltungselektronik-Händler bekommen von derselben Bot-Gruppe grundlegend andere Gegenleistungen. Ich habe verwandte AI-Bot-Traffic-Muster nach Ländern in einer früheren Analyse dokumentiert, in der die Geografie vergleichbare Variation antrieb.
Ist das Web tatsächlich bereit für die AI-Agenten, die es crawlen?
Hier ist eine Lücke, die die ganze „Soll ich blockieren?"-Frage neu einordnet. Cloudflares Agent-Readiness-Scan hat am 26. Oktober 2026 114.605 Top-Domains geprüft:
| Signal | Anteil der Domains (Okt. 2026) |
|---|
| robots.txt mit AI-Crawler-Regeln | 81,7 % |
| XML-Sitemap | 70,2 % |
| Liefert Markdown an Agenten | 4,0 % |
| MCP-Server-Card (agenten-nativ) | 0,5 % |
| Web Bot Auth | 0,1 % |
Vier von fünf Top-Seiten schreiben inzwischen explizite AI-Crawler-Regeln, doch nur 4,0 % liefern sauberes Markdown an Agenten, und agenten-native Protokolle (MCP, Web Bot Auth) sind faktisch weiterhin bei null. Das Web schreibt Regeln für AI-Agenten, die es gar nicht gut zu bedienen imstande ist. Wenn du entscheidest, wie du mit AI Crawlern umgehst, ist das der wahre Stand der Technik: Die meisten Seiten kämpfen noch den letzten Krieg (Allow/Deny in der robots.txt) statt des nächsten (Agenten strukturierte, effiziente Inhalte zu liefern).
Wie viele Websites blockieren AI Crawler und LLM Bots?
Website-Betreiber reagieren auf ungünstige Verhältnisse, indem sie AI Crawler in ihren robots.txt-Dateien benennen, und die beiden Namen an der Spitze der Liste gehören den Trainings-Crawlern von OpenAI und Anthropic. Cloudflares robots.txt-Scan hat am 26. Oktober 2026 4.367 robots.txt-Dateien von Top-Domains geparst. Gezählt werden nur Disallow-Regeln:
| Agent | Dateien, die ihn sperren | Davon vollständig gesperrt | Betreiber |
|---|
| GPTBot | 639 (14,6 %) | 442 | OpenAI |
| ClaudeBot | 567 (13,0 %) | 395 | Anthropic |
| CCBot | 544 (12,5 %) | 420 | Common Crawl |
| Google-Extended | 513 (11,7 %) | 346 | Google (AI-Opt-out) |
| Bytespider | 501 (11,5 %) | 423 | ByteDance |
| meta-externalagent | 408 (9,3 %) | 321 | Meta |
| Amazonbot | 403 (9,2 %) | 315 | Amazon |
| Applebot-Extended | 392 (9,0 %) | 289 | Apple (AI-Opt-out) |
| PerplexityBot | 375 (8,6 %) | 189 | Perplexity |
| anthropic-ai | 356 (8,2 %) | 270 | Anthropic (älterer Agent-Name) |
| ChatGPT-User | 349 (8,0 %) | 174 | OpenAI |
Das Blockieren hat sich in drei Wochen bewegt, und zwar in Richtung der Trainings-Crawler. Zwischen Cloudflares Scans vom 5. und vom 26. Oktober kamen bei den Trainings-Crawlern jeweils rund 75 bis 100 sperrende Dateien hinzu (GPTBot +93, ClaudeBot +94, CCBot +92, Google-Extended +92), während sich die Such- und nutzer-ausgelösten Fetcher kaum bewegten (OAI-SearchBot +13, Claude-SearchBot +16, ChatGPT-User +22). Der Scan vom 26. Oktober hat außerdem 110 Dateien mehr geparst als der frühere, die Zahlen mischen also neue Seiten mit geänderten Regeln. Aussagekräftig ist die Richtung: Das neue Blockieren zielt auf Bots, die mit Seiten trainieren, nicht auf jene, die eine Seite abrufen, um eine Frage zu beantworten.
Die extraktivsten Betreiber gehören zu den am seltensten blockierten. MistralAI-User taucht nicht unter den 40 User-Agents auf, die robots.txt-Dateien am häufigsten sperren, obwohl seit drei Monaten keine messbaren Referrals mehr kommen. PerplexityBot wird von 375 Dateien gesperrt und von fast ebenso vielen (360) ausdrücklich erlaubt.
Seiten behandeln außerdem den Trainings-Crawler eines Betreibers anders als seinen Such-Crawler:
| Agent | Zweck | Dateien, die sperren | Dateien, die erlauben |
|---|
| GPTBot | Training | 639 | 363 |
| OAI-SearchBot | Suche | 292 | 332 |
| ClaudeBot | Training | 567 | 321 |
| Claude-SearchBot | Suche | 200 | 171 |
| Google-Extended | AI-Trainings-Opt-out | 513 | 313 |
Bei OpenAI ist die Aufteilung bereits klar. GPTBot wird weit häufiger gesperrt als erlaubt, während OAI-SearchBot häufiger erlaubt als gesperrt wird: Training blockieren, Sichtbarkeit in der Suche behalten. Bei Anthropic haben die meisten Dateien noch nicht nachgezogen. Claude-SearchBot wird in weniger als halb so vielen Dateien genannt wie ClaudeBot.
Bemerkenswert: Das Blockieren steigt, obwohl sich manche Verhältnisse verbessern. In Cloudflares Netzwerk kletterte der Anteil der Crawler-Anfragen, die mit einem 4xx-Status beantwortet werden, von 33,1 % im Januar auf 38,9 % im Oktober, und der tatsächlich ausgelieferte Anteil (2xx) rutschte von 51,5 % auf 45,8 %. Mehr als jede dritte Crawler-Anfrage endet inzwischen mit einem 4xx. Falls du unsicher bist, wie deine eigene robots.txt für LLM Bots konfiguriert ist, geht unser robots.txt-Leitfaden die AI-Crawler-Regeln durch.
Solltest du AI Crawler und LLM Bots auf Basis dieser Daten blockieren?
Die Entscheidung hängt von deiner Branche, deinen Traffic-Zielen und deiner langfristigen GEO-Strategie ab. Auf Basis der Daten vom Oktober 2026 sortieren sich die Betreiber in vier Gruppen.
Mit gutem Gewissen blockieren: Mistral (seit August keine messbaren Referrals) und Meta-ExternalAgent. Mistrals Fetcher wuchs zwischen Juni und September als Anteil der AI-Bot-Anfragen rund 190-fach, und selbst nach der Halbierung im Oktober kam nichts zurück, was Cloudflare zählen konnte. Meta-ExternalAgent, der zweitgrößte reine AI Crawler, hatte nie ein Referral-Produkt. Diese liefern nahezu null Gegenwert und verbrauchen Ressourcen ausschließlich zum Vorteil des Betreibers.
Sorgfältig abwägen: PerplexityBot (4.056:1), GPTBot (775:1) und ClaudeBot (482:1). Alle drei Betreiber betreiben Answer-Engines, die Quellen zitieren und verlinken, ein Blockieren bedeutet also, die Repräsentation in diesen Antworten aufzugeben – ein realer AI-Search-Optimierungs-Preis. Aber sie bewegen sich in entgegengesetzte Richtungen: Anthropics Verhältnis hat sich seit Januar rund 99-fach verbessert, Perplexitys 36-fach verschlechtert. Lies OpenAIs Oktober-Wert mit dem Referrer-Vorbehalt von oben; sein tatsächlicher Gegenwert ist besser, als 775:1 vermuten lässt. Bei OpenAI und Anthropic musst du nicht alles oder nichts wählen: Blockiere den Trainings-Crawler und behalte den Such-Crawler (GPTBot vs. OAI-SearchBot, ClaudeBot vs. Claude-SearchBot), wie es immer mehr Seiten in Cloudflares Scan bereits tun.
Strategisch zulassen: Microsoft Copilot (40:1). Moderates Verhältnis, Referral-Traffic über Bing- und Copilot-Oberflächen und prominente Quellenangabe.
Unblockiert lassen: Google (4,8:1), DuckDuckGo (4,0:1) und klassische Such-Crawler. Diese liefern messbaren Referral-Traffic, der ihr Crawl-Volumen rechtfertigt.
Ein Vorbehalt, bevor du irgendeine robots.txt-Regel schreibst: Referrals sind nicht der einzige Gegenwert dafür, gecrawlt zu werden. Ein Bot kann prägen, wie ein Assistent deine Marke beschreibt, ohne je einen Klick zu schicken – Blockieren ist also keine kostenlose Handlung. Und für die Betreiber, die du zulässt, ist der Zugriff nicht der einzige Hebel – du kannst eine llms.txt-Datei generieren, um diesen Bots zu sagen, welche deiner Seiten tatsächlich wichtig sind, statt sie das aus einem vollständigen Crawl ableiten zu lassen.
Was bedeutet das für die Zukunft von GEO, AI-Suche und Publisher-Beziehungen?
Die Crawl-to-Refer-Daten aus den ersten zehn Monaten des Jahres 2026 revidieren die Geschichte, die sich das Web 2025 selbst erzählte. Die Befürchtung war, dass LLM-Plattformen endlos crawlen und nie Traffic zurückschicken würden. Was tatsächlich passiert ist, ist gemischter: Die größten Extrahierer verbesserten sich dramatisch in dem Moment, in dem sie Verbraucherprodukte auslieferten, die nach außen verlinken, während andere Betreiber (Mistral, dann Perplexity) an ihrer Stelle die Extraktionsführung übernahmen. Drei Trends zeigen, wohin die Reise geht:
1. Extraktionsverhältnisse sind elastisch, in beide Richtungen. Anthropic ging in zehn Monaten von ~48.000:1 auf 482:1, weil Referrals auftauchten. Perplexity ging von 112:1 auf 4.056:1, weil sein Crawling ihnen davonlief. Der schlimmste Übeltäter von heute ist nicht zwangsläufig der von morgen, und der beste von heute auch nicht.
2. AI-Referrals sind real, aber ihre Messung ist fragil. ChatGPTs Anteil am Referral-Traffic bei Cloudflare erreichte im Juli mit 0,90 % seinen Höchststand und lag im Oktober bei 0,17 %, größtenteils weil seine Links keinen Referrer mehr mitschicken, während Claudes auf 0,40 % stieg. Auf seomator.com kamen im Oktober 2,9 % der Sessions von AI-Assistenten, und ChatGPTs Zahl stieg, statt zu fallen. GEO-Arbeit für diese Engines zeigt sich inzwischen in den Analytics; stell nur sicher, dass deine Analytics sie noch sehen können.
3. Die Readiness-Lücke ist das nächste Schlachtfeld. Mit vier von fünf Seiten, die AI-Regeln schreiben, aber nur 4,0 %, die Markdown an Agenten liefern, werden die Gewinner der nächsten Phase nicht die Seiten sein, die am härtesten blockieren – sondern die, die AI-Agenten effiziente, strukturierte, zitierbare Inhalte liefern. Blockieren ist Verteidigung; zitierbar zu sein ist Angriff.
Website-Betreiber, die diese Verhältnisse vierteljährlich überwachen und ihren AI-Crawler-Zugriff anhand messbarer Erträge anpassen, werden diejenigen übertreffen, die entweder alles blockieren oder alles zulassen. Das ist das Fundament einer datengetriebenen GEO-Strategie.
So überwachst du das Crawl-to-Refer-Verhältnis deiner Seite
Während Cloudflare Radar netzwerkweite Aggregate liefert, können einzelne Seitenbetreiber ihre eigenen Crawl-to-Refer-Verhältnisse anhand von Server-Logs und Analytics annähern. Hier ist der Prozess, dem ich bei Kunden folge:
- Server-Log-Analyse: Zähle die Anfragen von bekannten AI-Crawler- und LLM-Bot-User-Agents (GPTBot, OAI-SearchBot, ClaudeBot, Claude-User, MistralAI-User, Meta-ExternalAgent, PerplexityBot, ShapBot) über einen Zeitraum von 30 Tagen
- Referral-Tracking: Filtere in Google Analytics 4 oder deiner Analytics-Plattform den Referral-Traffic von chatgpt.com, claude.ai, perplexity.ai, gemini.google.com und anderen LLM-gestützten Oberflächen. Zähle auch Sessions mit dem Tag
utm_source=chatgpt.com: Seit Oktober 2026 kommen die meisten ChatGPT-Klicks, die wir sehen, ohne Referrer an
- Verhältnis berechnen: Teile die gesamten AI-Crawler-Anfragen durch die gesamten von AI verwiesenen Besuche, pro Betreiber
- Mit Benchmarks vergleichen: Nutze die Oktober-2026-Verhältnisse aus diesem Report als Ausgangswerte und prüfe vierteljährlich nach – wie die Ausschläge bei Perplexity, Mistral und OpenAI zeigen, bewegen sich die Zahlen schnell
Falls du keinen Server-Log-Zugriff hast, deckt ein AI-Crawler-Zugriffsreport die Crawl-Hälfte der Gleichung ab – er zeigt, welche LLM Bots deine robots.txt aktuell zulässt oder blockiert, also den Input, den du tatsächlich ändern kannst.
SEO-Tools wie SEOmator können die technische Seite automatisieren – sie analysieren deine robots.txt-Konfiguration, überwachen AI-Crawler-Zugriffsmuster und identifizieren, welche LLM Bots dein Crawl-Budget verbrauchen, ohne proportionalen Wert zu liefern.
Methodik
Dieser Report stützt sich auf Cloudflare Radar, das den Traffic über Cloudflares globales Netzwerk hinweg überwacht, einen erheblichen Teil des gesamten Internet-Traffics, was seine Bot- und Crawler-Daten weitgehend repräsentativ für web-weite Muster macht. Alle Traffic-Werte wurden am 31. Oktober 2026 über die Radar-API abgerufen, als Kalendermonate vom 1. Januar bis 30. September 2026 plus 1.–30. Oktober (Radar liefert kein Zeitfenster, das in der Zukunft endet, der Oktober ist also einen Tag kürzer). Der erneute Abruf von Januar bis September ergab dieselben Werte wie der Abruf vom 7. Oktober für die September-Ausgabe. Die Crawl-to-Refer-Verhältnisse stammen aus bots/crawlers/summary/crawl_refer_ratio (die Kennzahl, wie Cloudflare sie definiert), die Wochenwerte aus dem passenden timeseries_groups-Endpoint; Client-Typen, Crawler-User-Agents, Referrer (monatlich und wöchentlich), Branchen und Statuscodes aus den Web-Crawler-Endpoints; OpenAIs Bot-Mix aus den Bots-Endpoints; Crawl-Zweck, AI-User-Agents und Content-Typen aus den AI-Bot-Endpoints; die robots.txt-Zählungen aus robots_txt/top/user_agents/directive, getrennt abgefragt für Disallow und Allow; und die Agent-Readiness-Signale aus agent_readiness. Die robots.txt- und Agent-Readiness-Werte sind Scans eines einzelnen Tages vom 26. Oktober 2026; der Drei-Wochen-Vergleich bei robots.txt nutzt den Scan vom 5. Oktober 2026, den die September-Ausgabe zitierte.
SEOmators eigene Werte decken eine einzige Seite ab, die wir vollständig überprüfen können: die AI-Assistenten-Sessions, die seomator.com vom 1. bis 30. Oktober 2026 erhalten hat (mit dem 1.–30. September zum Vergleich), sowie Referrer und utm_source seiner ChatGPT-Sessions pro Woche vom 13. September bis 30. Oktober 2026, gemessen mit unseren First-Party-Analytics. Sie beschreiben das Publikum einer SEO-Tool-Website, nicht das Web. Die Juli-Ausgabe dieses Reports zitierte außerdem ein SEOmator-Panel über mehrere Seiten; diese Werte werden nicht fortgeführt, und diese Ausgabe berichtet nur über Cloudflares Netzwerk und unsere eigene Seite.
Verwendete Datendimensionen:
- Crawl-to-Refer-Verhältnis: Gecrawlte Seiten pro gesendetem Referral, nach Betreiber, monatlich (wöchentlich für OpenAI, Anthropic und Perplexity im September–Oktober)
- Referral-Quellenanteil: Referral-Traffic nach Quell-Domain (Cloudflare) und AI-Assistenten-Sessions (seomator.com)
- Referrer vs. utm-Tag: ChatGPT-Sessions auf seomator.com pro Woche, mit und ohne chatgpt.com-Referrer
- Client-Typ: Traffic-Klassifizierung (Mensch, Nicht-AI-Bot, AI Bot, Gemischter Zweck)
- User-Agent + Crawl-Zweck + Content-Typ: Crawler-Identifikation und was AI Bots abrufen
- Vertical / Branche: Traffic-Segmentierung nach Website-Kategorie
- Antwortstatus: Anteil der Crawler-Anfragen, die mit 2xx- und 4xx-Codes beantwortet werden
- Agent-Readiness + robots.txt-Analyse: 114.605 gescannte Domains; 4.367 geparste robots.txt-Dateien
Zeitraum: Cloudflare-Traffic-Daten: Kalendermonate Januar–September 2026 plus 1.–30. Oktober 2026. robots.txt und Agent-Readiness: 26. Oktober 2026. seomator.com: 1.–30. September und 1.–30. Oktober 2026.
Einschränkungen: Netzwerkweite Verhältnisse messen aggregiertes Verhalten; die Verhältnisse einzelner Seiten variieren je nach Content-Typ, Domain-Autorität und Traffic-Mustern. Die Referral-Attribution unterschätzt möglicherweise AI-getriebene Besuche, die über Zwischenseiten ankommen oder keinen Referrer-Header tragen, und ab Oktober 2026 gilt das für die meisten ChatGPT-Klicks, die wir beobachten können; ChatGPTs Referral-Anteil und OpenAIs Verhältnis unterschätzen ChatGPTs tatsächliche Referrals ab diesem Monat also. Radar berichtet Anteile und Verhältnisse, keine absoluten Anfragezahlen, und ein Verhältnis, das es als unendlich ausweist, bedeutet, dass es im Zeitraum Crawling, aber keine Referrals gezählt hat, und ist kein gemessener Wert. Der nicht klassifizierte Anteil der Crawler-User-Agents wuchs zwischen Juli und Oktober, kleine Verschiebungen in den User-Agent-Anteilen sind daher weniger verlässlich als große.
Cloudflare-Daten stammen aus Cloudflare Radar AI Insights und Bot & Crawler Analytics (Kalendermonate Januar–September 2026 plus 1.–30. Oktober 2026; robots.txt- und Agent-Readiness-Scans vom 26. Oktober 2026). seomator.com-Werte: SEOmator First-Party-Analytics, September–Oktober 2026. Zuletzt aktualisiert: 31. Oktober 2026.