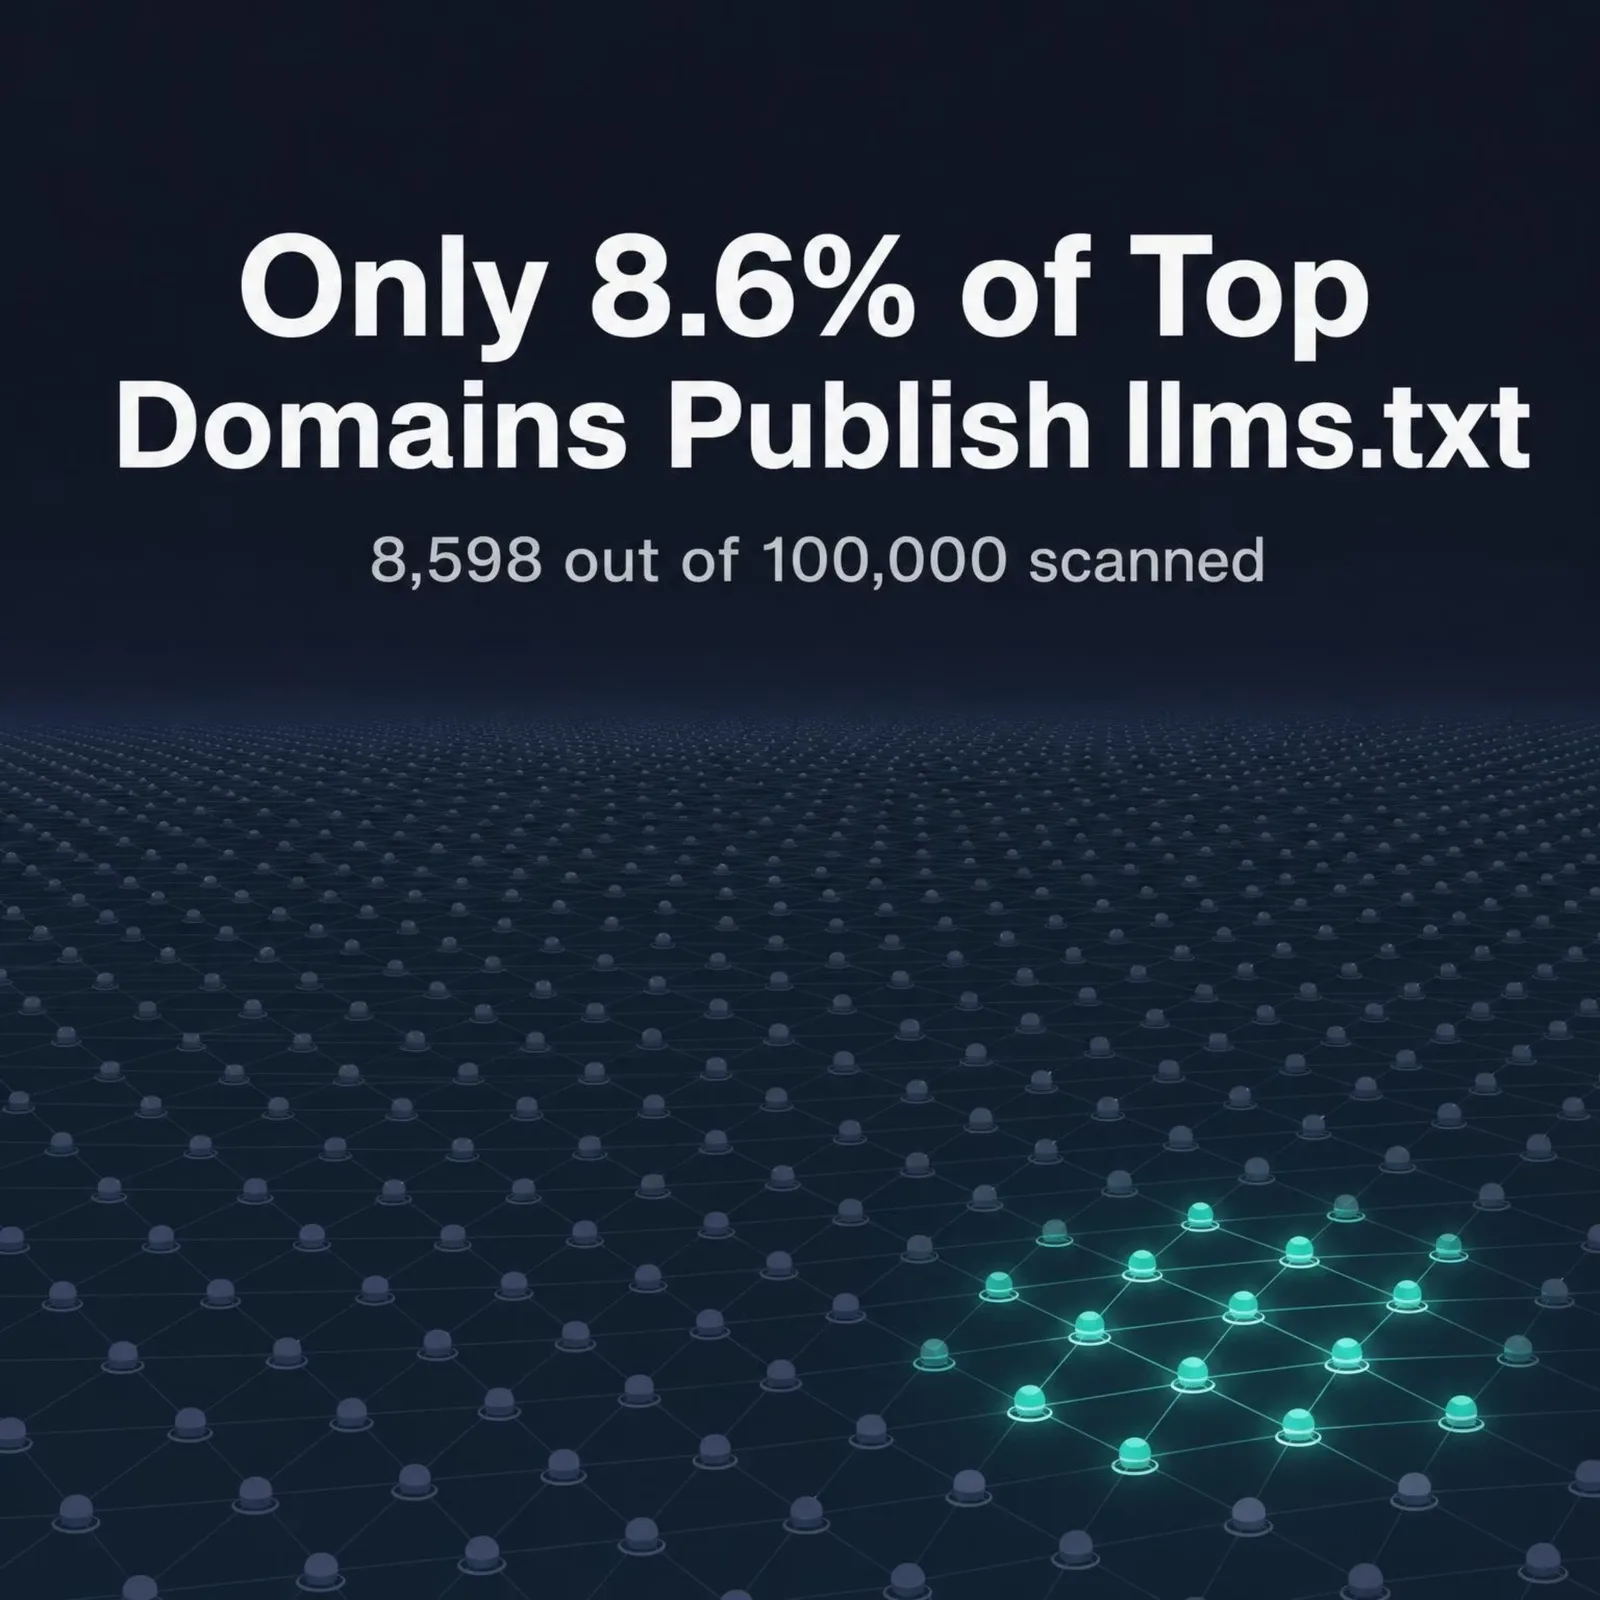
Von den Top 100.000 Domains des Webs veröffentlichen 8.598 eine llms.txt-Datei: 8,6 % der vollständigen Liste und 11,4 % der 75.353 Domains, die uns überhaupt geantwortet haben. Wir haben die Datei am 13. September 2026 bei jeder einzelnen von ihnen angefragt. Fast ein Drittel der Dateien, die wir gefunden haben, wurde automatisch von der Plattform der Website erzeugt.
Die wichtigsten Erkenntnisse aus unserer Erhebung vom 13. September 2026
- 8.598 von 100.000 Top-Domains veröffentlichen eine llms.txt (8,6 % der Grundgesamtheit, 11,4 % der Domains, die geantwortet haben).
- Mehr Domains täuschen eine vor, als eine haben. 10.775 lieferten unter
/llms.txt eine gewöhnliche HTML-Seite mit Status 200 aus. Ein Checker, der nur auf „200 OK“ achtet, zählt mehr als doppelt so viele Dateien, wie es tatsächlich gibt.
- Mindestens 29,8 % der Dateien tragen eine Plattform-Signatur. Shopify allein steht für 18,2 % aller llms.txt-Dateien, die wir gefunden haben; SEO-Plugins für WordPress kommen auf weitere 9,6 %.
- Die Dateien sind sauber aufgebaut und oft leer. 95,1 % beginnen genau so mit einer H1, wie es die Spezifikation verlangt, aber 16,4 % enthalten überhaupt keine Links.
.ai-Domains kommen auf eine Verbreitung von 39,3 %, gegenüber 11,4 % insgesamt. Es sind die Leute, die AI bauen, die auch Dateien dafür veröffentlichen.- 186 Domains liefern unter
/llms.txt ihre robots.txt aus.
Jede Seite, die derzeit für dieses Keyword rankt, erklärt, was das Format ist. Ich wollte etwas wissen, das Ihnen die Spezifikation nicht sagen kann: ob es überhaupt jemand nutzt, und wer.
Wie viele der Top 100.000 Domains haben tatsächlich eine llms.txt?
8.598 — 8,6 % der Top 100.000 Domains, gemessen am 13. September 2026. Beschränkt man den Nenner auf die 75.353 Domains, die überhaupt eine verwertbare Antwort lieferten, liegt die Quote bei 11,4 %. Die übrigen 24.647 liefen in einen Timeout, scheiterten am DNS oder verweigerten die Verbindung; wir haben sie deshalb ausgeschlossen, statt sie als fehlend zu werten.
Das ist die erste aktuelle Zahl mit Bezugsgröße, die ich für dieses Format kenne. Am häufigsten wiederholt wird eine Zählung von 951 Domains, die NerdyData im Juli 2025 veröffentlicht hat — eine absolute Zahl ohne angegebene Grundgesamtheit, inzwischen vierzehn Monate alt. Unsere ist eine Quote gegenüber einer benannten Liste an einem benannten Datum, und nur in dieser Form lässt sich sagen, ob die Verbreitung groß oder klein ist.
| Ergebnis der Anfrage | Domains | Anteil an 100.000 |
|---|
| Echte llms.txt veröffentlicht | 8.598 | 8,60 % |
| Stattdessen eine HTML-Seite ausgeliefert (Soft 404) | 10.775 | 10,78 % |
| Normaler 404 oder anderer Fehler | 55.182 | 55,18 % |
| Nie geantwortet (Timeout, DNS, abgelehnt) | 24.647 | 24,65 % |
| Leere oder Platzhalter-Datei ausgeliefert | 592 | 0,59 % |
| robots.txt unter diesem Pfad ausgeliefert | 186 | 0,19 % |
| Sonstiges (JavaScript-Payloads, Bot-Challenges) | 20 | 0,02 % |
📊In Zahlen: 8.598 der Top 100.000 Domains des Webs veröffentlichen eine llms.txt (13. September 2026). Zum Vergleich: In unserem Scan von 109.440 Top-Domains im Juli 2026 hatten 81,2 % Regeln für AI-Crawler in ihrer robots.txt veröffentlicht. Websites schreiben Direktiven für Agenten rund neunmal bereitwilliger, als sie irgendetwas für sie bauen.
Die Verbreitung ist gering, aber sie ist nicht nichts. 8.598 Domains liegen eine Größenordnung über der letzten öffentlichen Schätzung, und das Format ist kaum zwei Jahre alt.
Wer llms.txt wirklich veröffentlicht, und warum das meist keine Entscheidung ist
Hier hört die Zahl auf, das zu bedeuten, was man annehmen würde. Mindestens 29,8 % aller llms.txt-Dateien, die wir gefunden haben, tragen eine erkennbare Plattform- oder Plugin-Signatur — Text in der Datei selbst, der das Tool nennt, das sie geschrieben hat.
| Generator | Dateien | Anteil an den 8.598 gefundenen |
|---|
| Shopify | 1.561 | 18,2 % |
| Yoast | 463 | 5,4 % |
| All in One SEO | 214 | 2,5 % |
| Rank Math | 146 | 1,7 % |
| Wix | 83 | 1,0 % |
| HubSpot | 39 | 0,5 % |
| Andere signierte Generatoren | 59 | 0,7 % |
| Keine Signatur erkannt | 6.033 | 70,2 % |
Shopify allein hat fast jede fünfte llms.txt auf den größten Domains des Webs geschrieben. Nimmt man die drei SEO-Plugins für WordPress hinzu, kommen 27,8 % von vier Anbietern.
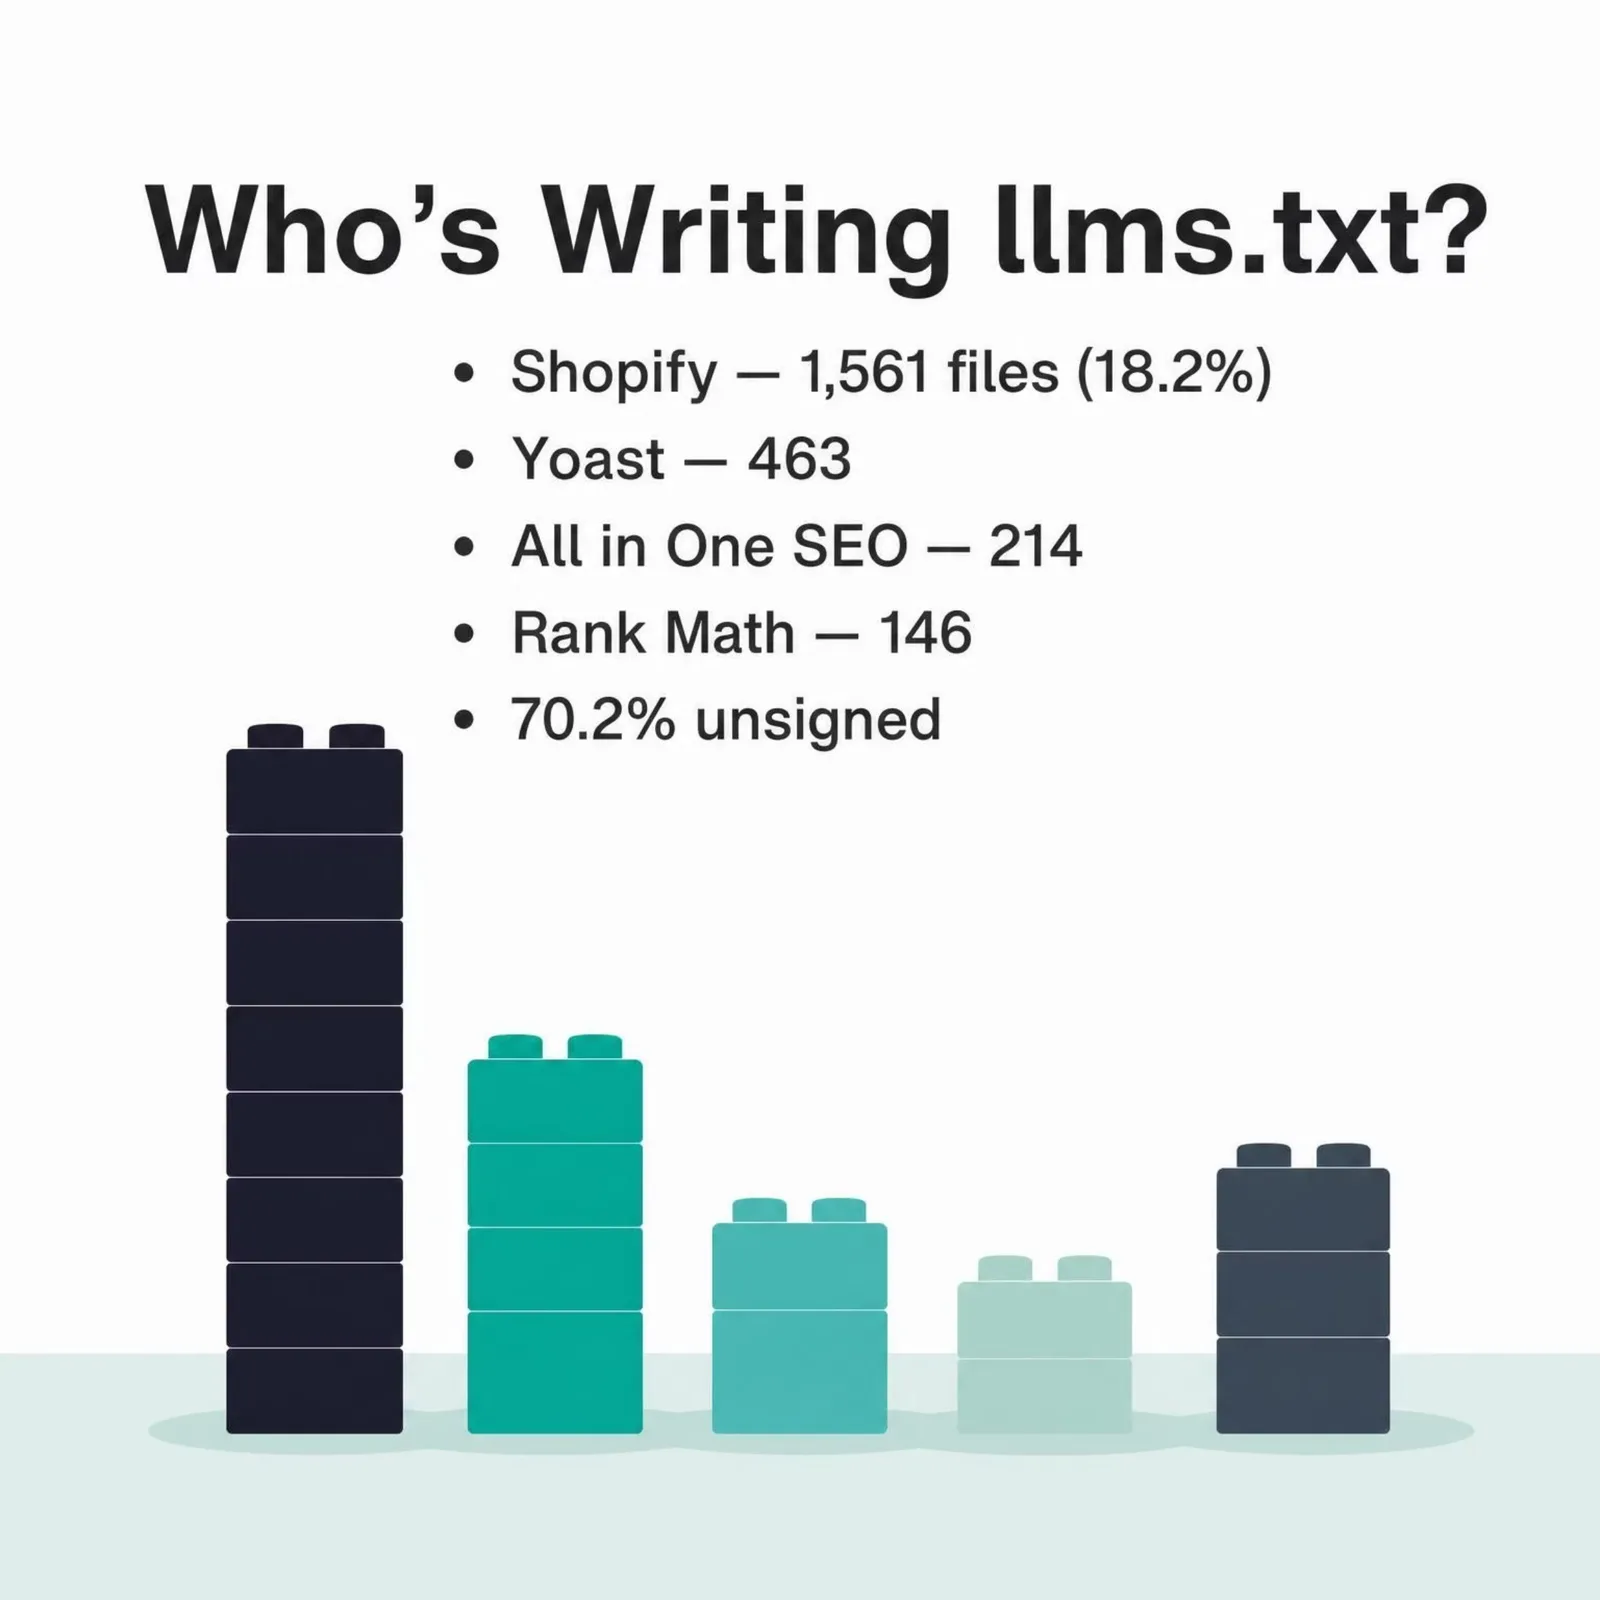
Bei den 70,2 % ohne Signatur will ich vorsichtig sein, denn das ist die Zahl in dieser Studie, die sich am leichtesten falsch lesen lässt. Sie ist kein Maß für handgeschriebene Dateien. Die meisten Generatoren kennzeichnen ihre Ausgabe überhaupt nicht, also mischt diese Gruppe bewusste Autorschaft mit unsignierter Automatisierung. Verstehen Sie 29,8 % als Untergrenze der plattformgenerierten Verbreitung, nicht als Schätzung dafür.
⚠️Häufiger Fehler: Ein Verbreitungsdiagramm als Maß für Absicht lesen. Eine Website, die Shopify aktualisiert und dabei eine llms.txt geerbt hat, hat nichts über AI-Suche entschieden. Wenn Sie „die Verbreitung wächst“ lesen, fragen Sie, wie viel von diesem Wachstum ein einziger Anbieter ist, der eine Standardeinstellung ausliefert.
Google hat dieses Muster an sich selbst vorgeführt. Wie Search Engine Roundtable berichtete, tauchten llms.txt-Dateien in Googles Entwicklerdokumentation auf, weil das CMS, das Google nutzt, das Format zu unterstützen begann, und nicht, weil sich ein Team dafür entschieden hatte. Das Search-Team entfernte sie daraufhin aus seiner eigenen Dokumentation, während andere Teams ihre stehen ließen. Auf Bluesky gefragt, ob die Datei unter ai.google.dev eine Empfehlung sei, antwortete John Mueller, er sei versucht, etwas Bissiges zu sagen, weil das Thema so oft aufkomme, aber direkt gesagt: nein („I'm tempted to say something snarky since this has come up so often, but to be direct, no.“).
Diese Datei ist immer noch da. Ich habe am 13. September 2026 nachgesehen: ai.google.dev/api/llms.txt antwortet mit 200, dem Content-Type text/markdown und einer sauber aufgebauten Link-Map.
Welche Ecken des Webs haben sie tatsächlich übernommen?
Die Verbreitung nach Top-Level-Domain aufzuschlüsseln, zeigt am klarsten, wem dieses Format derzeit gehört. Gegenüber einer Gesamtquote von 11,4 % unter den Domains, die geantwortet haben, ist die Streuung groß.
| TLD | Domains mit llms.txt | Antwortende Domains | Verbreitungsquote |
|---|
.ai | 224 | 570 | 39,3 % |
.io | 409 | 1.645 | 24,9 % |
.co | 106 | 519 | 20,4 % |
.au | 78 | 561 | 13,9 % |
.com | 5.217 | 38.849 | 13,4 % |
.ru | 188 | 1.656 | 11,4 % |
.uk | 124 | 1.317 | 9,4 % |
.de | 112 | 1.608 | 7,0 % |
.jp | 34 | 522 | 6,5 % |
.net | 193 | 3.492 | 5,5 % |
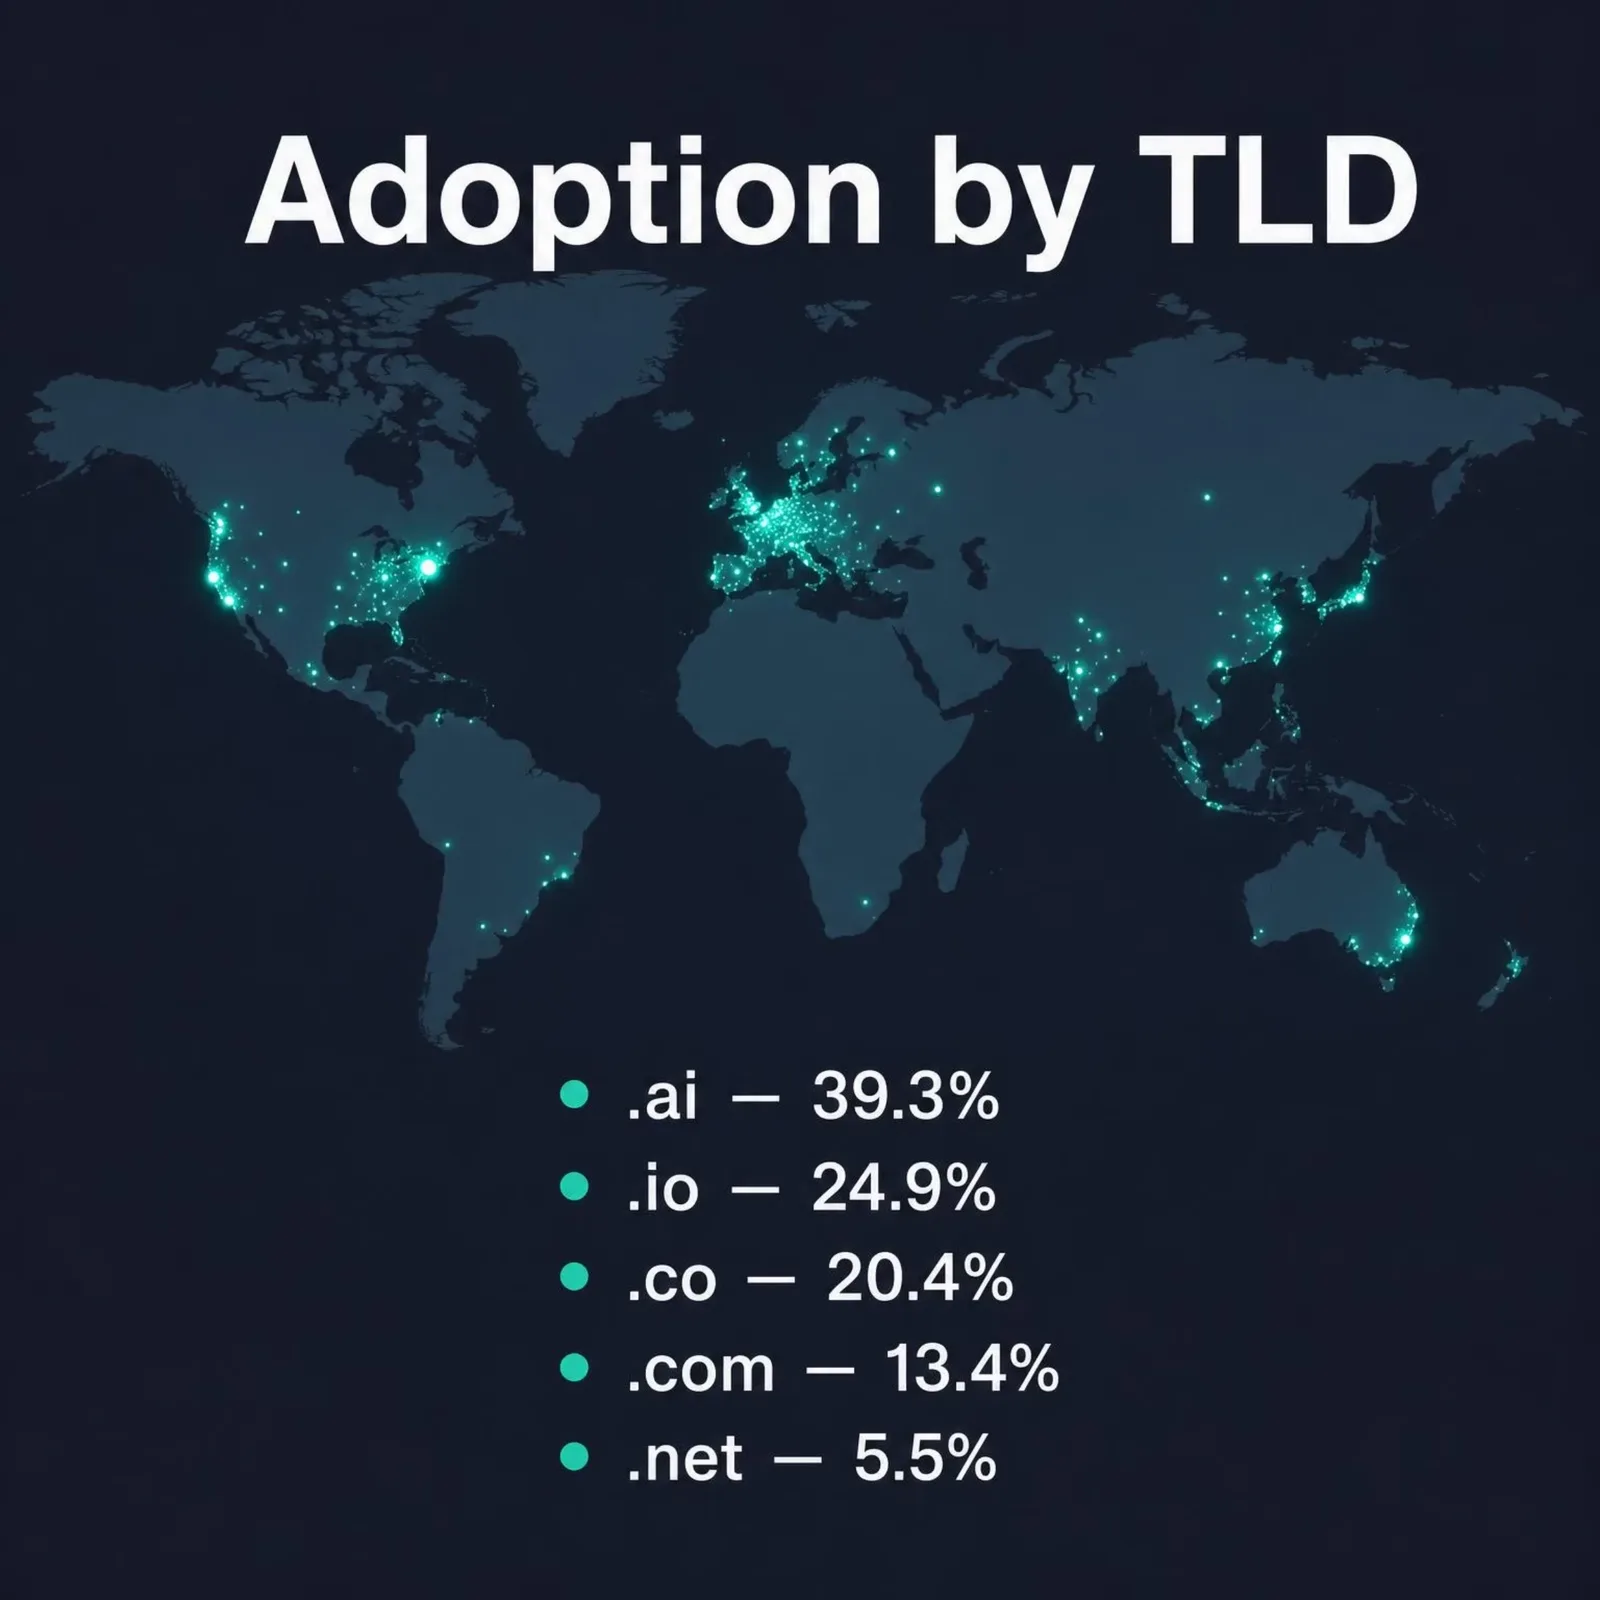
Zwei von fünf .ai-Domains veröffentlichen eine llms.txt. Das ist das 3,4-Fache der Gesamtquote, und .io folgt dicht dahinter mit 24,9 %. Am anderen Ende liegt .net bei 5,5 %, und die großen europäischen und japanischen Länderdomains bewegen sich zwischen 6 % und 9 %.
Lesen Sie diese Tabelle als Karte einer Insider-Gruppe. Die Unternehmen, die AI-Produkte bauen, und die Entwicklertool-Szene auf .io haben eine Konvention übernommen, die der Rest des Webs weitgehend ignoriert hat. Das passt dazu, wo die Datei nachweislich ausgeliefert wird: in Dokumentationen und API-Referenzen, geschrieben von Leuten, die beruflich mit Agenten sprechen.
💡Kurz gesagt: Eine Verbreitung von 39,3 % auf .ai gegenüber 5,5 % auf .net misst nicht, welche Websites besser optimiert sind. Sie misst, welche Websites dieselben Newsletter lesen.
Taugen die veröffentlichten llms.txt-Dateien etwas?
Größtenteils sind sie sauber aufgebaut. 95,1 % der 8.598 Dateien beginnen mit einem H1-Titel, und das ist die eine Strukturregel, bei der die llms.txt-Spezifikation streng ist. Diesen Teil beherrschen Generatoren gut.
Bei der Substanz wird es dünner. 1.407 Dateien — 16,4 % — enthalten keinen einzigen Markdown-Link. Das Format soll eine kuratierte Karte sein, die einen Agenten zu den besten Inhalten einer Website führt. Eine Karte ohne Ziele ist Dekoration.
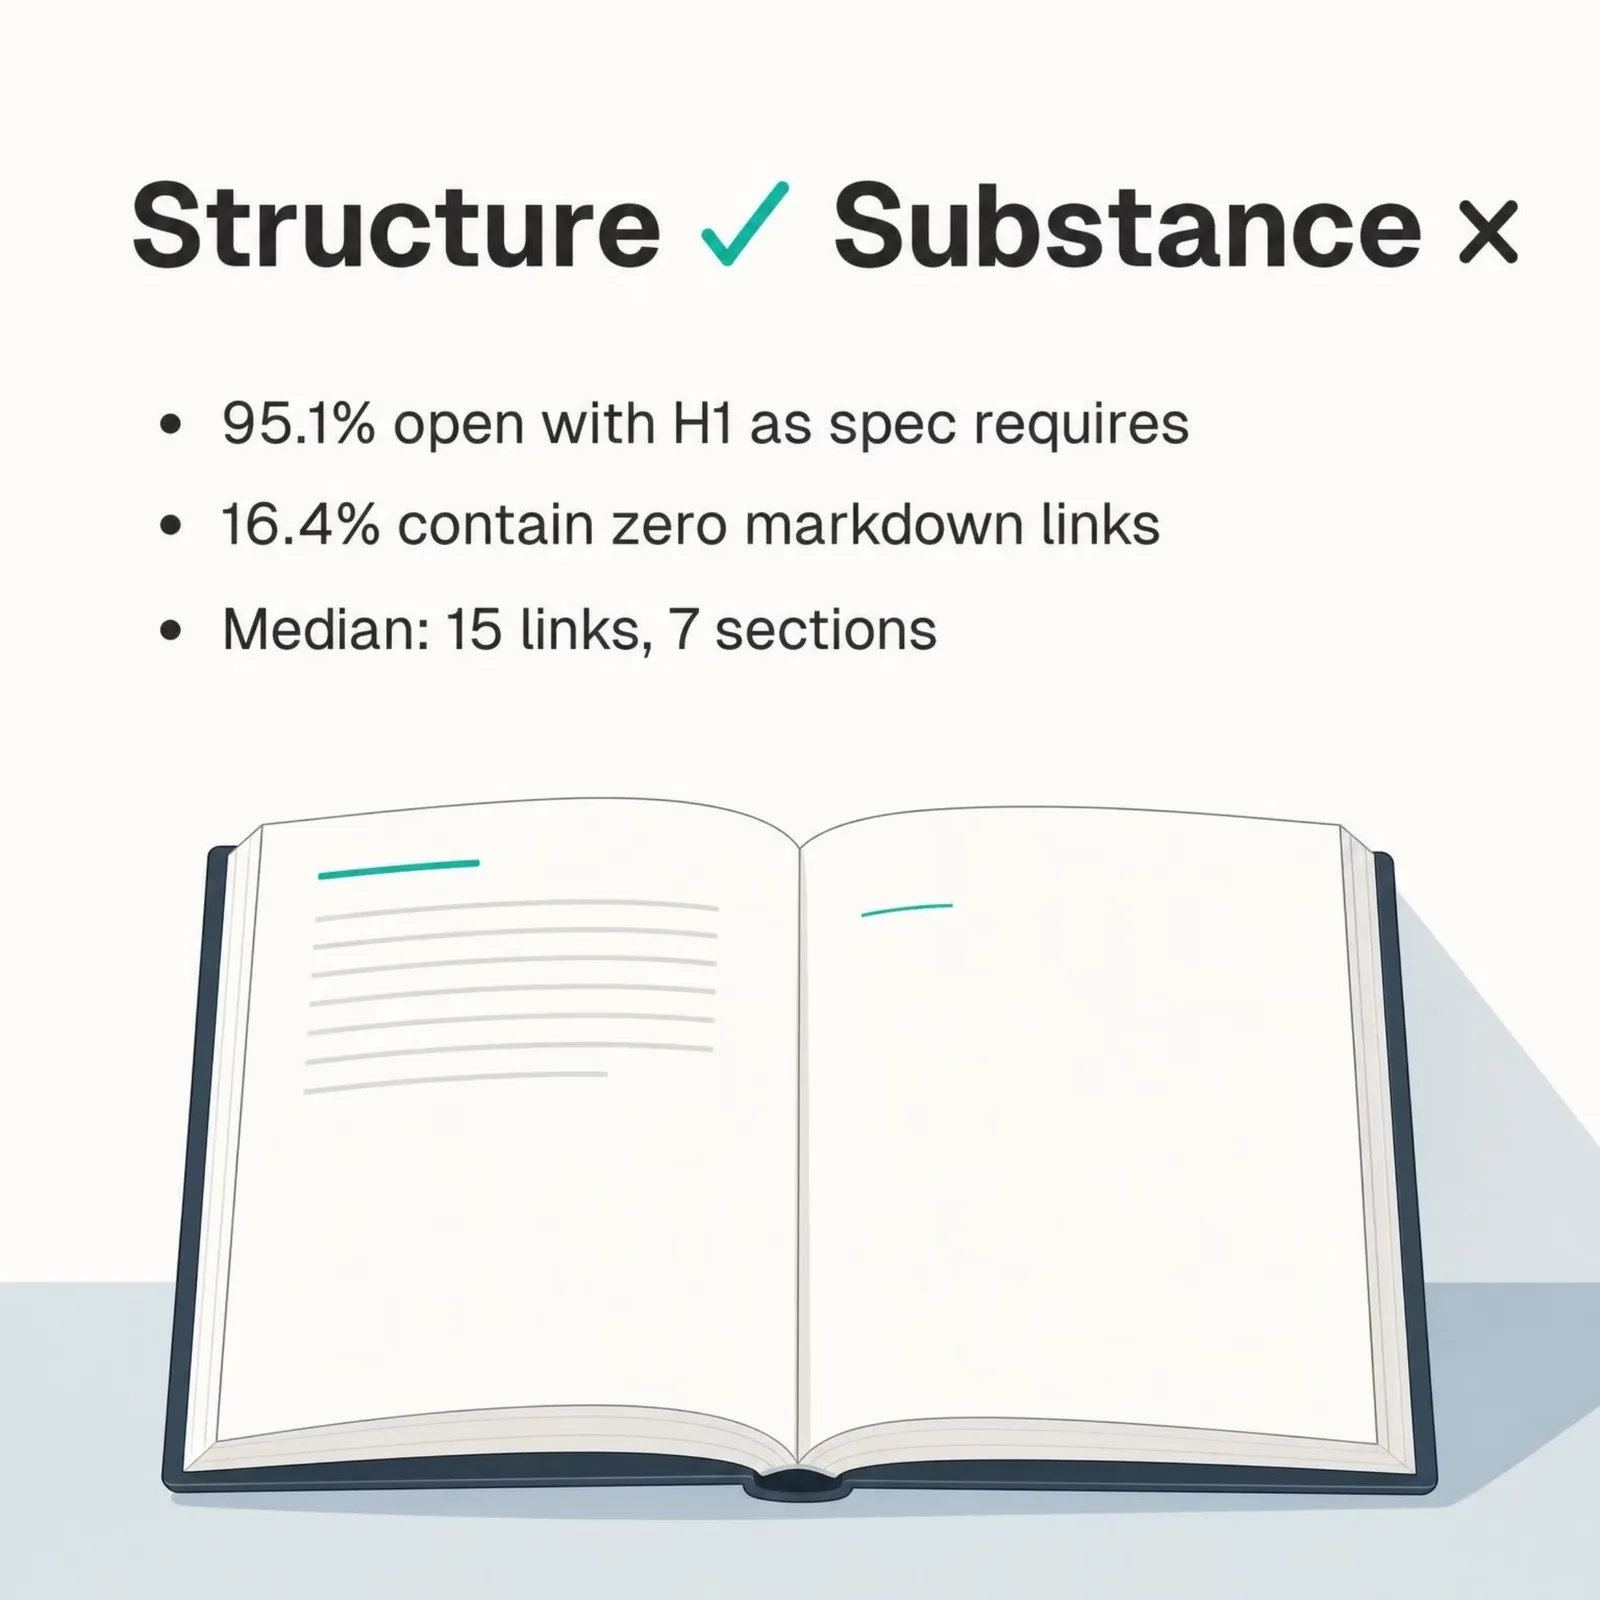
Die typische Datei ist allerdings ordentlich:
| Kennzahl | Median über die 8.598 Dateien |
|---|
| Dateigröße | 4.542 Bytes |
| Aufgeführte Links | 15 |
| Abschnitte (H2 oder tiefer) | 7 |
🔑Zum Mitnehmen: Formatkonformität und Nützlichkeit sind verschiedene Probleme. 95,1 % der veröffentlichten llms.txt-Dateien haben die Struktur richtig, während 16,4 % nichts auflisten, was ein Agent abrufen könnte. Wenn Sie eine veröffentlichen, sind die Links das Produkt.
Und was ist mit llms-full.txt?
Die Begleitkonvention ist llms-full.txt, die den eigentlichen Inhalt einer Website enthalten soll statt einer Liste von Links darauf. Um das zu prüfen, haben wir alle 8.598 Domains ein zweites Mal gescannt.
2.516 davon — 29,3 % — veröffentlichen zusätzlich eine. Das sind 2,5 % der Top 100.000 insgesamt; ungefähr jede dritte Website, die sich überhaupt mit diesem Format befasst, geht also den zusätzlichen Schritt.
Dann haben wir die beiden Dateien auf jeder Domain verglichen, und das Ergebnis ist das schärfste Qualitätssignal der Studie. Eine „full“-Datei sollte um ein Vielfaches größer sein als der Index, der auf sie verweist. Stattdessen:
| Verhältnis der beiden Dateien | Domains | Anteil an den 2.516 |
|---|
llms-full.txt weicht höchstens 5 % von der Größe der llms.txt ab | 1.259 | 50,0 % |
llms-full.txt mindestens doppelt so groß | 568 | 22,6 % |
| Auf das Byte gleich groß | 169 | 6,7 % |
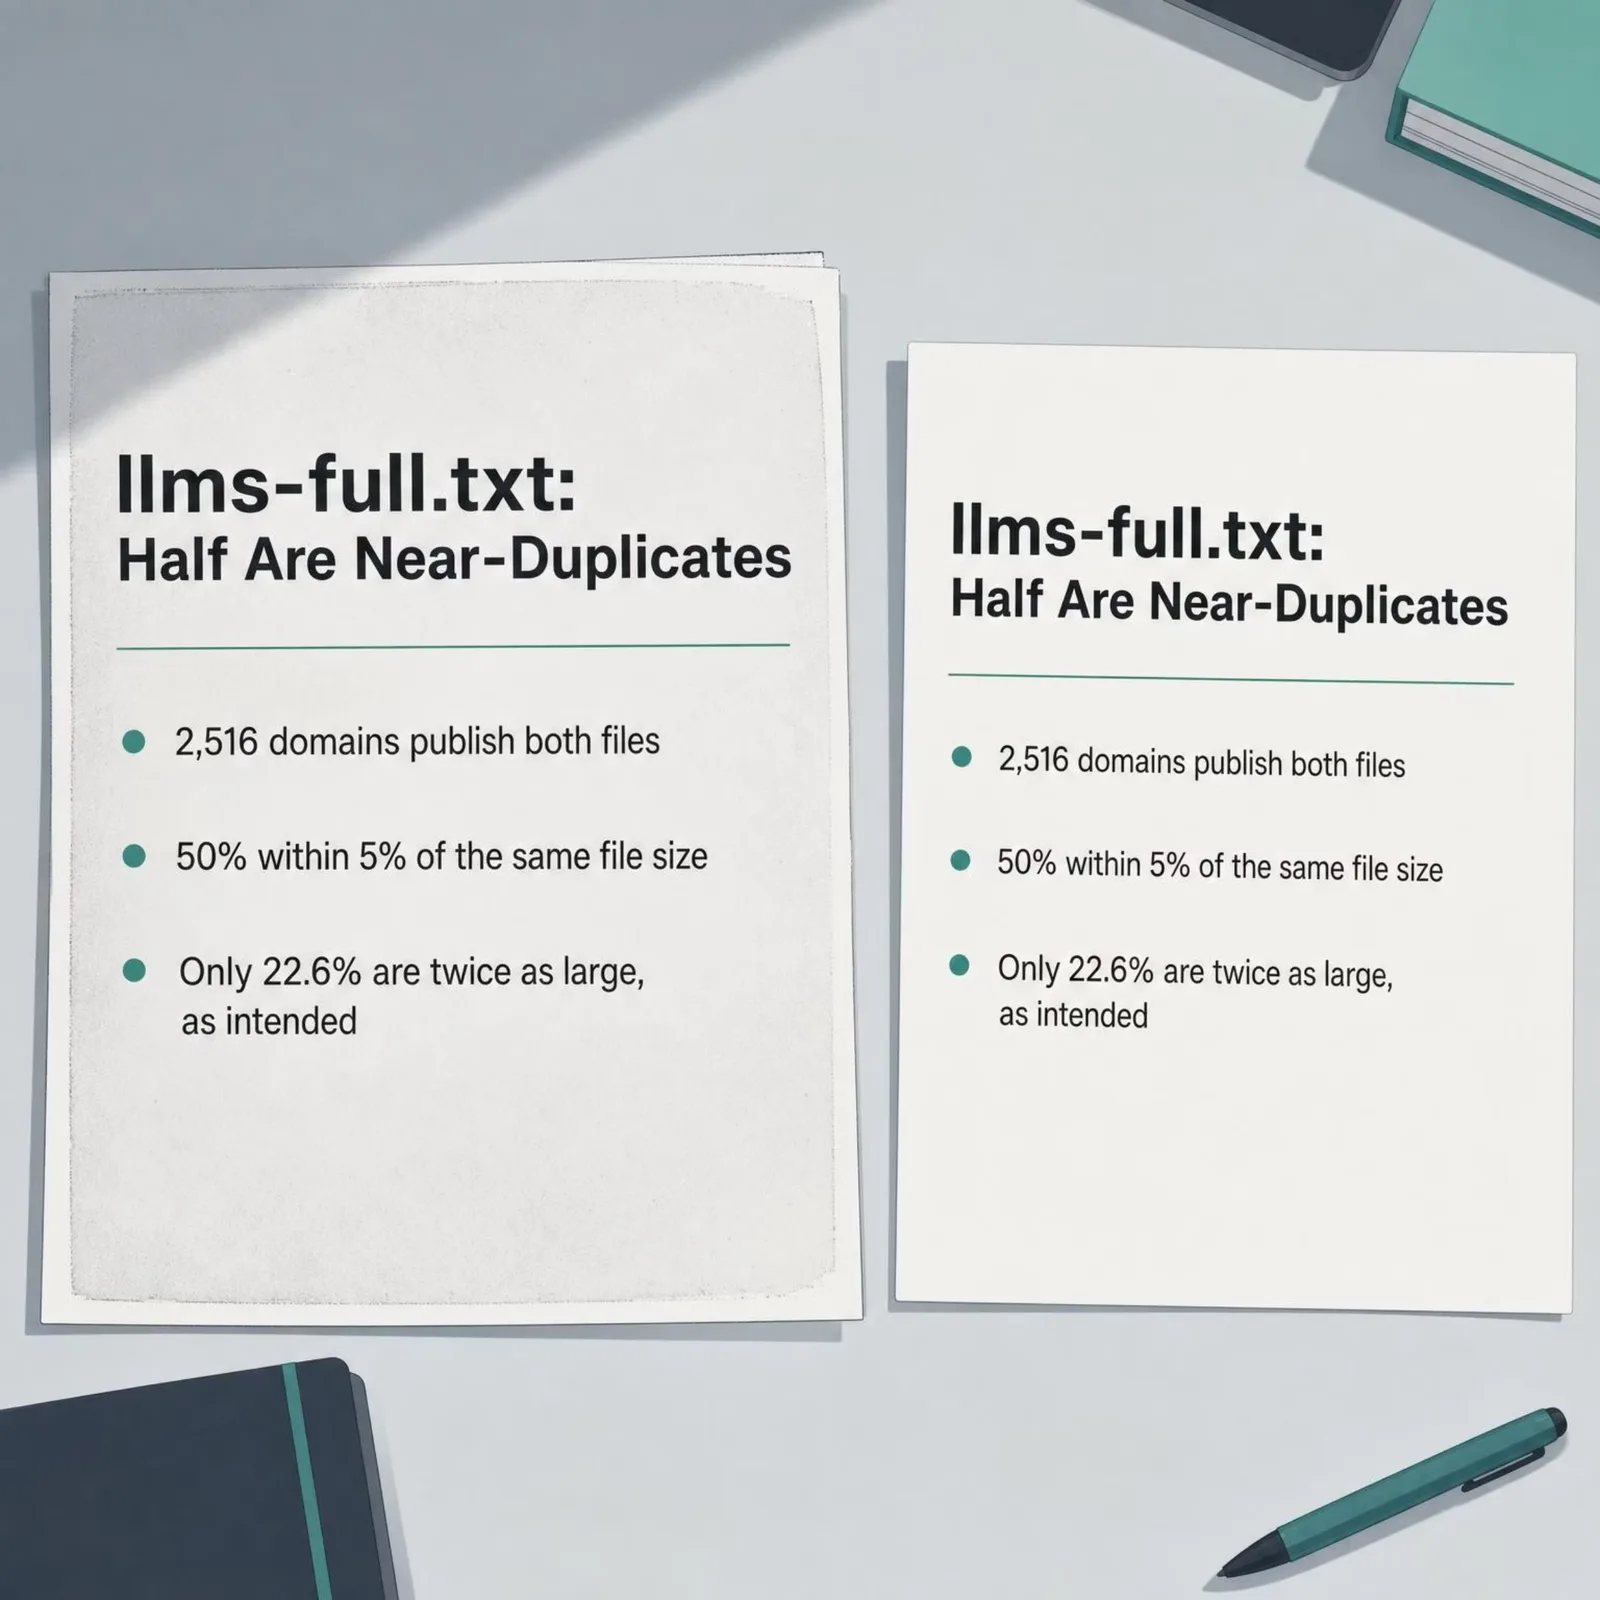
Die Hälfte der Websites, die beide Dateien veröffentlichen, liefert im Grunde zweimal dieselbe Datei aus. Der Median der von uns gemessenen llms-full.txt liegt bei 4.521 Bytes, gegenüber 4.542 Bytes für den Median der llms.txt — zwei Namen für ein Dokument. Nur 22,6 % enthalten den wesentlich größeren Inhaltsbestand, den die Konvention nahelegt.
Liest überhaupt irgendetwas die llms.txt?
Kein großer AI-Anbieter hat dokumentiert, dass er sie verarbeitet, und Google hat direkt gesagt, dass es sie nicht nutzt. Mueller hat außerdem argumentiert, dass LLM-Systeme die llms.txt nicht nutzen können, um Websites bei der Entdeckung voneinander zu unterscheiden; eine Rolle sieht er erst, wenn ein Agent bereits auf einer Website ist — eine Position, über die Search Engine Journal ausführlich berichtet hat.
Als Gegenbeleg wird gern angeführt, dass AI-Unternehmen die Datei selbst veröffentlichen. Das stimmt, mit einem Detail, das man kennen sollte. Am 13. September 2026 habe ich die naheliegenden Kandidaten geprüft: docs.anthropic.com, docs.perplexity.ai und developers.cloudflare.com liefern alle eine aktive llms.txt aus. Ihre Root-Domains nicht — anthropic.com antwortet mit 404, ebenso platform.openai.com.
Das Muster sind also Dokumentationsseiten, die strukturiertes Markdown an Agenten ausliefern, die bei einer Dokumentation ankommen. Das ist ein echter Anwendungsfall. Es ist kein Beleg dafür, dass eine Such- oder Antwortmaschine die Datei liest, um zu entscheiden, was sie zitiert.
In Tools hat das Format allerdings Fuß gefasst. Lighthouse in Chrome bringt unter seinen Agentic-Browsing-Prüfungen ein llms.txt-Audit mit; Teams werden also inzwischen von einem Standard-Entwicklertool zu der Datei gedrängt, unabhängig davon, ob irgendeine Suchmaschine sie verarbeitet.
💡Kurz gesagt: Ehrlich zusammengefasst wird llms.txt von Publishern und Tools gut unterstützt und von den Konsumenten gar nicht. Wenn Sie wissen wollen, was AI-Crawler auf Ihrer Website wirklich tun, messen Sie die Anfragen statt der Direktiven — unser
AI Crawler Report verfolgt, welche Bots tatsächlich auftauchen.
llms.txt vs. robots.txt: die Verwechslung, die sich in den Daten zeigt
Diese beiden Dateien werden ständig in einem Atemzug genannt, und 186 Domains in unserem Scan haben das wörtlich genommen: Sie liefern unter /llms.txt ihre robots.txt aus. Die Antwort beginnt mit Zeilen wie User-agent: und Disallow: statt mit Markdown.
186 von 100.000 sind ein Rundungsfehler. Ich berichte davon, weil es ein sauberes, zählbares Signal für eine Verwechslung ist, die sich überall in der Diskussion zeigt, und weil die beiden Dateien wirklich gegensätzliche Aufgaben haben.
- robots.txt ist eine Zugriffsdirektive. Sie sagt Crawlern, was sie anfragen dürfen, und Crawler halten sich daran.
- llms.txt ist eine Inhaltskarte. Sie schlägt vor, was lesenswert ist, und nichts ist verpflichtet, hineinzusehen.
Die eine ist verbindlich. Die andere ist eine Empfehlung, die anzunehmen niemand zugesagt hat. Wenn Sie nur Zeit haben, eine davon richtig hinzubekommen, dann nicht die neue — Ihre eigene können Sie mit unserem robots.txt-Tester auf Plausibilität prüfen.
Die größere Messfalle in diesem Bereich ist der Soft 404. 10.775 Domains lieferten unter /llms.txt eine gewöhnliche HTML-Seite mit Status 200 aus — mehr als die 8.598, die tatsächlich eine veröffentlichen. Viele Websites antworten auf jeden erfundenen Pfad mit 200. Jede Verbreitungsstudie, die Statuscodes zählt, ohne den Body zu prüfen, meldet eine Zahl, die mehr als doppelt so hoch ist wie die richtige.
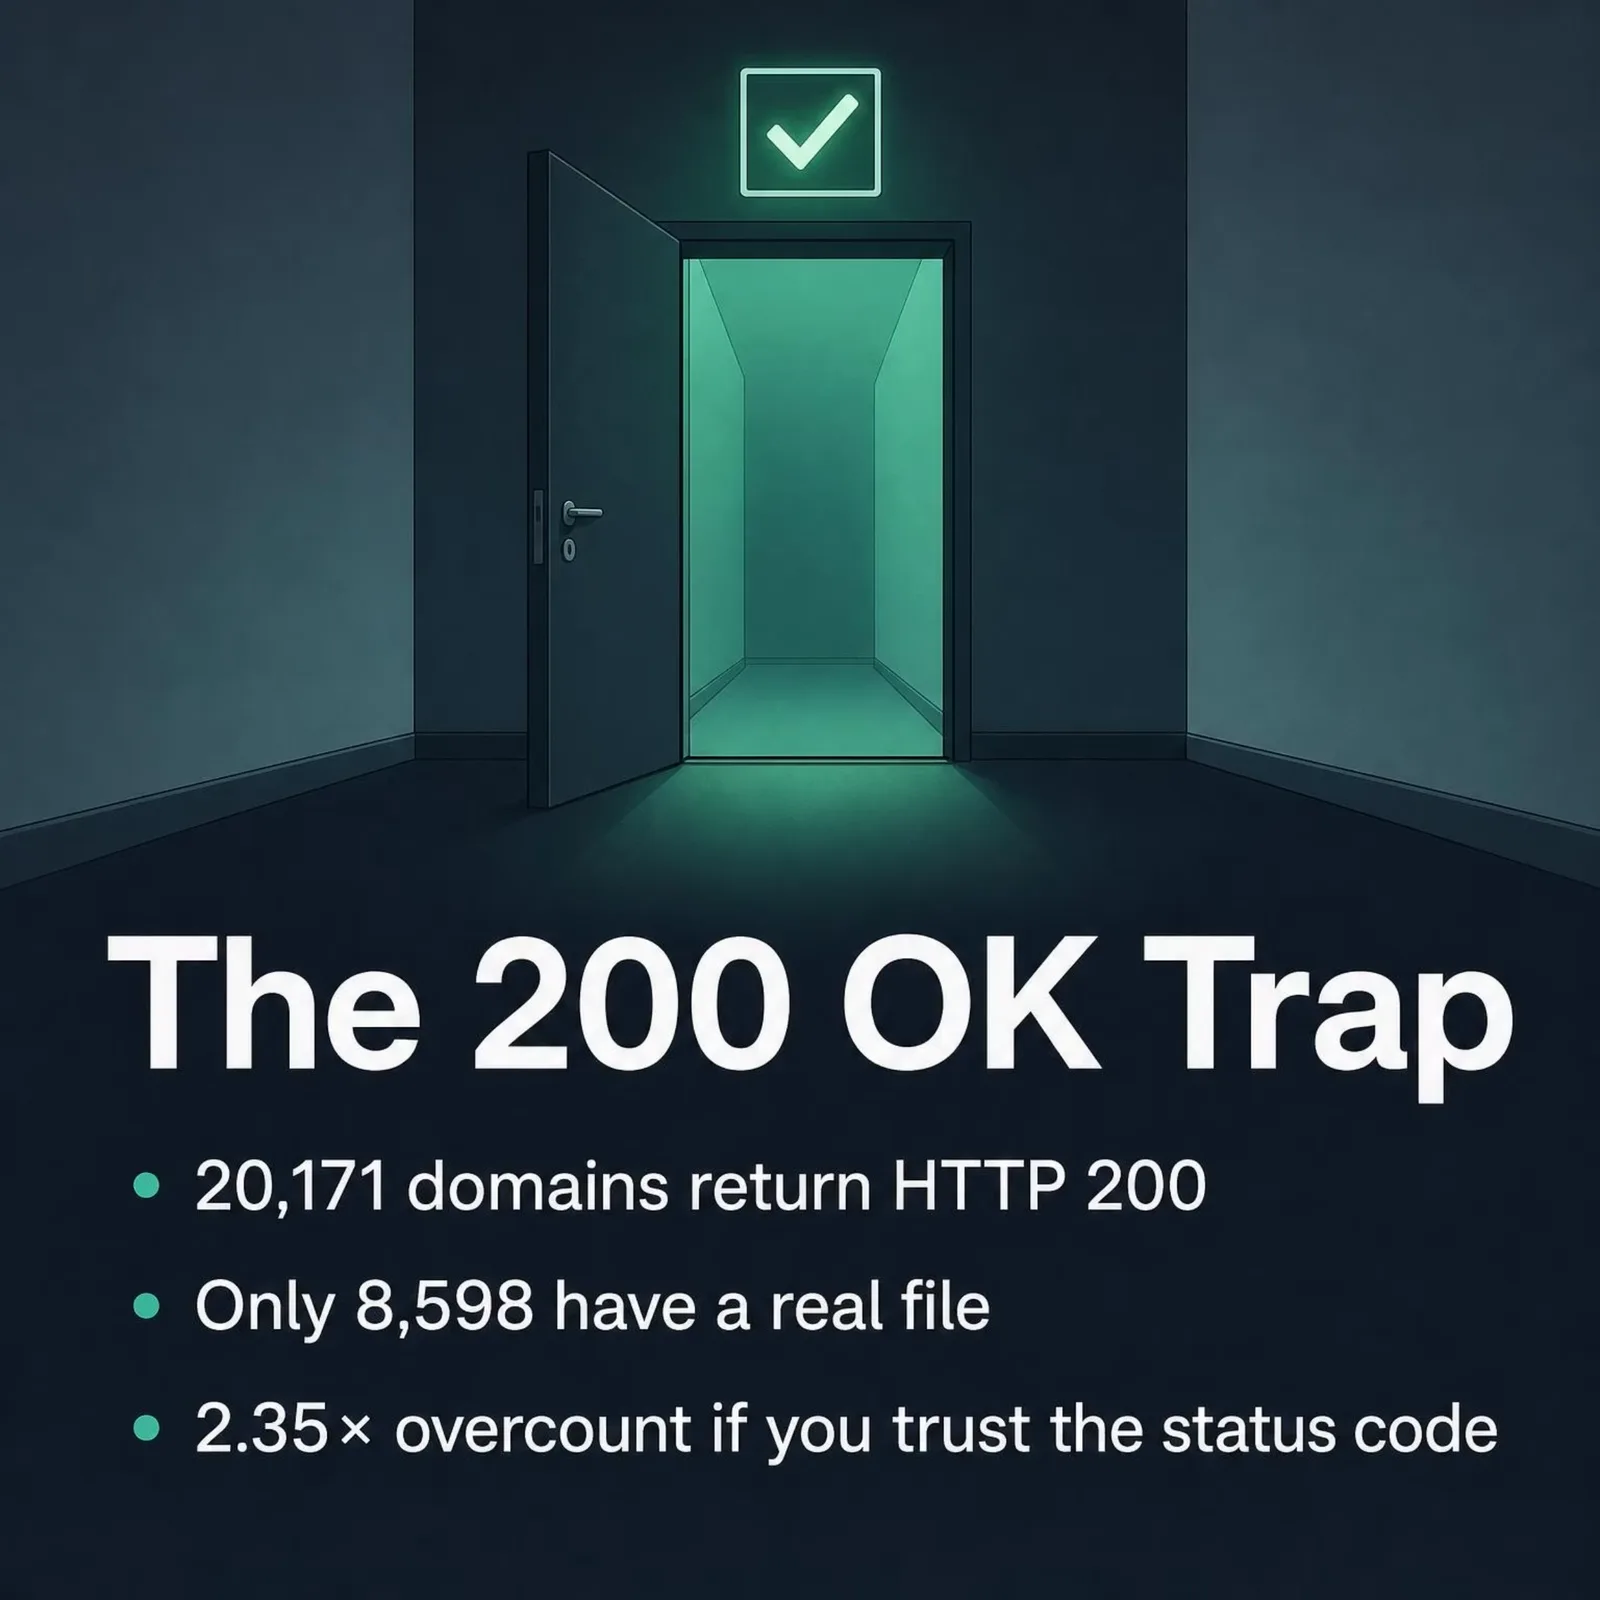
🚩Warnsignal: Wenn ein Tool Ihnen sagt, ein Wettbewerber „hat eine llms.txt“, öffnen Sie sie. Nach unseren Zahlen sehen Sie eher eine Soft-404-HTML-Seite (10.775 Domains) als eine echte Datei (8.598).
Was unsere Audit-Daten über AI-Readiness jenseits von llms.txt sagen
llms.txt ist ein schmaler Ausschnitt einer viel größeren Lücke. Unsere Audit-Engine bewertet auf jeder Website, die sie prüft, eine Kategorie für AI/GEO-Readiness, und diese Kategorie fällt bei 54,6 % der auditierten Websites durch — sie umfasst standardmäßig blockierte AI-Bots, schwaches semantisches HTML und fehlende strukturierte Inhalte.
Die Entwicklung ist wirklich positiv, und das geht im Zynismus rund um dieses Thema meiner Meinung nach unter. Der Anteil der Websites, die bei der AI/GEO-Readiness durchfallen, sank von 58,1 % im Januar 2026 auf 53,9 % bis Juni; damit ist sie die Kategorie, die sich von allen, die wir messen, am schnellsten verbessert.
Stellt man das neben unseren Agent-Readiness-Scan von 109.440 Top-Domains aus dem Juli 2026, wird die Form des Problems deutlich:
| Signal | Anteil der Top-Domains | Was es kostet |
|---|
| robots.txt-Regeln für AI-Crawler | 81,2 % | Eine Zeile Text |
| Sitemap veröffentlicht | 70,4 % | Wird automatisch erzeugt |
| llms.txt veröffentlicht (diese Erhebung, Sept. 2026) | 8,6 % | Eine Datei, wenn Sie sie aktuell halten |
| Liefert Agenten Markdown aus | 6,6 % | Echte Entwicklungsarbeit |
| Veröffentlicht eine MCP-Server-Card | 0,26 % | Echte Entwicklungsarbeit |
Der Aufwand sagt die Verbreitung fast perfekt voraus. Websites erledigen die billigen deklarativen Dinge und lassen die eigentliche Arbeit aus. GPTBot und ClaudeBot sind die beiden am häufigsten genannten Agenten in den robots.txt-Dateien, die wir auswerten, und das zeigt, wohin die Aufmerksamkeit wirklich geht: in die Entscheidung, wer hereindarf, nicht in die Vorbereitung auf sie, wenn sie erst einmal durch die Tür sind.
Wenn Sie das größere Bild dazu wollen, was diese Crawler nehmen und was sie zurückschicken: Das Crawl-to-Refer-Verhältnis haben wir separat gemessen, und unsere Übersicht der AI-SEO-Statistiken verfolgt die Trendlinien.
Sollten Sie eine llms.txt-Datei anlegen? Ein ehrlicher Entscheidungsrahmen
Unsere eigenen Daten geben nicht her, Ihnen zur Eile zu raten. Sie geben aber auch nicht her, Ihnen davon abzuraten. Die Kosten liegen nahe null und die Belege für einen Nutzen ebenfalls, also hängt die Antwort davon ab, was für eine Website Sie betreiben.
Anlegen, wenn: Sie Dokumentation, eine API-Referenz oder eine große technische Wissensdatenbank veröffentlichen. In diesem Fall kommen Agenten bereits mit einer konkreten Frage an, die Datei wird nachweislich von Anbietern ausgeliefert, die sich in diesem Bereich auskennen, und das Markdown haben Sie wahrscheinlich schon.
Der Plattform überlassen, wenn: Sie Shopify, Wix, HubSpot oder WordPress mit einem SEO-Plugin nutzen. Die Chancen stehen gut, dass Sie schon eine haben. Prüfen Sie das, bevor Sie irgendetwas von Hand schreiben.
Weglassen, wenn: Sie eine Linkliste von Hand pflegen müssten, die nach einem Monat veraltet ist. Eine falsche Karte ist schlimmer als gar keine, und 16,4 % der Dateien, die wir gefunden haben, listen schon jetzt überhaupt nichts auf.
Wie auch immer Sie sich entscheiden, lassen Sie die Datei nicht die eigentliche Arbeit ersetzen. Eine Datei, die zu lesen sich keine Suchmaschine verpflichtet hat, ist kein Ersatz für Inhalte, die eine Suchmaschine parsen, zitieren und zuordnen kann.
📌Profi-Tipp: Bevor Sie eine llms.txt schreiben, stellen Sie sicher, dass Ihre Website für die Crawler erreichbar ist, die es tatsächlich gibt. Führen Sie ein
GEO-Audit durch, um zu sehen, wie Ihre Seiten für einen AI-Crawler aussehen, und ein
kostenloses SEO-Audit für die Rendering- und Strukturprobleme darunter.
Wenn Sie eine veröffentlichen: So sieht laut den Daten eine gute aus
Wir haben 8.598 echte Dateien gemessen, die Form einer normalen ist also keine Vermutung. Der Median listet 15 Links in 7 Abschnitten auf 4.542 Bytes. Das ist die Messlatte, und sie ist bescheiden — ein Nachmittag Arbeit, kein Projekt.
Vier Dinge unterscheiden die nützlichen Dateien von den dekorativen:
- Setzen Sie Links hinein. Das klingt selbstverständlich, bis man sieht, dass 1.407 veröffentlichte Dateien keinen einzigen enthalten. Das Format ist eine Karte. Eine Karte ohne Ziele ist ein Titelblatt.
- Beginnen Sie mit einer H1 und lassen Sie eine Zusammenfassung als Blockquote folgen. 95,1 % der Dateien haben die H1 richtig, und sie ist das Einzige, worauf die Spezifikation besteht. Die Zusammenfassung darunter sagt einem Agenten, was Ihre Website eigentlich ist.
- Verweisen Sie auf Ihre besten Inhalte, nicht auf Ihre ganze Sitemap. Der Wert einer kuratierten Liste ist die Kuratierung. Wenn Sie jede URL auflisten wollen, die Sie haben, gibt es dafür schon eine Sitemap, und unser Site-Crawler erzeugt eine genauere.
- Lassen Sie
llms-full.txt weg, wenn Sie es nicht ernst meinen. Die Hälfte der Websites, die beide veröffentlichen, liefert nahezu identische Dateien aus. Wenn Ihre „full“-Datei nicht wesentlich größer ist als Ihr Index, bringt sie zusätzlichen Pflegeaufwand und sonst nichts.
Dann tragen Sie sich die Überprüfung in den Kalender ein. Eine Link-Map ist eine Momentaufnahme einer Website, die sich ständig ändert, und eine veraltete Karte ist der eine Fehlerfall, der einen Agenten, der sie tatsächlich liest, aktiv in die Irre führen kann.
So prüfen Sie eine Website richtig
Wenn Sie Ihre eigene Website oder die eines Wettbewerbers auditieren, trauen Sie keinem grünen Häkchen. Unsere Soft-404-Zählung ist der Grund: Mehr Top-Domains liefern unter diesem Pfad eine HTML-Seite aus als eine echte Datei, also liegt jede Prüfung, die beim Statuscode aufhört, öfter falsch als richtig.
Fragen Sie die URL an und lesen Sie die erste Zeile des Bodys. Eine echte llms.txt beginnt mit # und einem Website-Namen. Bekommen Sie <!DOCTYPE html>, hat die Website keine. Bekommen Sie User-agent:, hat jemand die falsche Datei eingebunden — wie 186 Domains in unserer Erhebung.
Für die Signale, auf die AI-Crawler nachweislich reagieren, prüft das GEO-Audit die Readiness-Kategorie, die unsere Audit-Engine bewertet, und ein kostenloses SEO-Audit deckt die Rendering- und Strukturprobleme ab, die darunter liegen.
So haben wir diesen Scan durchgeführt
Die Grundgesamtheit sind die 100.000 Domains im Top-100k-Ranking-Datensatz von Cloudflare Radar, Zielfenster 31. August bis 7. September 2026. Wir haben am 13. September 2026 pro Domain einen HTTPS-GET an https://{domain}/llms.txt gesendet und dabei bis zu drei Redirects verfolgt, mit einem Timeout von 25 Sekunden und einem User-Agent, der sich selbst ausweist.
Die Antwort zu klassifizieren war wichtiger, als sie abzurufen. 20.171 Domains antworteten unter diesem Pfad mit 200. Nur 8.598 davon hatten tatsächlich eine Datei veröffentlicht — eine 2,35-fache Überzählung, wenn man bei der Statuszeile aufhört. Als echt haben wir eine Datei nur gezählt, wenn sie 200 zurückgab und der Body kein HTML war, kein JSON oder JavaScript, keine Bot-Challenge-Zwischenseite, keine robots.txt und nicht kürzer als 20 Bytes.
Grenzen, die man klar benennen sollte:
- Wir haben nur den Root-Pfad angefragt. Eine Datei auf einer Dokumentations-Subdomain zählt als nicht vorhanden. Das ist nicht hypothetisch:
anthropic.com antwortet mit 404, während docs.anthropic.com mit 200 antwortet. Die tatsächliche Verbreitung unter großen Organisationen ist höher als unsere Quote auf Root-Domain-Ebene.
- Das ist eine Momentaufnahme, an einem einzigen Tag aufgenommen. Sie zeigt einen Stand, keinen Trend.
- 24.647 Domains haben nie geantwortet. Sie sind aus der Zahl von 11,4 % ausgeschlossen, statt als fehlend gezählt zu werden.
- Die Zuordnung zu Generatoren ist eine Untergrenze. Wir können nur Generatoren erkennen, die ihre Ausgabe signieren.
- Die Grundgesamtheit ist nach Traffic gerankt, sie enthält also CDN- und API-Hosts, die nie dafür gedacht waren, einem Leser Inhalte auszuliefern.
Die bestätigenden Zahlen stammen aus den Crawling- und Audit-Daten von SEOmator, Januar bis Juli 2026, über mehr als 100.000 auditierte Websites und mehr als 50 Mio. gecrawlte Seiten. Diese Aggregate spiegeln unseren Kundenmix wider, der zu rund 60 % aus B2B-SaaS besteht.
Häufig gestellte Fragen zu llms.txt
Wie viele Websites haben eine llms.txt-Datei?
8.598 der Top 100.000 Domains des Webs, also 8,6 %, Stand 13. September 2026. Gemessen an den 75.353 Domains, die auf unsere Anfrage geantwortet haben, liegt die Quote bei 11,4 %.
Bringt llms.txt etwas für SEO?
Es gibt keine Belege, dass sie Google-Rankings oder AI Overviews beeinflusst. Google hat erklärt, dass es die Datei nicht nutzt, und kein großer AI-Anbieter hat dokumentiert, dass er sie für die Entdeckung verarbeitet.
Lesen ChatGPT, Claude oder Gemini die llms.txt?
Keiner hat dokumentiert, dass er das tut. Sie veröffentlichen llms.txt auf ihren eigenen Dokumentationsseiten, und das ist etwas anderes, als Ihre zu verarbeiten.
Ist llms.txt dasselbe wie robots.txt?
Nein. robots.txt ist eine verbindliche Zugriffsdirektive, an die sich Crawler halten. llms.txt ist eine optionale Markdown-Karte Ihrer Inhalte, die zu lesen nichts verpflichtet ist. In unserem Scan lieferten 186 Domains ihre robots.txt unter dem llms.txt-Pfad aus.
Welche Plattformen erstellen llms.txt automatisch?
Shopify hat 18,2 % aller Dateien geschrieben, die wir gefunden haben. Yoast, All in One SEO und Rank Math kommen zusammen auf 9,6 %, Wix und HubSpot gemeinsam auf weitere rund 1,5 %.
Was sollte eine llms.txt-Datei enthalten?
Einen H1-Titel, optional eine Zusammenfassung als Blockquote, dann H2-Abschnitte mit Markdown-Links zu Ihren besten Inhalten. Auf die Links kommt es an — 16,4 % der veröffentlichten Dateien haben keine.
Kann llms.txt meiner Website schaden?
Nicht direkt. Das Risiko ist eine veraltete Linkliste, die Ihre Inhalte falsch darstellt, dazu die Opportunitätskosten, wenn Sie die Datei als Arbeit für die AI-Suche behandeln, obwohl sie das nicht ist.
Wie prüfe ich, ob meine Website eine hat?
Fragen Sie https://yourdomain.com/llms.txt an und lesen Sie den Body. Trauen Sie nicht dem Statuscode — mehr Top-Domains liefern unter diesem Pfad eine HTML-Seite aus als eine echte Datei.
Warum sagt Google, dass llms.txt nicht genutzt wird?
Muellers Argument ist, dass eine Suchmaschine die Datei nicht nutzen kann, um bei der Entdeckung zwischen Websites zu unterscheiden, weil sie erst hilft, wenn ein Agent bereits angekommen ist.
Was ist llms-full.txt, und brauche ich eine?
Es ist die Begleitdatei, die Ihre eigentlichen Inhalte enthalten soll statt Links darauf. 29,3 % der Domains, die eine llms.txt veröffentlichen, veröffentlichen auch eine, aber die Hälfte davon liefert eine nahezu identische Kopie ihrer llms.txt aus statt etwas Umfangreicheres. Legen Sie sie nur an, wenn Sie wirklich einen größeren Bestand an Inhalten auszuliefern haben.
Welche Arten von Websites nutzen llms.txt am häufigsten?
Technische. .ai-Domains kommen auf 39,3 % und .io auf 24,9 %, gegenüber 11,4 % über alle antwortenden Domains. .net liegt bei 5,5 %, und die großen europäischen und japanischen Länderdomains liegen zwischen 6 % und 9 %.
Wächst die Verbreitung?
Unsere 8,6 % liegen deutlich über der Zählung von 951 Domains aus dem Juli 2025, aber die beiden lassen sich nicht direkt vergleichen, und ein großer Teil des Wachstums sind Plattform-Standards statt bewusster Entscheidungen. Wir werden diese Erhebung wiederholen, um den Trend richtig zu messen.
Was ich als Nächstes tun würde
Der interessante Befund hier ist nicht die Verbreitungsquote. Sondern dass mindestens ein Drittel davon von jemand anderem eingeschaltet wurde — und dass mehr Websites unter diesem Pfad versehentlich eine HTML-Seite ausliefern, als bewusst eine Datei veröffentlichen.
Wenn llms.txt auf Ihrer Roadmap steht, nehmen Sie sich zehn Minuten, um zu prüfen, ob Ihre Plattform nicht schon eine ausgeliefert hat, und verwenden Sie den Rest der Zeit auf das, was AI-Crawler nachweislich lesen. Unser Site-Crawler zeigt Ihnen, was ein rendernder Crawler auf Ihren Seiten tatsächlich sieht — die Ebene, auf der dieses Format aufsetzt.
Wir werden diese Erhebung wiederholen und die Veränderung veröffentlichen.


 Aufgeschrieben von Charles Duncan