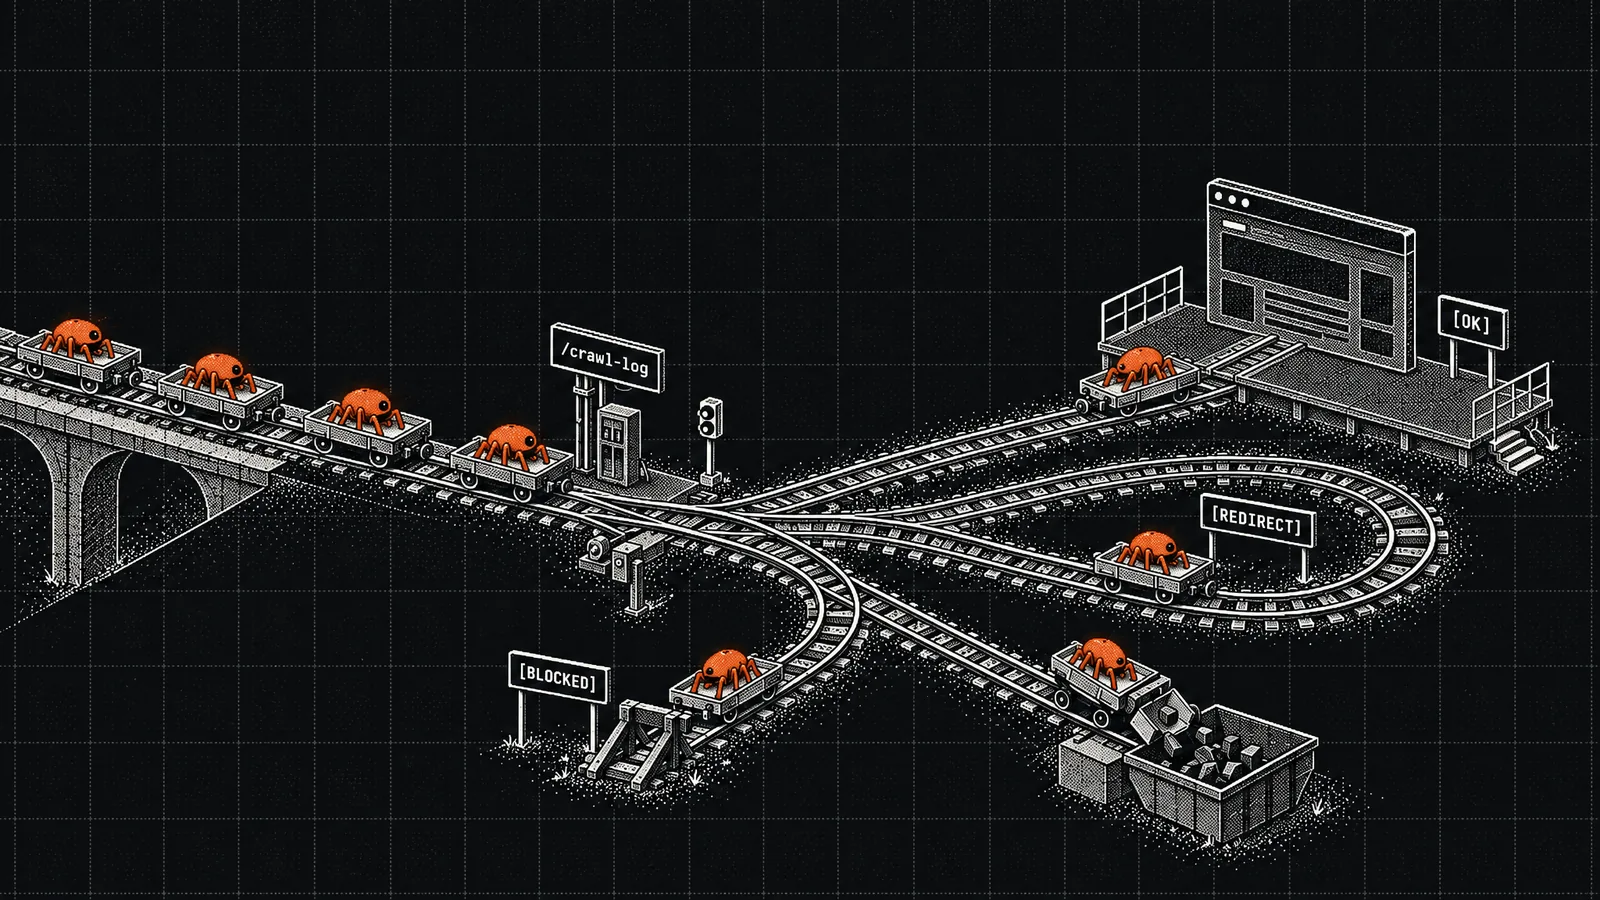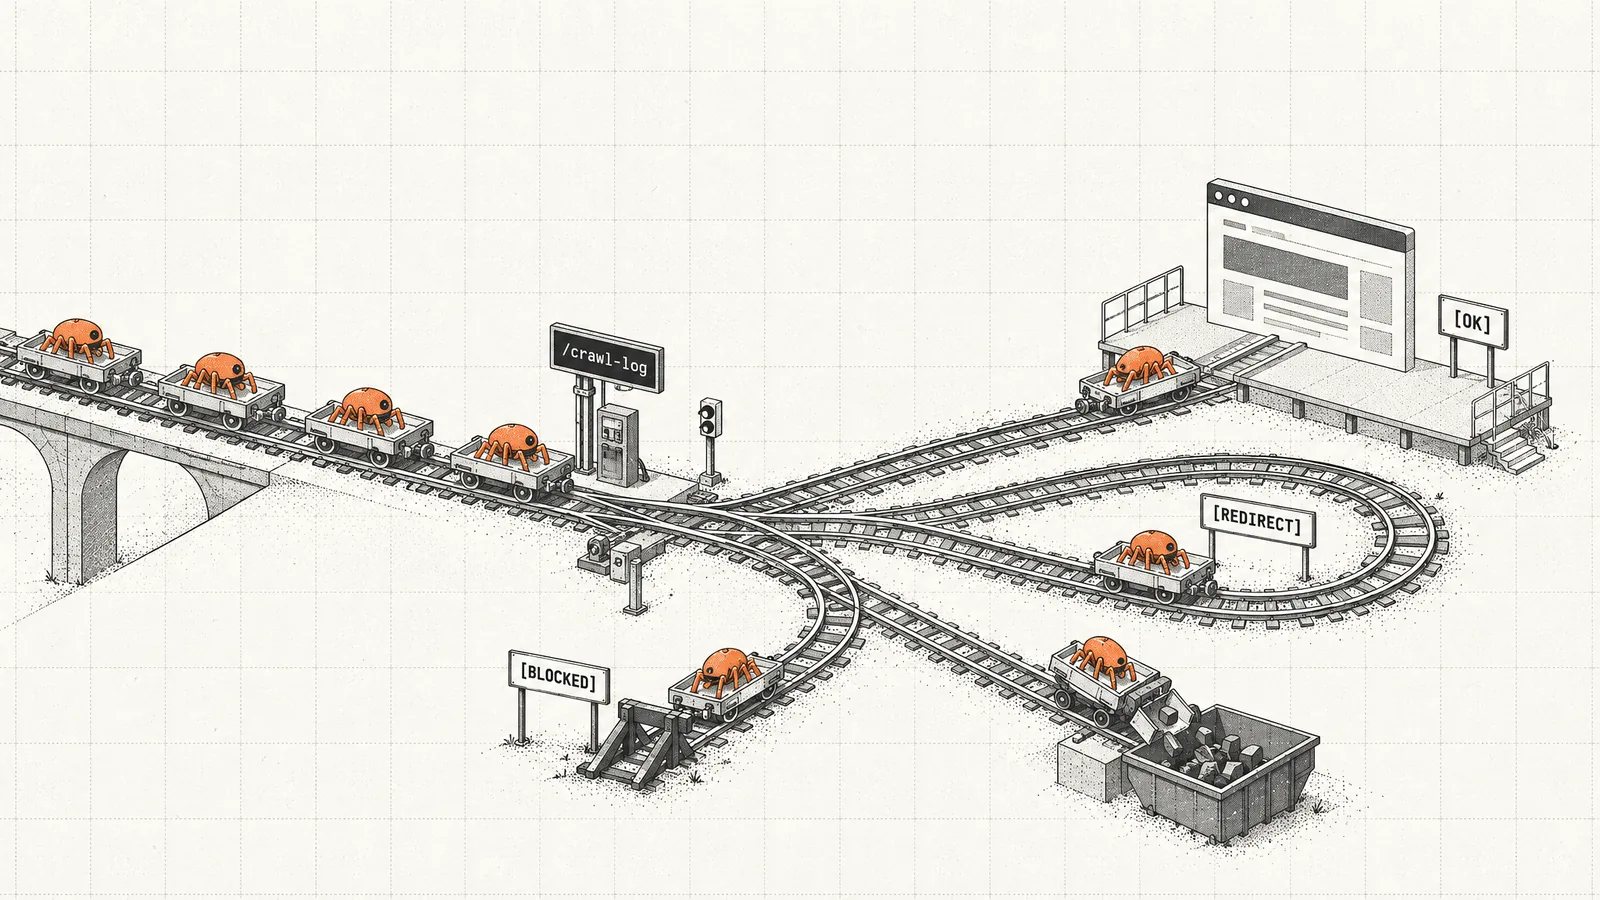
Nur 45,9 % der Anfragen im Web-Crawler-Datensatz von Cloudflare Radar werden mit einem verwertbaren 200 beantwortet. Der Rest sind Sperren, Fehler und Redirect-Hops. Teilt man diese Zahl aber danach auf, wer fragt, kehrt sie sich um: Verifizierte AI-Bots bekommen in 73,0 % der Fälle einen 200 zurück, Nicht-AI-Bots — SEO-Tools, Scraper, Monitoring-Dienste — nur in 33,3 %. Die Mauer, die das Web gebaut hat, zielt nicht dorthin, wo die meisten Audits es annehmen.
Die wichtigsten Erkenntnisse aus den Daten vom Juli 2026:
- Nur 45,9 % der Anfragen werden mit 200 beantwortet; effiziente 304-Revalidierungen steuern gerade einmal 1,2 % bei.
- Verifizierte AI-Bots erreichen eine Erfolgsquote von 73,0 % — der sauberste aller Client-Typen. Nicht-AI-Bots kommen auf 33,3 % und fangen sich eine Sperrquote von 29,2 % ein.
- 403 Forbidden ist mit 20,6 % noch immer der größte einzelne Nicht-200-Posten, ist gegenüber dem Vormonat aber um 1,20 Prozentpunkte gesunken.
- Die Crawl-to-Refer-Verhältnisse der AI-Betreiber schwanken von Monat zu Monat um ein Vielfaches (Anthropic halbierte sich, Mistral stieg auf das 20-Fache); Suchmaschinen bleiben stabil.
- Der Einzelhandel zieht 24,1 % des gesamten Crawler-Traffics auf sich — mehr als jede andere Branche.
- SEOmators Crawl von 10 großen Websites kam auf 99,2 % 200er — die Verschwendung hat den internen Link-Graphen nie berührt.
Was ist Crawl-Budget-Verschwendung?
Crawl-Budget-Verschwendung ist der Anteil der Crawl-Aktivität einer Suchmaschine, der auf URLs entfällt, die keinen verwertbaren, indexierbaren Inhalt liefern: gesperrte Seiten, tote Links, Weiterleitungsketten und nahezu doppelte Parameter-URLs. Jede dieser Anfragen verbraucht einen Teil Ihres Crawl-Budgets, ohne dass auch nur eine einzige Seite in den Index gelangt.
Das Crawl-Budget selbst ist die Zahl der URLs, die ein Bot in einem bestimmten Zeitraum von Ihrer Website abruft. Google teilt es in zwei Teile: die Crawl-Kapazität (wie stark Google Ihren Server belasten kann, ohne ihn auszubremsen) und den Crawl-Bedarf (wie sehr Google Ihre Seiten tatsächlich haben will). Die meisten reden über das Budget. Kaum jemand beziffert die Verschwendung, und das ist seltsam, denn die Verschwendung ist der Teil, den Sie kürzen können.
Die Verschwendung zeigt sich in gängigen HTTP-Statuscodes, die kein 200 sind: ein 403, mit dem der Bot abgewiesen wurde, ein 404, weil er falsch geraten hat, ein 301, der ihn auf einen weiteren Roundtrip schickt. Auf einer kleinen Website rundet sich das auf null ab. Auf allem jenseits von ein paar tausend URLs, und besonders auf Websites mit großer Crawl-Tiefe, entscheidet es darüber, wie schnell Ihre echten Seiten indexiert werden.
Wohin gehen Crawler-Anfragen 2026 tatsächlich?
Über das gesamte Web betrachtet kommt weniger als die Hälfte der Anfragen mit Inhalt zurück. Hier ist die vollständige Verteilung der Antwortstatus aus Cloudflare Radar für die 28 Tage bis zum 19. Juli 2026, mit der Veränderung gegenüber dem vorangegangenen 28-Tage-Fenster.
| Status | Anteil | Veränderung ggü. vorherigen 28 Tagen | Bewertung |
|---|
| 200 OK | 45,9 % | +0,38 | Verwertbarer Inhalt — das Ziel |
| 403 Forbidden | 20,6 % | −1,20 | Gesperrt. Größter Nicht-200-Posten |
| 301 Moved Permanently | 8,0 % | +0,30 | Redirect-Hop |
| 404 Not Found | 7,8 % | +0,75 | Verschwendet: geratene oder tote URL |
| 429 Too Many Requests | 6,3 % | −0,13 | Durch Rate-Limit gebremst |
| 302 Found | 4,6 % | +0,12 | Redirect-Hop |
| 204 No Content | 1,6 % | +0,06 | Leere Antwort |
| 503 Service Unavailable | 1,3 % | −0,20 | Serverfehler |
| 304 Not Modified | 1,2 % | −0,03 | Effiziente Revalidierung — gut |
| Sonstige | 2,8 % | −0,03 | Gemischt |
Nach Statusklassen zusammengefasst ergibt dasselbe Fenster: 2xx 47,8 %, 4xx 35,7 %, 3xx 14,3 %, 5xx 2,2 %. Von 100 Anfragen kommen also rund 47 mit etwas Lesbarem zurück, 36 prallen an einer Mauer ab, und 14 schicken den Client zuerst woandershin.
⚠️Häufiger Fehler: 304 Not Modified als Verschwendung zählen. Ein 304 bedeutet, dass der Crawler gefragt hat: „Seit dem letzten Mal geändert?“, und der Server Nein gesagt hat. Damit entfällt ein vollständiger erneuter Download, und genau das wollen Sie. Werten Sie ihn also neben dem 200 als Erfolg.
Die Schlagzeilenzahl bewegt sich kaum. Gegenüber den vorherigen 28 Tagen stieg die 200-Quote um rund ein Drittel Prozentpunkt. Was sich darunter verändert hat, ist die Form der Verschwendung: 404-Antworten legten um drei Viertel Prozentpunkte zu, während die 403-Sperren um 1,20 Prozentpunkte nachließen — die größte einzelne Bewegung in der Tabelle, und zwar in die entgegengesetzte Richtung dessen, was die meisten Kommentare 2026 vorhersagen.
Welche Clients werden tatsächlich gesperrt?
Diese Aufschlüsselung verändert, wie Sie jede andere Zahl auf dieser Seite lesen sollten. Radars Crawler-Datensatz lässt sich nach Client-Typ filtern, und die vier Segmente verhalten sich ganz anders als der Mischdurchschnitt.
| Client-Typ | 200 | 403 | 404 | 429 | Anteil an den Anfragen |
|---|
| Bots mit gemischtem Zweck | 73,4 % | 5,2 % | 5,2 % | 1,1 % | 3,3 % |
| Verifizierte AI-Bots | 73,0 % | 13,5 % | 4,1 % | 1,0 % | 5,7 % |
| Menschlicher Traffic | 54,5 % | 12,9 % | 7,4 % | 4,5 % | 42,5 % |
| Nicht-AI-Bots | 33,3 % | 29,2 % | 8,8 % | 8,8 % | 48,5 % |
| Alle Anfragen (Mischwert) | 45,9 % | 20,6 % | 7,8 % | 6,3 % | 100 % |
Verifizierte AI-Bots sind die am besten behandelten automatisierten Clients im Web. Sie bekommen in fast drei Vierteln der Fälle Inhalt zurück und werden in 13,5 % der Fälle abgewiesen — unter dem Mischwert von 20,6 % und weniger als die Hälfte der 29,2 %, die Nicht-AI-Bots abbekommen.
Nicht-AI-Bots sind das Segment, das die globale Zahl nach unten zieht. Mit 48,5 % der Anfragen sind sie die größte einzelne Population im Datensatz, und ein Drittel dessen, was sie anfragen, kommt als 403 oder 429 zurück. In diese Gruppe fallen SEO-Crawler, Scraper, Uptime-Monitore, Webhooks und Vorschau-Abrufer — und genau hier wird das Sperrbudget des Webs tatsächlich ausgegeben.
🚩Warnsignal: Wenn Ihre Bot-Management-Richtlinie geschrieben wurde, um „die AI-Crawler zu stoppen“, prüfen Sie, was sie tatsächlich erfasst. Die Daten zeigen, dass Ablehnungen am härtesten automatisierten Traffic ohne AI-Bezug treffen — dieselbe Klasse, zu der Ihr Rank Tracker, Ihr Uptime-Monitor und Ihr Site-Auditor gehören.
Ein ehrlicher Vorbehalt, und er ist wichtig: Radar klassifiziert verifizierte AI-Bots — Crawler, die sich zu erkennen geben und die Verifizierung von Cloudflare bestehen. Ein unverifizierter Scraper, der Inhalte abgreift und sich dabei mit einem Browser-User-Agent ausgibt, taucht in der 5,7-%-Zeile nicht auf. Er landet im Topf für Menschen oder für Nicht-AI-Bots. Die saubere Quote von 73,0 % beschreibt also Bots, die sich ausweisen und an die Regeln halten, nicht die gesamte Population AI-getriebener Datensammlung. Lesen Sie sie als „gut erzogene AI-Crawler werden hereingelassen“, nicht als „niemand scrapt Sie“.
Warum sieht der Crawl Ihrer eigenen Website so sauber aus?
Richten Sie einen Crawler auf die internen Links einer Website, und er findet die Verschwendung fast nie. In SEOmators Crawl vom Juli 2026 landete ein Crawler, der der Navigation und den Links im Fließtext der jeweiligen Website folgte, in 99,2 % der Fälle auf einer gültigen Seite. Radars 45,9 % und diese 99,2 % beschreiben dasselbe Web, betreten durch zwei verschiedene Türen.
Die Lücke ergibt sich daraus, wo die jeweilige Zahl gemessen wird. Ein Website-Crawl läuft den Link-Graphen ab, den eine Website bewusst offenlegt. Diese Links zeigen von vornherein auf echte, kanonische Seiten, also liefert eine gut geführte Website fast nur 200er. Der Strom an Anfragen, den Radar misst, enthält alles andere: URLs, die aus alten Sitemaps erraten werden, eingehende Links anderer Websites auf Seiten, die Sie gelöscht haben, Bots, die auf gesperrte Pfade einhämmern, und jahrelang angesammelte Weiterleitungen aus früheren Migrationen.
📊In Zahlen: In SEOmators Crawl vom Juli 2026 lieferten 99,2 % von 389 internen URLs einen 200. Der globale Wert von Cloudflare Radar für dasselbe Fenster lag bei 45,9 %. Dasselbe Web, zwei Blickwinkel.
Deshalb übersieht man diese Verschwendung so leicht. Sie steckt nicht im Link-Graphen, den ein Crawler von selbst entdeckt. Sie steckt in Ihren Server-Logs und in den Crawling-Statistiken der Search Console, wo jede echte Anfrage erfasst wird, einschließlich der Zehntausenden, auf die Ihre Navigation nie verweist. Zwei der zwölf Websites, die wir ausprobiert haben, kamen gar nicht erst bis zur Phase der internen Links: Etsy lieferte an der Root-URL einen 403 und IMDb einen 202 — an der Tür abgewiesen, genau das Muster, das Radar global misst.
Noch ein Vorbehalt. Zehn große, gut gepflegte Websites sind keine Vollerhebung des Webs. Ein sauberer interner Link-Graph auf einer gut geführten Website unterschätzt die tatsächliche Crawl-Verschwendung, die sich auf kleinen Websites, Legacy-Websites und E-Commerce-Websites mit Facettennavigation anhäuft. Lesen Sie die 99,2 % nur als Kontrast, nie als webweite Erfolgsquote.
Wer verbrennt 2026 Ihr Crawl-Budget?
Die Bots, die Ihre Website crawlen, haben sich verändert. Radars Daten nach Bot-Kategorie für dasselbe Fenster zeigen, dass AI-bezogene Crawler inzwischen mehr Anfragen erzeugen als Suchmaschinen.
| Bot-Kategorie | Anteil am Bot-Traffic |
|---|
| Suchmaschinen-Crawler | 26,2 % |
| AI-Crawler (Training) | 17,7 % |
| SEO-Tools | 11,8 % |
| AI-Assistenten | 11,3 % |
| Werbung und Marketing | 7,8 % |
| AI-Suche | 6,6 % |
| Seitenvorschau | 6,0 % |
| Webhooks | 5,2 % |
| Monitoring und Analytics | 3,3 % |
Zählt man die drei AI-Zeilen zusammen, kommt man auf 35,6 % des Bot-Traffics, deutlich vor den 26,2 %, die klassische Such-Crawler wie Googlebot erzeugen. Innerhalb des AI-Segments liegt ClaudeBot (18,7 %) inzwischen nur noch hinter Googlebot (24,6 %), vor Meta-ExternalAgent (11,2 %) und GPTBot (9,7 %).
Nach erklärtem Zweck sortiert dienen 46,7 % der AI-Crawler-Anfragen dem Modelltraining, 39,2 % haben einen gemischten Zweck, und nur 11,0 % versorgen einen Live-Suchindex. Dieses Verhältnis ist das eigentliche Argument in der Debatte ums Sperren von AI-Bots: Das meiste AI-Crawling ruft Ihre Seite nicht ab, um sie genau jetzt einem Nutzer zu zitieren. Die Ökonomie dieses Tauschs behandelt unser Report zum Crawl-to-Refer-Verhältnis.
Welche Branchen ziehen das meiste Crawling auf sich?
Crawler-Traffic verteilt sich nicht gleichmäßig über das Web. Radars Aufschlüsselungen nach Branche und Vertikale zeigen eine starke Konzentration im Handel.
| Branche | Anteil am Crawler-Traffic |
|---|
| Einzelhandel | 24,1 % |
| Computersoftware | 16,8 % |
| Glücksspiel & Casinos | 6,2 % |
| IT und Dienstleistungen | 6,1 % |
| Marketing und Werbung | 5,3 % |
| Medien | 5,0 % |
| Internet | 4,7 % |
| Erwachsenenunterhaltung | 4,6 % |
Radar veröffentlicht außerdem eine breitere Aufteilung nach Website-Vertikale, die dieselbe Geschichte mit anderen Bezeichnungen erzählt: Shopping und allgemeine Handelswaren 26,7 %, Internet und Telekommunikation 20,5 %, Computer und Elektronik 18,6 %, News und Medien 9,3 %, Glücksspiel 6,7 %.
Einzelhandel und Shopping beanspruchen rund ein Viertel der gesamten Crawler-Aufmerksamkeit — und der Einzelhandel ist zugleich die Kategorie, die am ehesten mit Facettennavigation arbeitet, dem größten einzelnen Erzeuger von Phantom-URLs. Die Branche, die das meiste Crawling auf sich zieht, ist architektonisch am besten dafür gerüstet, es zu verschwenden. Wenn Sie eine E-Commerce-Website betreiben, sollten Sie den Abschnitt zu Parametern weiter unten zweimal lesen.
Die größten Quellen von Crawl-Verschwendung (und wie Sie jede davon reduzieren)
Radars Nicht-200-Posten sind kein zufälliges Rauschen. Fünf davon machen fast die gesamte Verschwendung aus, und jeder hat im Frontend eine eigene Grundursache.
Weiterleitungsketten und alte 301/302-Weiterleitungen (12,6 % der Anfragen)
Jede Weiterleitung ist ein verschwendeter Roundtrip: Der Bot fragt eine URL an, bekommt gesagt, er solle woanders hin, und fragt erneut. Ketten vervielfachen diese Kosten. Eine Seite, die per 301 auf eine URL zeigt, die per 302 auf eine dritte Adresse weiterleitet, verbraucht drei Anfragen, um eine einzige Seite auszuliefern. Website-Migrationen, CMS-Wechsel und Umstellungen von HTTP auf HTTPS hinterlassen jeweils eine Schicht davon, und die Schichten stapeln sich.
Reduzieren Sie jede Kette auf einen einzigen Hop und richten Sie dann Ihre internen Links und Ihre Sitemap auf das endgültige Ziel aus. Lernen Sie zuerst, eine 3xx-Weiterleitungskette zu erkennen, und räumen Sie dann die zugrunde liegenden 301-Weiterleitungs- und Kanonisierungsregeln auf, damit sich keine neuen ansammeln.
📌Profi-Tipp: Wenn Sie eine Kette auflösen, richten Sie auch die internen Links und Sitemap-Einträge auf die endgültige URL aus. Zeigen sie weiter auf den ersten Hop, bekommt der Crawler beim nächsten Durchlauf einfach wieder denselben 301.
404-Fehler durch geratene und tote URLs (7,8 %)
Ein 404 bedeutet meist, dass eine Seite entfernt wurde, aber noch verlinkt ist, sei es aus einer alten Sitemap, von einer externen Website oder aus Ihrem eigenen Footer. Fehlerhafte Parameter und veraltete interne Links erzeugen den Rest. In den aktuellen Daten ist das der am schnellsten wachsende Verschwendungsposten: plus drei Viertel Prozentpunkte in einem Monat, während die Sperren zurückgingen.
Korrigieren Sie die internen Links, die auf tote Seiten zeigen, liefern Sie für bewusst entfernte Inhalte einen 410 Gone aus und halten Sie Ihre XML-Sitemap frei von URLs, die nicht mehr auflösen.
Facettennavigation und Parameter-Explosion
Hier erzeugt die Frontend-Architektur unbemerkt Verschwendung. Eine Filteroberfläche, die ?color=, ?size= und ?sort= an die URL anhängt, oder ein clientseitiger Router, der ?ref= und Sitzungsvarianten erzeugt, kann aus einer Handvoll echter Seiten Tausende nahezu identischer Phantom-URLs hervorbringen. Crawler fragen pflichtbewusst jede Kombination an, und fast keine davon verdient einen Platz im Index.
🛠️Vom Autor — Ben Kaiser, Principal Software Engineer bei Microsoft: Ich habe die Navigation von Single-Page-Apps für Produkte in großem Maßstab gebaut und würde hier das Standardverhalten clientseitiger Router als eigentliche Ursache benennen. Router serialisieren den UI-Zustand in den Query-String, weil dann der Zurück-Button und Deep Links funktionieren — dieser Teil ist richtig. Der Fehler liegt darin, jeden serialisierten Zustand als echtes <a href> ins Markup zu schreiben. Ein Crawler kann eine kanonische Kategorieseite nicht von ihrer 900. Sortiervariante unterscheiden; beides sind einfach Links. Rendern Sie Facetten-Steuerelemente als Buttons, die den Zustand aktualisieren, und reservieren Sie Anker für URLs, die Sie wirklich indexiert haben möchten.
Kanonisieren Sie Parameter-Varianten auf ihre saubere Basis-URL, sperren Sie die Parameter-Pfade per Disallow in der robots.txt und vermeiden Sie es, jeden Filter als crawlbaren Link auszugeben. Unser Guide zu robots.txt-Direktiven behandelt die Disallow-Muster, die das unterbinden, ohne die Seiten zu verstecken, die gecrawlt werden sollen.
403-Antworten, die die Bots sperren, die Sie wollen (20,6 %)
Der größte Nicht-200-Posten ist eine verschlossene Tür — doch wie die Tabelle nach Client-Typ gezeigt hat, schließt sie sich überwiegend vor automatisiertem Traffic ohne AI-Bezug, nicht vor AI-Crawlern. Ein Teil davon ist gewollt. Ein nennenswerter Teil ist versehentlich: eine CDN-Regel, eine Firewall-Einstellung oder ein Bot-Management-Schalter, der legitime Crawler mit ins Netz holt. Der Unterschied zwischen einem gewollten und einem versehentlichen 403 ist der Unterschied zwischen einer Richtlinie und einem Leck.
Prüfen Sie, welche User-Agents Sie abweisen, und stellen Sie sicher, dass das Ihrer Absicht entspricht. Lassen Sie die Such- und Zitations-Crawler zu, von denen Sie indexiert werden wollen, und reservieren Sie Sperren für Traffic, den Sie tatsächlich bewusst abweisen wollen. Wenn Sie diese Entscheidung bewusst treffen, müssen Sie den Traffic zuerst sehen: Ihre Server-Logs zeigen jeden Crawler, und AI Traffic Analytics zeigt die, die JavaScript ausführen, getrennt von Ihren menschlichen Besuchen.
429-Rate-Limits unter Crawl-Last (6,3 %)
Ein 429 sagt: „Zu viele Anfragen, bitte langsamer.“ Auch hier ist die Last ungleich verteilt: Nicht-AI-Bots bekommen in 8,8 % der Fälle ein Rate-Limit, verifizierte AI-Bots in 1,0 %. Wer Googlebot drosselt, verzögert seine eigene Indexierung; aggressive Scraper zu drosseln ist in Ordnung. Das Problem ist ein pauschales Limit, das beide nicht auseinanderhalten kann.
Erhöhen Sie die Kapazität oder justieren Sie Ihre Rate-Limits so, dass verifizierte Crawler durchkommen, während missbräuchlicher Traffic weiterhin gedrosselt wird.
🔑Kernaussage: Die größte einzelne Quelle von Crawl-Verschwendung sind 403-Sperren mit 20,6 % — doch sie konzentrieren sich auf Nicht-AI-Bots, die eine Ablehnungsquote von 29,2 % sehen. Prüfen Sie zuerst, wen Sie abweisen, und lösen Sie dann die Weiterleitungsketten auf.
Der 304, der nie kommt (1,2 %)
Nur 1,2 % der Anfragen enden mit einem 304 Not Modified, und diese Zahl ist unauffällig eine der schlechtesten in der Tabelle. Jeder Crawl unveränderter Inhalte, der statt eines 304 einen vollständigen 200 liefert, verbraucht Bandbreite und Crawl-Budget, um Bytes erneut herunterzuladen, die der Client bereits hat.
🛠️Vom Autor — Ben Kaiser, Principal Software Engineer bei Microsoft: Eine Revalidierungsquote von 1,2 % ist ein Engineering-Problem, kein SEO-Problem, und sie lässt sich meist auf die Build-Pipeline zurückführen. Viele Stacks entfernen den ETag entweder am CDN oder leiten ihn aus einem Build-Hash ab, sodass ein Deploy, der an einer bestimmten Seite nichts ändert, trotzdem eine neue Kennung erzeugt. Das If-None-Match des Crawlers passt dann nie, und er lädt Inhalte erneut herunter, die Byte für Byte mit dem identisch sind, was er bereits hatte. Erst wenn Validatoren aus dem Seiteninhalt statt aus der Build-Identität abgeleitet werden, werden aus diesen Anfragen günstige 304-Antworten — und das lohnt sich zu prüfen, bevor Sie Weiterleitungsketten jagen.
Was sagen Crawl-to-Refer-Verhältnisse über die Sperrstrategie aus?
Wenn Sie entscheiden, welche Bots Sie zulassen, ist das Crawl-to-Refer-Verhältnis die verlockende Kennzahl: wie viele Seiten ein Betreiber für jeden Besucher abruft, den er zurückschickt. Radar veröffentlicht es pro Betreiber. Die Falle: Es ist ausgerechnet bei den Betreibern extrem instabil, die man damit beurteilen will.
| Betreiber | Crawl:Refer (28 Tage bis 19. Juli) | Vorherige 28 Tage | Entwicklung |
|---|
| Anthropic | 2.302:1 | 4.825:1 | Halbiert |
| Mistral | 1.653:1 | 80:1 | ~20× höher |
| Perplexity | 225:1 | 192:1 | 17 % höher |
| OpenAI | 214:1 | 937:1 | 77 % niedriger |
| Microsoft | 34,6:1 | 35,0:1 | Stabil |
| Yandex | 26,1:1 | 25,5:1 | Stabil |
| Baidu | 11,6:1 | 10,7:1 | Stabil |
| ByteDance | 11,0:1 | 9,6:1 | Stabil |
| Google | 4,7:1 | 5,2:1 | Stabil |
| DuckDuckGo | 2,5:1 | 1,9:1 | Stabil |
Zwei Muster. Suchmaschinen sind stabil — Google, Microsoft, Yandex, Baidu und DuckDuckGo bewegten sich zwischen den beiden Fenstern jeweils um weniger als einen Punkt. AI-Betreiber nicht: Das Verhältnis von OpenAI fiel um mehr als drei Viertel, während das von Mistral im selben Monat auf das Zwanzigfache stieg.
Diese Instabilität ist der eigentliche Befund. Eine Sperrstrategie, die auf dem Verhältnis eines einzigen Monats für einen bestimmten AI-Betreiber beruht, ist auf Rauschen kalibriert. Wenn Sie diese Kennzahl nutzen wollen, verfolgen Sie sie über mehrere Fenster, bevor Sie danach handeln, und gewichten Sie die stabilen Suchmaschinen-Zeilen stärker als die volatilen AI-Zeilen.
Über welche Crawler schreibt das Web Regeln?
In der robots.txt erklären Websites ihre Absicht, und Radars Auswertung der robots.txt-Dateien seiner Domain-Population zeigt, dass AI-Crawler die Regeln dominieren — obwohl sie laut den Daten nach Client-Typ zugleich die Crawler sind, die am ehesten durchgelassen werden.
| In der robots.txt genannter User-Agent | Direktiven |
|---|
| GPTBot | 735 |
| ClaudeBot | 647 |
| Google-Extended | 617 |
| CCBot | 604 |
| Bytespider | 524 |
| meta-externalagent | 457 |
| Amazonbot | 448 |
| PerplexityBot | 442 |
Jeder Agent unter den ersten acht ist ein AI-Crawler. Klassische Such-Bots kommen kaum vor. Das Web schreibt weit mehr Regeln über AI-Crawler als über irgendetwas anderes, während die Antwortdaten zeigen, dass genau diese Crawler eine Erfolgsquote von 73,0 % erreichen. Erklärte Richtlinie und ausgelieferte Realität sind nicht dasselbe — ein guter Grund, zu prüfen, was Ihr Edge tatsächlich zurückgibt, statt sich darauf zu verlassen, was in Ihrer robots.txt steht.
Wie messen Sie Ihre eigene Crawl-Verschwendung?
Was Sie nicht sehen, können Sie nicht reduzieren, und ein Website-Crawl allein zeigt es Ihnen nicht. Um Ihre eigene Crawl-Verschwendung zu messen, brauchen Sie drei Quellen, die Sie zusammen lesen.
Crawling-Statistiken der Search Console. Öffnen Sie unter Einstellungen den Bericht „Crawling-Statistiken“ und lesen Sie die Anfragen nach Antwort und nach Dateityp. So sehen Sie am schnellsten die echte Aufteilung Ihres Hosts zwischen 200ern und Fehlern, direkt von Googlebot. Googles eigene Dokumentation zum Crawl-Budget erklärt, was jede Antwortklasse für große Websites bedeutet.
Server-Log-Analyse. Ihre Logs sind die maßgebliche Quelle. Sie erfassen jede Anfrage, einschließlich der geratenen URLs, gesperrten Bots und alten Weiterleitungen, die ein Crawl entlang der Links nie berührt. Nur hier existiert das vollständige Bild der Verschwendung — und nur hier können Sie nach Client segmentieren, wie es die Tabelle oben tut.
Ein Website-Crawl. Ein Crawl Ihres eigenen Link-Graphen liefert die saubere Basislinie: die Seiten, die Bots erreichen sollen, und ihren Status. Führen Sie ein kostenloses SEO-Audit durch, um Weiterleitungsketten und defekte interne Links aufzudecken, und nutzen Sie einen Live-Crawl-Test, um zu prüfen, was ein Bot heute unter Ihren URLs erhält.
✅Nächster Schritt: Öffnen Sie die Search Console, gehen Sie zu Einstellungen und lesen Sie den Bericht „Crawling-Statistiken“ nach Antwort. Liegen die 200er deutlich unter 90 % der Anfragen an Ihren Host, zeigen Ihre Logs, wo das Budget versickert — und segmentieren Sie nach User-Agent, bevor Sie AI-Crawlern die Schuld geben.
Häufig gestellte Fragen zur Crawl-Budget-Verschwendung
Was ist Crawl-Budget-Verschwendung?
Crawl-Budget-Verschwendung ist der Teil der Crawler-Anfragen an Ihre Website, der keinen indexierbaren Inhalt liefert: 403-Sperren, 404-Fehler, Redirect-Hops, durch Rate-Limits gebremste 429-Antworten und doppelte Parameter-URLs. Global beziffert Cloudflare Radar verwertbare 200-Antworten in seinem Web-Crawler-Datensatz auf 45,9 % aller Anfragen.
Werden AI-Crawler häufiger gesperrt als Such-Crawler?
Nein — in den aktuellen Daten ist es umgekehrt. Verifizierte AI-Bots erhalten in 73,0 % der Fälle eine 200-Antwort und nur in 13,5 % einen 403, während Nicht-AI-Bots (SEO-Tools, Scraper, Monitoring-Dienste) auf 33,3 % bzw. 29,2 % kommen. Beachten Sie, dass dies verifizierte AI-Crawler betrifft; unverifizierte Scraper, die sich mit Browser-User-Agents ausgeben, werden anderswo eingeordnet.
Was ist ein Crawl-Budget?
Ein Crawl-Budget ist die Zahl der URLs, die eine Suchmaschine in einem bestimmten Zeitraum von Ihrer Website abruft. Google beschreibt es als Crawl-Kapazität (wie viel Ihr Server verkraftet) mal Crawl-Bedarf (wie sehr Google Ihre Seiten haben will). Websites mit weniger als etwa 1.000 Seiten stoßen selten an die Grenze.
Wie reduzieren Sie Crawl-Budget-Verschwendung?
Arbeiten Sie die Nicht-200-Posten nach Größe ab: Prüfen Sie zuerst versehentliche 403-Sperren, reduzieren Sie Weiterleitungsketten auf einen Hop, liefern Sie für tote URLs saubere 404- oder 410-Antworten aus und verhindern Sie, dass Parameter der Facettennavigation Phantom-URLs erzeugen. Richten Sie dann jeden internen Link und jeden Sitemap-Eintrag auf die endgültige kanonische URL aus.
Es gibt keine einzelne offizielle Formel. Googles Modell lautet grob: Crawl-Budget gleich Crawl-Kapazitätslimit mal Crawl-Bedarf. Die Zahl, die in der Praxis zählt, ist Ihre Verschwendungsquote: der Anteil der Crawler-Anfragen, die etwas anderes als 200 oder 304 zurückgeben, und den lesen Sie aus Server-Logs oder der Search Console ab.
Wie prüfen Sie Ihr Crawl-Budget?
Nutzen Sie drei Quellen zusammen. Der Bericht „Crawling-Statistiken“ der Search Console schlüsselt Anfragen nach Antwort und Dateityp auf. Rohe Server-Logs sind der einzige Ort, an dem gesperrte und geratene URLs auftauchen. Ein Website-Crawl bildet Ihren internen Link-Graphen ab. Vergleichen Sie die 200-Quote über alle drei, um das Leck zu finden.
Was ist Crawl-Tiefe?
Die Crawl-Tiefe ist die Zahl der Klicks von Ihrer Startseite bis zu einer bestimmten Seite. Tief vergrabene Seiten werden seltener gecrawlt und können aus dem Index fallen. Eine flache, gut verlinkte Architektur hält wichtige URLs innerhalb weniger Hops und setzt Crawl-Budget dort ein, wo es Rankings bringt.
Was ist Crawl-Bedarf?
Der Crawl-Bedarf beschreibt, wie dringend eine Suchmaschine Ihre URLs crawlen will, vor allem bestimmt durch ihre Popularität und dadurch, wie veraltet ihre gespeicherte Kopie ist. Seiten mit hohem Bedarf werden oft neu gecrawlt; Seiten mit geringem Bedarf warten. Verschwendung untergräbt den effektiven Bedarf, weil sie Crawlern beibringt, dass Ihre URLs häufig nichts zurückliefern.
Wie wirkt sich Crawl-Verschwendung auf die Indexierung aus?
Jede Anfrage, die auf eine gesperrte oder tote URL entfällt, ist Aufmerksamkeit, die nicht auf Seiten entfällt, die Sie indexiert haben wollen. Auf großen Websites ist der Effekt messbar: Laut mydigipal werden 42 % der Produktseiten von B2B-SaaS-Anbietern zu wenig gecrawlt oder nie indexiert, oft weil Verschwendung das Crawling aufzehrt, bevor die Bots sie erreichen.
Spielt Crawl-Verschwendung für kleine Websites eine Rolle?
Bei Websites mit weniger als etwa 1.000 Seiten ist das Crawl-Budget selten der Engpass. Google crawlt sie in der Regel vollständig. Verschwendung zählt trotzdem, wenn sie in Form von 403-Antworten oder Weiterleitungsketten auftritt, die die Indexierung blockieren oder verlangsamen, doch die Obergrenze an Seiten pro Tag greift vor allem bei Websites mit mehr als 10.000 URLs.
Methodik und Quellen
Cloudflare Radar (externes Rückgrat). Die Zahlen zu Antwortstatus, Client-Typ, Bot-Kategorie, Branche, Vertikale, Crawl-to-Refer und robots.txt stammen von Cloudflare Radar für das 28-Tage-Fenster vom 21. Juni bis 19. Juli 2026; die Vergleiche mit dem Vormonat stammen aus dem unmittelbar vorangehenden 28-Tage-Fenster (24. Mai bis 21. Juni 2026), abgerufen über den Control-Range-Parameter der API. Endpunkte: radar/bots/crawlers/summary/{response_status, response_status_category, client_type, vertical, industry, crawl_refer_ratio}, radar/bots/summary/bot_category, radar/ai/bots/summary/{user_agent, crawl_purpose} und radar/robots_txt/top/user_agents/directive (radar.cloudflare.com). Die Segmentierung nach Client-Typ nutzt den Filter clientType (ai_bot, non_ai_bot, human, mixed_purpose). Anteile sind Prozent der Anfragen, außer beim Crawl-to-Refer-Verhältnis, das ein nach oben offenes Verhältnis ist, und bei den robots.txt-Zeilen, die rohe Direktiven-Zahlen aus einem Snapshot eines einzelnen Tages sind. Vor jeder künftigen Neuveröffentlichung erneut prüfen — diese Werte verschieben sich täglich, und der Juli-Durchlauf hat die 403-Quote gegenüber der Juni-Messung um 1,20 Prozentpunkte verschoben.
Ein Hinweis zur Population des Datensatzes. Radars Web-Crawler-Datensatz ist nach Client-Typ segmentiert, und menschlicher Traffic macht 42,5 % davon aus. Die Schlagzeilenzahl von 45,9 % ist daher ein Mischwert über alle Client-Typen, keine reine Bot-Zahl. Die Tabelle nach Client-Typ ist die präzisere Lesart dafür, wer was ausgeliefert bekommt.
SEOmator-Crawl (First-Party). Am 15. Juli 2026 versuchte der Website-Crawler von SEOmator, 12 große, gut gepflegte öffentliche Websites aus den Bereichen News, Einzelhandel, SaaS, Behörden, Bildung und Unterhaltung zu crawlen, jeweils bis zu 60 Seiten über die Entdeckung interner Links. Zehn wurden erfolgreich gecrawlt, mit 389 internen URLs, von denen 386 (99,2 %) einen 200 lieferten. Zwei der Websites, Etsy und IMDb, sperrten den Crawler schon an der Root-URL mit einem 403 bzw. einem 202, bevor sie einen einzigen internen Link preisgaben.
Einschränkungen. Die 99,2 % sind keine webweite Erfolgsquote. Ein sauberer interner Link-Graph auf einer gut geführten Website unterschätzt die tatsächliche Crawl-Verschwendung, die sich auf kleine Websites, Legacy-Websites und E-Commerce-Websites mit Facettennavigation konzentriert sowie auf den Strom an Anfragen jenseits der Links, den nur Server-Logs und die Search Console erfassen. Radars AI-Bot-Klassifizierung umfasst nur verifizierte Crawler; unverifizierte Scraper werden anderswo gezählt, und wie sie behandelt werden, ist in diesen Zahlen nicht sichtbar. Statuscodes geben wieder, was in den angegebenen Fenstern gemessen wurde, und variieren je nach Region, Bot-Management-Regeln und Personalisierung.