

· 17 Min. Lesezeit
Google Search Console MCP: Kostenloses GSC MCP für Claude & Codex
Google Search Console in zwei Minuten mit Claude oder Codex verbinden: SEOmators kostenloses GSC MCP. Ein Befehl, Browser-Anmeldung, kein Google-Cloud-Projekt.
Unsere kostenlose SEO-Audit-CLI unter MIT-Lizenz prüft Websites mit 365 Regeln in 20 Kategorien. Ihr Claude Code Skill lässt einen KI-Agenten prüfen und fixen.

Emre Elbeyoglu · Gründer & CEO, SEOmator
Über 16 Jahre in B2B-SaaS-SEO und Growth; über 10 Mio. $ Umsatz aus organischer Suche
Woher wir das wissen
Vollständige Methode ↓ Aufgeschrieben von Emre Elbeyoglu
SEOmators Open-Source SEO Audit Tool ist ein kostenloses Kommandozeilenprogramm unter MIT-Lizenz, das eine Website mit 365 Regeln in 20 Kategorien prüft, von Canonicals und Core Web Vitals bis zum Zugang für KI-Crawler. Du installierst es über npm als seomator. Mit seinem Claude Code Skill führt ein KI-Coding-Agent dasselbe Audit aus, liest die Ergebnisse und repariert deinen Code.
Ich habe dieses Tool gebaut. Von den 254 Commits im Repository seit dem ersten Release am 23. Januar 2026 stammen 253 von mir. Lies diesen Text also als Bericht des Machers, mit der Voreingenommenheit, die dazugehört. Am 15. Oktober 2026 hatte das GitHub-Repository 531 Sterne und 69 Forks, und das npm-Paket war 28.949 Mal heruntergeladen worden.
Bevor ich diesen Artikel geschrieben habe, habe ich die CLI auf unsere eigene Website angesetzt. Jede Zahl unten stammt aus diesem Lauf, auch die Befunde, bei denen sie danebenlag.
Nicht jeder, der SEO macht, will ein Terminal öffnen, und du brauchst auch keins. Wenn du lieber eine URL in eine Webseite einfügst, nimm unser kostenloses Audit-Tool. Wenn du die ganze Website überwachen lassen willst, ist das die SEOmator-Plattform, auf der ein AI-SEO-Agent nach Zeitplan prüft und behebt, was du freigibst. Die CLI ist für Entwickler, technische SEOs und KI-Agenten gemacht.
Die SEOmator SEO-Audit-CLI ist ein Node.js-Programm, das eine Seite abruft, sie in einem Headless-Browser rendert und nach einem festen Satz von Regeln bewertet. Jede Regel endet mit einem von vier Ergebnissen: bestanden, Warnung, Fehler oder „nicht gemessen“. Zu jedem Fehler gibt es einen konkreten Fix. Dieselbe Codebasis bietet dir vier Zugänge.
| Zugang | Befehl | Ideal für |
|---|---|---|
| CLI | seomator audit | Terminal, Skripte, CI |
| Claude Code Skill | npx skills add | Agenten, die prüfen und beheben |
| Lokales Dashboard | seomator serve | Alte Audits durchsehen |
| Desktop-App | npm run electron:dev | Fortschritt live verfolgen |
Den Skill installierst du mit npx skills add seo-skills/seo-audit-skill, die Electron-Desktop-App baust du aus dem Quellcode. Alle vier lesen und schreiben eine gemeinsame Verlaufsdatei, ~/.seomator/audits.db. Deshalb kann seomator compare das heutige Audit mit dem von letzter Woche vergleichen.
Das Paket heißt @seomator/seo-audit auf npm und steht unter der MIT-Lizenz. Du darfst es kommerziell nutzen und forken, und du kannst jede Regel lesen, bevor du ihrem Urteil traust.
@seomator/seo-audit 18 veröffentlichte Versionen, 28.949 npm-Downloads seit dem Start am 23. Januar 2026 und 6.786 in den 30 Tagen bis zum 12. Oktober.Am 21. Mai 2026 hat Tom Dörr das Repository auf X geteilt. Sein Post zitiert die README von damals mit 251 Regeln; Version 5.1.0 bringt 365 mit.
Audits websites with 251 rules across 20 categories
github.com/seo-skills/seo-audit-skill
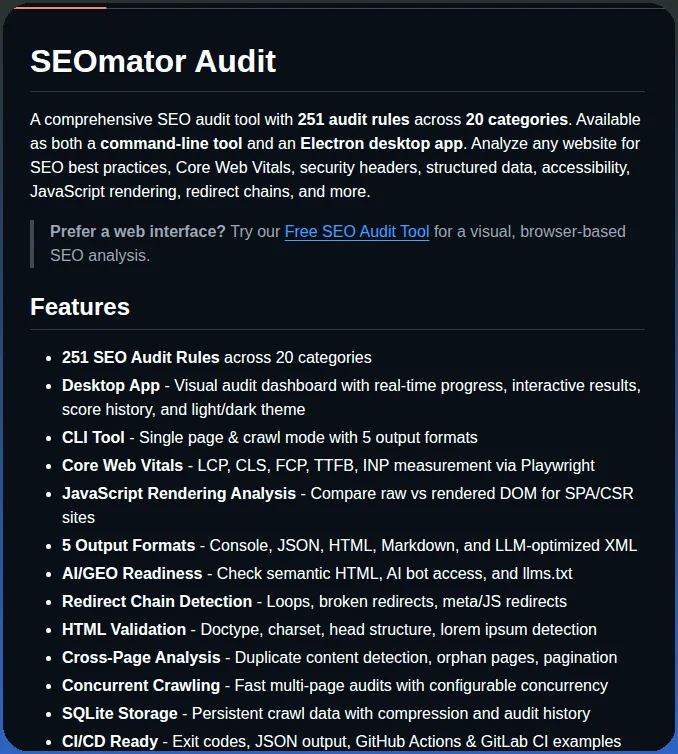 · Auf X ansehen
Wir haben die Audit-Engine von SEOmator als Open Source veröffentlicht, weil ein Audit, das du nicht lesen kannst, eine Blackbox ist, und eine Blackbox gibst du keinem Agenten in die Hand. Wenn eine Regel fehlschlägt, solltest du ihren Quellcode öffnen und nachsehen können, was sie gemessen hat und welchen Schwellenwert sie benutzt. Ein geschlossenes Tool verlangt, dass du dem Urteil einfach glaubst.
Der zweite Grund ist, woher Änderungen an Websites heute kommen. In der Codebasis hinter dieser Website tragen 310 der 441 Commits seit April 2026 eine Claude-Co-Author-Zeile. Lebt das Audit in einem separaten Dashboard, überträgt jemand die Befunde von Hand. Ist es ein Befehl, den der Agent aufrufen kann, führt der Agent das Audit aus, ändert das Template und prüft mit einem zweiten Audit seinen eigenen Fix.
Wir betreiben SEOmator weiterhin als Unternehmen, und unsere bezahlten Tarife finanzieren das. Die CLI ist die Audit-Engine für sich allein: kein Konto, kein Nutzungslimit, keine Werbung im Output.
Eine Regel-Engine liefert für dieselbe Seite jedes Mal dasselbe Urteil. Ein reiner Prompt-Skill lässt das Modell die Seite beurteilen, und das Urteil eines Modells kann von Lauf zu Lauf schwanken. Ein Claude Code Skill ist ein Ordner mit Anweisungen und optionalen Skripten, den der Agent lädt, wenn eine Aufgabe dazu passt; die Dokumentation zu Claude Code Skills von Anthropic erklärt das Format. Viele SEO-Skills verlassen sich auf das Urteil des Modells. Unserer ist eine dünne Hülle um ein deterministisches Programm.
Ein Modell, das „den Canonical prüfen“ soll, liegt meistens richtig. Trotzdem kann es denselben Befund in zwei Läufen unterschiedlich formulieren, eine Prüfung auslassen, wenn sein Kontext voll wird, oder einen Grenzfall heute so und morgen anders bewerten. Mit einer Regel-Engine übernimmt das Modell den Teil, den es gut kann: entscheiden, was zuerst behoben wird, und den Fix schreiben.
| Reiner Prompt-Skill | SEOmator Skill + CLI | |
|---|---|---|
| Wer das Urteil fällt | Das Modell, jedes Mal | 365 feste Regeln |
| Gleiche Seite, gleiches Ergebnis | Nicht garantiert | Ja, je Release |
| Verfolgbarer Score | Selten | 0 bis 100, pro Kategorie |
| Nicht gelaufene Prüfungen | Fallen oft still weg | Als „nicht gemessen“ gemeldet |
| Zwei Läufe vergleichen | Von Hand | seomator compare |
| Erlaubte Befehle | Hängt vom Skill ab | Nur Bash(seomator:*) |
Schau dir die letzte Zeile an, bevor du irgendeinen Skill installierst. Unsere SKILL.md deklariert allowed-tools: Bash(seomator:*), der Skill kann also nur den Befehl seomator ausführen. Öffne bei jedem Skill, den du installierst, die Zeile allowed-tools. Das dauert zehn Sekunden.
Das veröffentlichte Release der SEOmator-CLI, 5.1.0, führt 365 Regeln in 20 Kategorien aus. Ich habe die Regel-IDs im ausgelieferten Bundle gezählt, und die Summe stimmt mit der --help-Ausgabe der CLI überein. Der main-Branch hat schon 373. Deshalb nennt die README auf GitHub 373, während npm install dir bis zum nächsten Release 365 liefert.
Jede Kategorie hat ein festes Gewicht im Gesamtscore. Die Gewichte stammen aus dem Regelkatalog des Projekts und ergeben zusammen 100.
| Kategorie | Regeln (5.1.0) | Gewicht | Beispielregel |
|---|---|---|---|
| Crawlbarkeit | 37 | 5 % | Canonical-Ziel nicht auf noindex |
| Barrierefreiheit | 35 | 7 % | SVG-Grafiken haben einen Namen |
| Performance | 28 | 10 % | LCP unter 2,5 s |
| Links | 27 | 8 % | Keine kaputten internen Links |
| Sicherheit | 26 | 8 % | HSTS-Header gesetzt |
| Content | 25 | 5 % | Title weicht von der H1 ab |
| Core SEO | 24 | 11 % | Ein Canonical, absolut |
| Technisches SEO | 18 | 7 % | robots.txt liefert 200 |
| Strukturierte Daten | 18 | 5 % | JSON-LD lässt sich parsen |
| JavaScript-Rendering | 16 | 5 % | H1 auch ohne JS vorhanden |
| E-E-A-T | 15 | 3 % | Autorenzeile vorhanden |
| Bilder | 14 | 8 % | Alt-Text an jedem Bild |
| URL-Struktur | 14 | 3 % | URLs in Kleinbuchstaben |
| Internationalisierung | 13 | 2 % | Hreflang-Rückverweise |
| Mobil | 12 | 2 % | Viewport erlaubt Zoom |
| Weiterleitungen | 11 | 3 % | Keine Weiterleitungsschleifen |
| HTML-Validierung | 11 | 2 % | Genau ein Title-Tag |
| AI/GEO-Bereitschaft | 11 | 2 % | KI-Crawler erlaubt |
| Social | 9 | 3 % | og:url entspricht dem Canonical |
| Rechtliches | 1 | 1 % | Cookie-Hinweis vorhanden |
Zwei dieser Kategorien findest du in kostenlosen Tools selten. JavaScript-Rendering vergleicht das rohe HTML mit der gerenderten Seite und erwischt so einen Title, Canonical oder noindex, der erst nach dem Ausführen von JavaScript auftaucht. Googles Grundlagen zu JavaScript-SEO erklären, warum diese Lücke zählt. AI/GEO-Bereitschaft prüft, ob KI-Crawler dich erreichen, ob du eine llms.txt veröffentlichst und ob dein JSON-LD zur sichtbaren Seite passt.
--crawl. Wenn ein seitenweites Problem nicht auftaucht, prüf, ob du gecrawlt hast.Du installierst die SEOmator-CLI einmal über npm, prüfst dein Setup und richtest sie auf eine URL. Ein erstes Audit einer einzelnen Seite dauerte auf unserer Startseite 30 bis 40 Sekunden.
npm install -g @seomator/seo-audit
seomator self doctor          # prüft Node, npm, Chrome und den Datenordner
seomator audit https://example.com
Diese Flags nutze ich am häufigsten:
seomator audit https://example.com --no-cwv                 # Browser-Rendering überspringen (siehe unten)
seomator audit https://example.com -c core,security,perf    # nur einige Kategorien
seomator audit https://example.com --crawl -m 20            # 20 Seiten crawlen, für seitenübergreifende Regeln
seomator audit https://example.com --mobile                 # zusätzlich im Smartphone-Viewport rendern
seomator audit https://example.com --format html -o report.html   # console, json, html, markdown oder llm
Für eine Website, die du oft prüfst, legst du mit seomator init eine seomator.toml an. Darin stehen die Crawl-Limits, die Pfade, die übersprungen werden, und die Regeln, die du abschaltest, sodass jeder Lauf mit denselben Einstellungen arbeitet. Es gibt Presets für Blogs, E-Commerce und CI.
[project]
name = "my-website"
domains = ["example.com", "www.example.com"]

[crawler]
max_pages = 100
concurrency = 3
exclude = ["/admin/**", "/api/**"]
drop_query_prefixes = ["utm_", "gclid", "fbclid"]

[rules]
enable = ["*"]
disable = ["legal-*"]   # Wildcards funktionieren
CLI-Flags haben Vorrang vor der lokalen seomator.toml. Danach kommen Konfigurationen in übergeordneten Ordnern, dann ~/.seomator/config.toml, dann die eingebauten Standardwerte.
SEOMATOR_HOME auf einen Projektordner, wenn du Kunden-Websites prüfst. Dann bleiben Verlauf und Vergleiche jedes Kunden von deinen getrennt.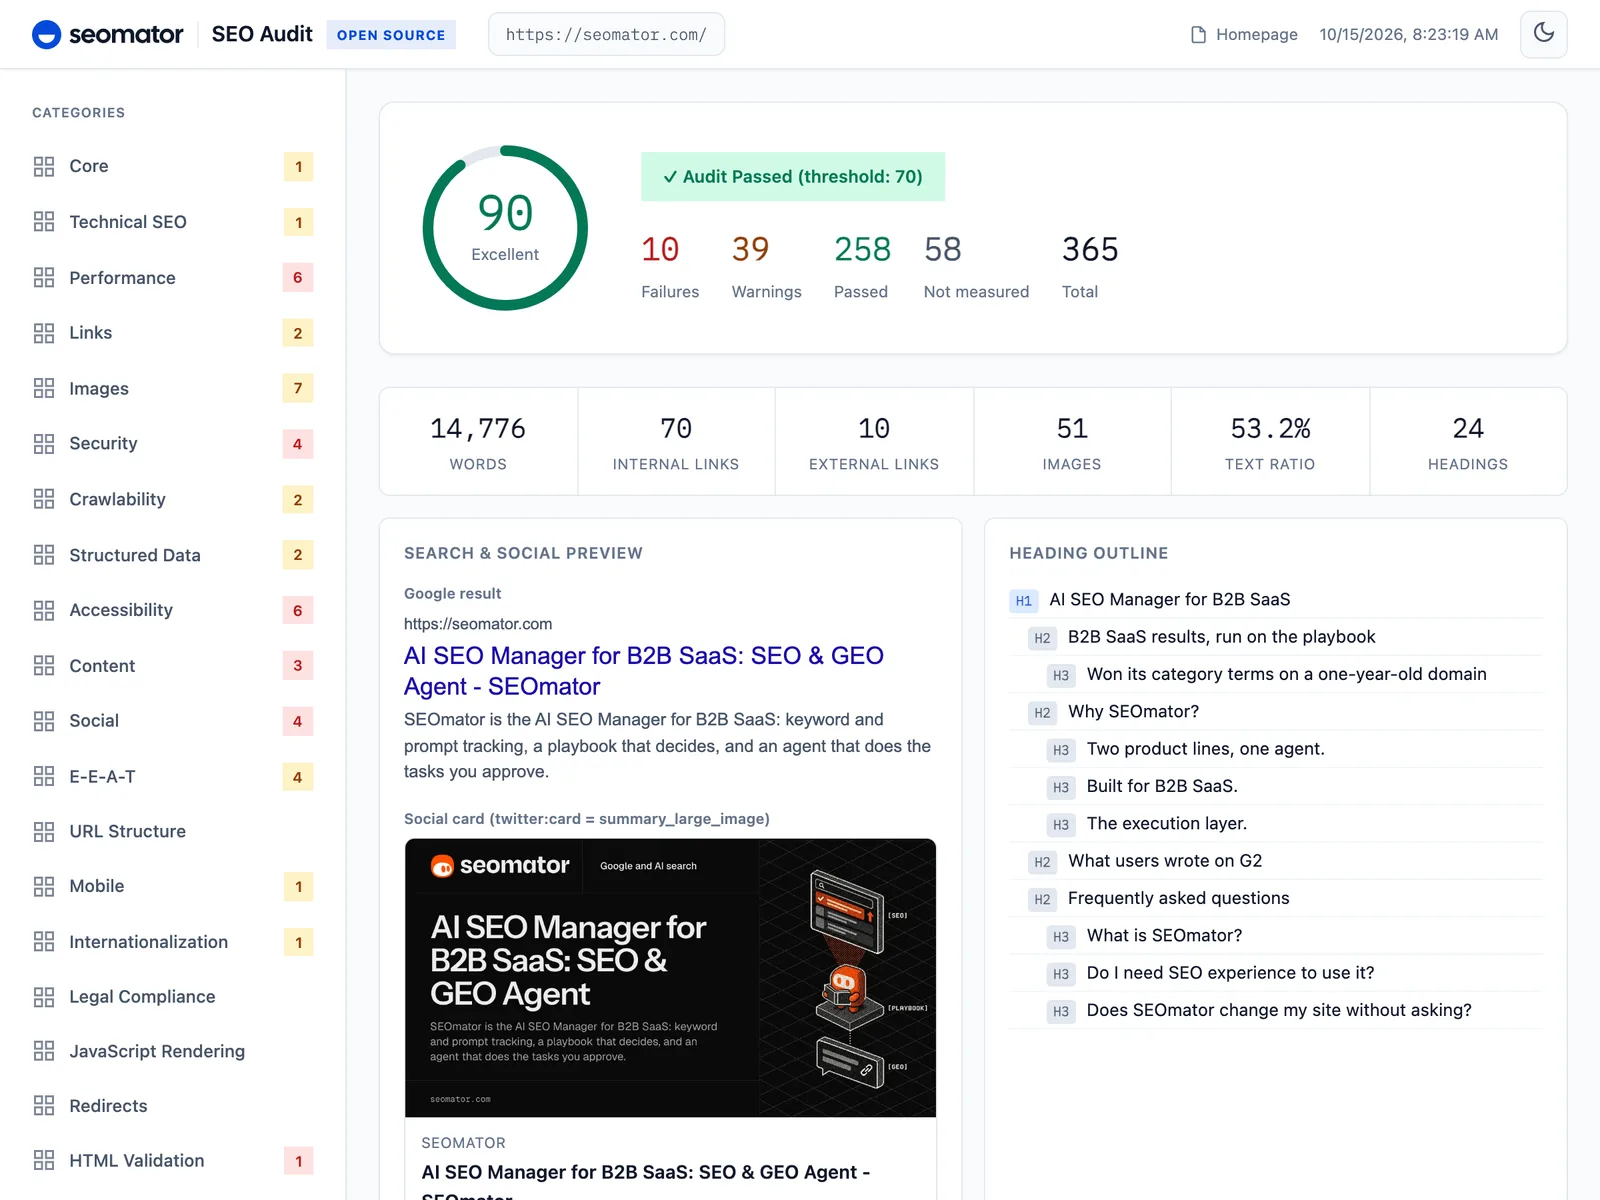
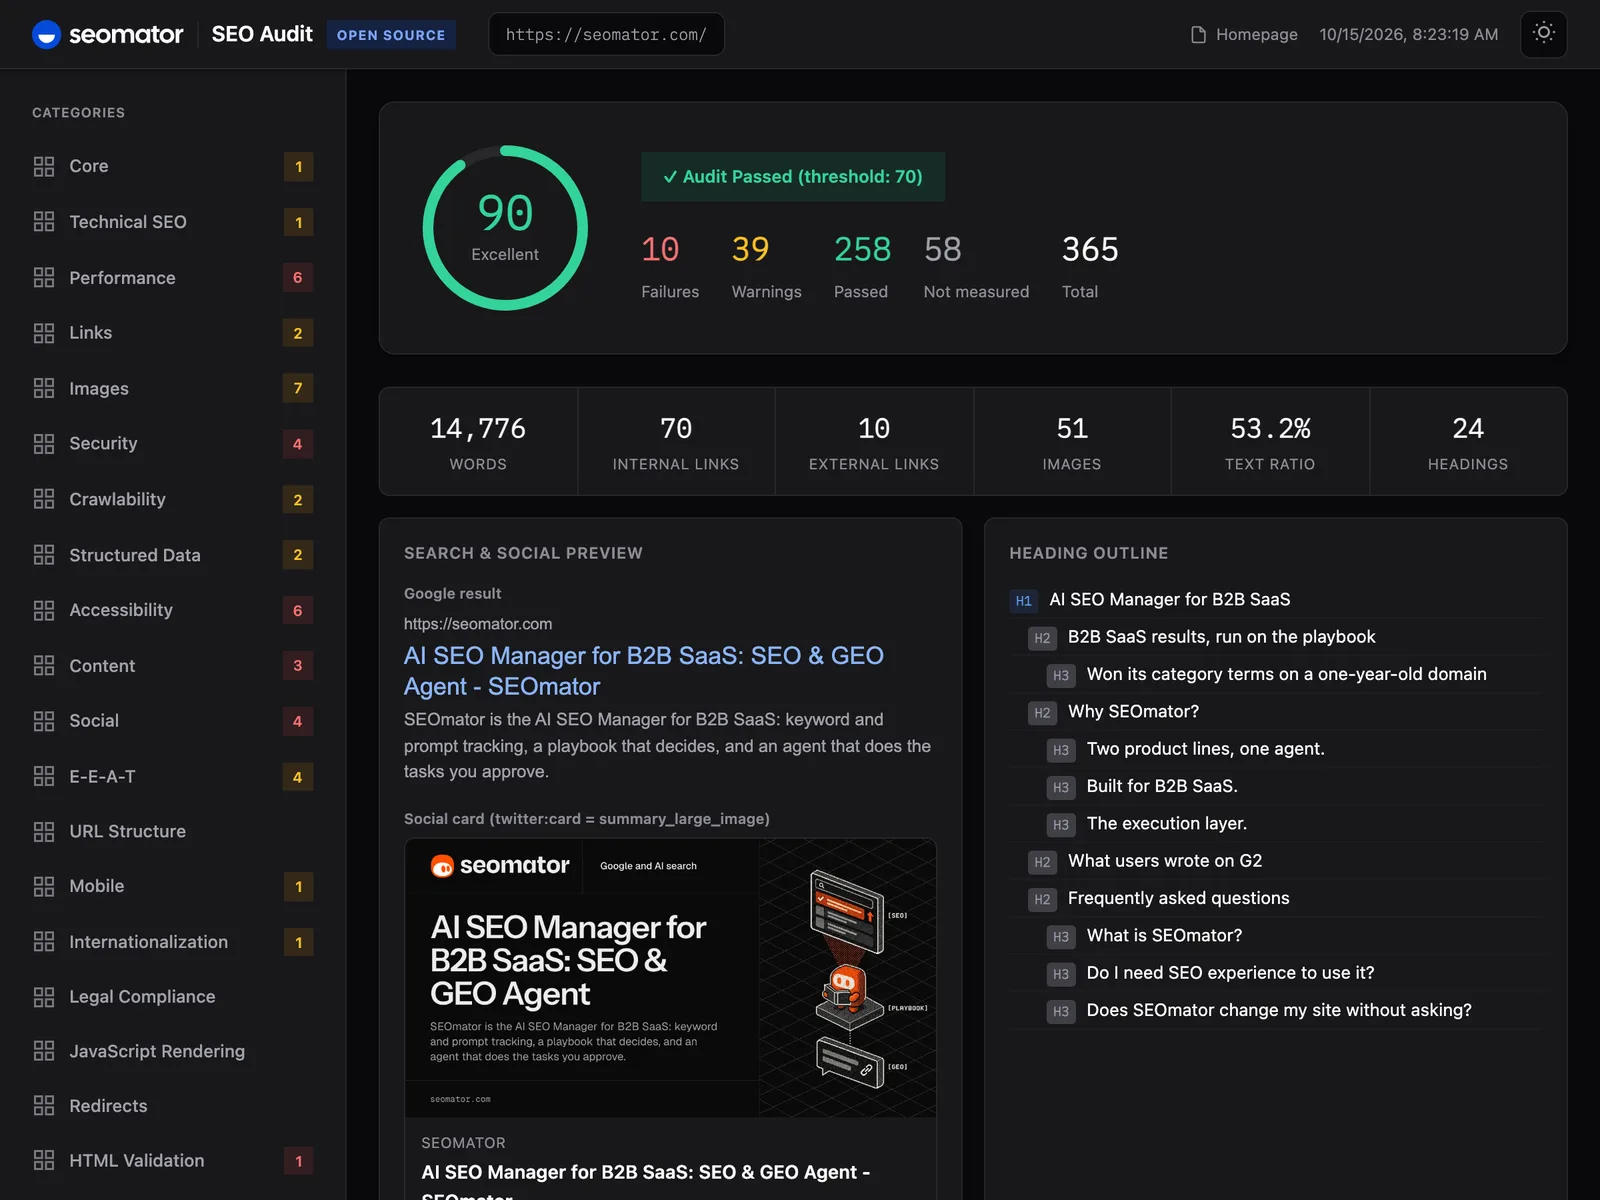
Der HTML-Bericht der CLI für seomator.com, erstellt mit @seomator/seo-audit 5.1.0 ohne Core Web Vitals, aufgenommen am 15. Oktober 2026. Die Oberfläche des Berichts ist englisch.
Die SEOmator-CLI gab unserer eigenen Startseite am 15. Oktober 2026 mit eingeschalteten Core Web Vitals 91 von 100 Punkten: 277 Regeln bestanden, 41 warnten, 10 schlugen fehl und 37 wurden nicht gemessen. Von den nicht gemessenen brauchen 29 einen Crawl, 5 brauchen --mobile, INP braucht einen echten Nutzer, und 2 Minifizierungsprüfungen konnten die externen Dateien nicht lesen. Die Labor-Vitals waren in Ordnung: LCP 0,39 s, CLS 0,000, TTFB 225 ms.
Der Score allein sagt wenig. Die 10 Fehler sagen dir, was zu tun ist, also habe ich jeden einzelnen von Hand geprüft.
| Regel | Befund | Unser Urteil |
|---|---|---|
perf-page-weight | 597 KB HTML | Echt: RSC-Payload |
htmlval-size-limit | Über 500 KB | Echt: gleiche Ursache |
perf-js-file-size | 301 KB Inline-JS | Echt: gleiche Ursache |
perf-dom-size | 2.184 Knoten | Echt: Footer-Liste |
a11y-svg-img-alt | 16 von 24 SVGs unbenannt | Echt, schnell behoben |
social-og-url | Kein og:url | Echt, übersehen |
social-og-url-canonical | Kein Vergleichswert | Wie oben |
content-description-pixel-width | Rund 1.005 px | Echt: Limit ~920 px |
security-csp-xss | unsafe-inline | Bekannt: Report-Only |
perf-lazy-above-fold | Lazy-Bilder oben | Gering: Mini-Logos |
Drei der zehn Fehler haben eine gemeinsame Ursache. Das HTML unserer Startseite ist 611 KB groß, und 307 KB davon sind die Payload der React Server Components, die Next.js in die Seite einbettet. Ändere, wie diese Payload ausgeliefert wird, und drei Regeln sind auf einmal erledigt. Damit hatte ich nicht gerechnet, und es landet auf unserer eigenen To-do-Liste.
og:url, das sich mit einer Zeile beheben lässt und jedes Teilen der Seite betrifft.Ein Crawl über 20 Seiten von seomator.com (--crawl -m 20 --no-cwv) kam wieder auf 91 und führte alle 29 seitenübergreifenden Regeln aus, die ein Audit einer einzelnen Seite als nicht gemessen stehen lässt. 24 davon bestanden. Langsam ist so ein Crawl allerdings: 12 Minuten für 20 Seiten, in der CI kein Problem, am Schreibtisch zäh.
Der Crawl machte aus einem Befund ein Muster. og:url fehlt auf 10 der 20 Seiten: auf der Startseite, der Preisseite, der Blog-Übersicht und unseren Tool-Seiten. Blogartikel, Teamseiten und die Kundengeschichte haben es. Die Lücke steckt also in einem gemeinsamen Metadaten-Helper und nicht in zehn Templates, und ein Audit einer einzelnen Seite hätte das nie zeigen können.
Zwei Crawl-Befunde waren für unsere Website falsch:
per_host_delay_ms in der seomator.toml oder crawle von einer freigegebenen IP aus.@id auf einer Seite als SoftwareApplication und auf einer anderen als WebApplication deklarierten. Beide Seiten deklarieren dasselbe @type-Array mit zwei Einträgen. Das ist ein Fehler in der Regel, nicht in unserem Markup.Auch die Regel für LCP-Hinweise brauchte einen zweiten Blick. Bei Blogartikeln wählte sie das 48 bis 96 px große Autorenbild in der Autorenzeile als LCP-Kandidaten, weil es das erste Bild im DOM ist. Das echte LCP-Element ist dort das Titelbild.
Das Flag --no-cwv überspringt das Rendering im Headless-Browser, und auf unserer Startseite sparte es etwa 5 Sekunden (von 39 s auf 34 s). Gleichzeitig wanderten 21 Regeln von gemessen zu „nicht gemessen“: die Core Web Vitals, die JavaScript-Prüfungen von rohem gegen gerendertes HTML, Konsolenfehler und fehlgeschlagene Requests. Der Score bewegte sich kaum, von 91 auf 90, weil Regeln, die nicht gelaufen sind, nicht zählen.
Das ist Absicht. Eine Regel, die die CLI nicht ausführen konnte, erscheint nie als bestanden; sie steht mit Begründung unter „nicht gemessen“. INP ist der deutlichste Fall. Die Metrik braucht einen echten Menschen, der die Seite benutzt, also kann kein Laborlauf sie messen. INP ist eine Feldmetrik, wie der Leitfaden von web.dev zu Interaction to Next Paint erklärt, also liest du sie aus echten Nutzerdaten wie dem Chrome UX Report. Für einen groben Wert scrollt und klickt --simulate-interaction durch die Seite und meldet einen synthetischen INP, der nicht in den Score eingeht.
seomator compare lässt dich die beiden Modi nicht verwechseln. Als ich unsere beiden Startseiten-Läufe verglichen habe, begann die Ausgabe mit einer Warnung, dass sie nicht gleich gemessen wurden („Core Web Vitals: true → false“), noch vor jedem Diff.
--no-cwv-Audit mit einem vollständigen, um die Änderung dann Regression oder Erfolg zu nennen. Wähl einen Modus pro Website und bleib dabei, am besten festgehalten in der seomator.toml.Meine Regel: --no-cwv für einen schnellen Blick, das volle Rendering für alles, worauf du handeln willst. Fünf Sekunden sind ein fairer Preis für 21 zusätzliche Messungen.
Du installierst den SEOmator-Skill einmal und sprichst Claude Code dann in ganz normalen Sätzen an. Der Skill sagt dem Agenten, welche Befehle er ausführen soll, welche Flags welche Frage beantworten und wie er die Exit-Codes liest.
npm install -g @seomator/seo-audit
npx skills add seo-skills/seo-audit-skill
Dann, in Claude Code:
Führe ein SEO-Audit für https://example.com durch
Prüfe https://mysite.com und sag mir, was ich zuerst beheben soll
Prüfe die SEO von https://example.com mit einem Crawl über 20 Seiten
/seo-audit https://staging.example.com
Der Agent führt seomator audit mit --format llm aus, liest den Bericht und schlägt Fixes in deiner Codebasis vor. Der Skill empfiehlt den Plan-Modus, damit der Agent jeden Fix darlegt, bevor er eine Datei anfasst. Danach kann er das Audit erneut ausführen und mit seomator compare zeigen, welche Regeln umgeschlagen sind.
Für das Format brauchst du den Skill nicht. Jedes Modell kann den Bericht über eine Pipe lesen:
seomator audit https://example.com --format llm --no-cwv | claude "analysiere die Befunde und priorisiere die Fixes"
Das Format llm ist kompaktes XML, geschrieben für das Kontextfenster eines Modells. Auf unserer Startseite war der LLM-Bericht 40,6 KB groß, der JSON-Bericht desselben Laufs 190,7 KB, also ist der LLM-Bericht 79 % kleiner. Der Markdown-Bericht kam auf 26,1 KB, der HTML-Bericht auf 411,9 KB.
Das Format geht außerdem davon aus, dass die geprüfte Seite den Agenten angreifen könnte, der den Bericht liest. Jeder Text, den die CLI von der Website übernimmt, etwa ein Title oder eine Fehlermeldung, landet in einem Tag, dessen Name eine zufällige, für diesen Lauf erzeugte Nonce enthält. Ein Hinweis oben im Bericht weist das Modell an, diese Blöcke als Daten zu behandeln, niemals als Anweisungen. Der Bericht unserer Startseite enthielt 98 solcher Blöcke.
Versteckte Anweisungen in einer Webseite sind ein echter Angriff: Prompt Injection steht auf Platz eins der OWASP-Liste der LLM-Risiken. Ein SEO-Audit liest den ganzen Tag Seiten, denen niemand trauen sollte, also braucht es diese Mauer.
Anhand der Exit-Codes der SEOmator-CLI kann eine Pipeline eine schlechte Seite von einem kaputten Lauf unterscheiden. Füg einen Audit-Schritt hinzu, und der Build schlägt fehl, sobald der Score unter 70 fällt.
| Exit-Code | Bedeutung |
|---|---|
| 0 | Erfolg: Der Score liegt bei 70 oder höher |
| 1 | Das Audit lief und ergab weniger als 70, oder compare --fail-on-regression fand eine Regression |
| 2 | Der Befehl schlug fehl: URL nicht erreichbar, HTTP-Fehler, ungültige Konfiguration |
| 130 | Mit Strg+C abgebrochen |
Code 1 heißt, dass das Tool funktioniert hat und die Website benotet. Behandle ihn als schlechte Note, nicht als Absturz. Nur Code 2 bedeutet, dass das Audit nicht laufen konnte. Mit --format json oder --format llm gibt ein Code 2 zusätzlich einen strukturierten Fehler mit einem stabilen Feld code aus, nach dem ein Skript verzweigen kann.
name: SEO Audit
on:
  pull_request:
    branches: [main]

jobs:
  audit:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-node@v4
        with:
          node-version: '22'
      - run: npm install -g @seomator/seo-audit
      - run: npx playwright install chromium
      - run: seomator audit https://your-staging-url.com --format json -o seo-report.json
      - uses: actions/upload-artifact@v4
        if: always()
        with:
          name: seo-report
          path: seo-report.json
Das stärkere Gate vergleicht zwei Läufe. Prüf vor und nach einem Deploy und führ dann seomator compare example.com --fail-on-regression aus. Der Befehl endet mit 1, wenn der Score gefallen ist oder neue Fehler aufgetaucht sind. Er vergleicht nach Regel-ID: Eine Regel, die kaputtging, und eine andere, die repariert wurde, erscheinen als zwei Zeilen, statt sich gegenseitig aufzuheben. Unser Leitfaden zum SEO-Audit zeigt, was du mit den Befunden machst, wenn das Gate anschlägt.
Nimm die SEOmator-CLI, wenn du im Terminal oder mit einem KI-Agenten arbeitest, das kostenlose Audit-Tool, wenn nicht, und die SEOmator-Plattform, wenn die ganze Website nach Zeitplan für dich geprüft werden soll. Lighthouse steht neben allen dreien als bester Performance-Profiler für einzelne Seiten.
Lighthouse prüft pro Lauf eine Seite, in Gruppen für Performance, Barrierefreiheit, Best Practices, SEO und seit Kurzem Agentic Browsing, das eine llms.txt-Prüfung enthält. Seine SEO-Gruppe deckt die Grundlagen ab. Die CLI misst ebenfalls Core Web Vitals und ergänzt Crawlbarkeit, strukturierte Daten, Weiterleitungen, Hreflang, Sicherheits-Header, E-E-A-T-Signale und den Zugang für KI-Crawler, und das über einen ganzen Crawl.
| Lighthouse | SEOmator-CLI | Kostenloses Audit-Tool | |
|---|---|---|---|
| Läuft in | DevTools, CLI, PSI | Terminal, CI, Agent | Browser |
| Seiten pro Lauf | 1 | 1 oder ein Crawl | 1 |
| Prüfungen | 5 Audit-Gruppen | 365 Regeln | 172 Prüfungen |
| llms.txt-Prüfung | Ja | Ja | Ja |
| Zwei Läufe vergleichen | Nein | Ja | Nein |
| Berichte | HTML, JSON | 5 Formate | Web, PDF |
| Kosten | Kostenlos | Kostenlos, MIT | Kostenlos |
Ich nutze Lighthouse und die CLI nebeneinander. Die Trace-Ansicht von Lighthouse ist immer noch meine erste Anlaufstelle, wenn eine Seite langsam ist. Die CLI ist das, was ich in Skripte packe, weil sie die Crawl-, Strukturdaten- und KI-Crawler-Prüfungen abdeckt, die Lighthouse fehlen, und sich an den letzten Lauf erinnert.
Wenn du als SEO lieber kein Terminal öffnest, fang mit unserem kostenlosen SEO-Audit-Tool an: Es führt 172 Prüfungen im Browser aus und exportiert einen PDF-Bericht. Wenn du mehr als eine Seite auf einmal brauchst, crawlt die SEOmator-Plattform die ganze Website nach Zeitplan, speichert jedes Audit und ordnet Fixes nach den Seiten, die in deiner Search Console Klicks bringen. Wenn du eine B2B-SaaS-Website betreibst, buch eine 30-minütige Demo, und ich schaue mir deine Website an, bevor wir sprechen. Agenturen mit vielen Kunden-Websites sollten auch unseren Leitfaden zu SEO-Audit-Tools für Agenturen lesen.
Die SEOmator-CLI ist ein Labor-Tool und hat die Grenzen eines Labor-Tools. Hier wäre ich vorsichtig.
--crawl stoppt bei 10 Seiten, wenn du -m nicht erhöhst. Seitenweite Probleme brauchen einen Crawl, und ein Crawl braucht Zeit.Für eine Website, auf der du nichts installieren kannst, oder für eine ganze Website, gecrawlt so, wie Googlebot sie sieht, nimm stattdessen den gehosteten SEO-Crawler.
Ja. @seomator/seo-audit steht unter MIT-Lizenz, du kannst es also kostenlos installieren, in der CI ausführen, verändern und kommerziell nutzen. Es gibt kein Konto, keinen API-Schlüssel und kein Nutzungslimit. Die SEOmator-Plattform kostet Geld, aber die CLI hängt nicht von ihr ab.
Nein. Nimm stattdessen das kostenlose SEO-Audit-Tool auf seomator.com: Du fügst eine URL ein, es führt 172 Prüfungen in deinem Browser aus und exportiert ein PDF, das du an die Person schicken kannst, die deine Website baut. Die CLI lohnt sich, wenn du Audits in Skripten, in der CI oder in einem KI-Agenten willst.
Die CLI ruft die Website ab, die du prüfst, und speichert die Ergebnisse lokal in ~/.seomator/audits.db. Laut Projektdokumentation bindet sich seomator serve nur an Loopback und stellt keine ausgehenden Anfragen. Ich habe das veröffentlichte 5.1.0-Bundle durchsucht: Die einzigen Analytics-Namen darin, Google Analytics und Mixpanel, sind Muster, mit denen die Regeln Tracker auf der geprüften Seite erkennen.
Nein. Der LLM-Bericht enthält das Audit und sonst nichts. In unserem Startseiten-Bericht war jede Erwähnung von seomator.com die geprüfte URL selbst, und es gab weder einen Werbe-Footer noch eine zusätzliche Anweisung.
Der Skill wird mit npx skills add seo-skills/seo-audit-skill installiert und funktioniert in Claude Code und in anderen Agenten, die dasselbe Skill-Format lesen, etwa Cursor. Jeder Agent, der einen Shell-Befehl ausführen kann, kann seomator audit --format llm auch ohne den Skill aufrufen.
Für Core Web Vitals und die Regeln zum JavaScript-Rendering ja. Die CLI nutzt das Chrome, Chromium oder Edge, das du schon hast, und seomator self doctor sagt dir, welchen Browser sie gefunden hat. Ohne Browser startest du mit --no-cwv; die Regeln, die einen Browser brauchen, melden dann „nicht gemessen“.
So viele, wie du mit --max-pages festlegst; der Standard ist 10. Die Parallelität liegt standardmäßig bei 3 Anfragen, und der Crawler wartet standardmäßig zwischen den Anfragen und respektiert die robots.txt, sodass auch ein großer Crawl den Server schont.
Die README folgt dem main-Branch, der acht Regeln enthält, die noch nicht im veröffentlichten 5.1.0-Paket sind. npm install liefert dir bis zum nächsten Release 365. seomator --help gibt immer die Zahl für die installierte Version aus.
Ja. Trag sie in der seomator.toml unter [rules] disable ein, auch mit Wildcards wie legal-*, oder prüf nur einige Kategorien mit -c core,security,perf. Abgeschaltete Regeln zählen nicht mehr zum Score.
Die CLI ist unsere Audit-Engine als kostenloses, eigenständiges Tool. Die Plattform führt Audits über die ganze Website nach Zeitplan aus und ergänzt Rank-Tracking und KI-Sichtbarkeits-Tracking, einen Team-Verlauf und einen Agenten, der freigegebene Aufgaben erledigt. Entwickler können mit der CLI starten und nicht-technische SEOs mit dem kostenlosen Audit-Tool; wenn du die ganze Website über die Zeit verfolgen willst, ist das die Plattform.
Wer ihn geschrieben hat, was sich geändert hat und wie Sie uns einen Fehler melden.
Emre Elbeyoglu
Gründer & CEO, SEOmator
Über 16 Jahre in B2B-SaaS-SEO und Growth; über 10 Mio. $ Umsatz aus organischer Suche
Emre Elbeyoglu ist Gründer und CEO von SEOmator. Neben der Unternehmensleitung verantwortet Emre als Head of Growth die gesamte Growth-Arbeit von SEOmator. Zudem ist Emre Gründer und Director der Next Marketing Technology Ltd, des Londoner Unternehmens, das SEOmator seit 2023 besitzt und betreibt. Emre arbeitet seit mehr als 16 Jahren in SEO und Growth Marketing für B2B-SaaS und baut jeden Akquisitionskanal über die Suche auf: Mit diesem Ansatz hat er mit seinen Produkten über die organische Suche insgesamt mehr als 10 Mio. US-Dollar Umsatz erzielt, mehr als 300.000 organische Besucher pro Monat erreicht und über 10.000 verweisende Backlinks gewonnen.
2013 war Emre Mitgründer von Flatart, einer Digitalmarketing-Agentur, die SEO- und Growth-Programme für Marken wie Investing.com, Rakuten und EuroDNS umsetzte. Aus dieser Beratungsarbeit entstanden Produkte: Popupsmart, eine KI-gestützte Plattform zur Conversion-Optimierung mit mehr als 600 Kunden, und LiveChatAI, ein KI-Tool für den Kundensupport, über das WIRED berichtet hat. Außerdem veröffentlicht Emre Growth-Marketing-Experimente auf GrowthMarketing.ai.
Veröffentlicht
Haben Sie einen Fehler oder eine veraltete Zahl entdeckt? Sagen Sie es uns. Wir korrigieren ihn und vermerken die Änderung oben im Verlauf. Fehler melden →
SEOmator-Tarife vergleichen
Sie vergleichen ohnehin schon Tools. Hier ist unseres — mit öffentlichen Preisen und dem, was jeder Tarif wirklich enthält.
SEOmator-Tarife vergleichen· 17 Min. Lesezeit
Google Search Console in zwei Minuten mit Claude oder Codex verbinden: SEOmators kostenloses GSC MCP. Ein Befehl, Browser-Anmeldung, kein Google-Cloud-Projekt.
· 13 Min. Lesezeit
Sieben von neun SEO-Audit-Plattformen bieten White-Label-Reporting — aber fast nie in dem Tarif, den die Vergleichslisten nennen. Wir haben am 13. September 2026 die veröffentlichten Preisseiten aller Anbieter geprüft: Die Freischaltung kostet zwischen rund 50 $ und über 1.000 € pro Monat, und zwei populäre „White-Label"-Tools bieten die Funktion überhaupt nicht.
· 27 Min. Lesezeit
Als erfahrener SEO-Experte habe ich eine Vielzahl von SEO-Tools ausprobiert und getestet. Unter den zahlreichen SEO-Tools, mit denen ich arbeiten durfte, war Mangools stets ein bekannter Name.


